什么是常见数据结构
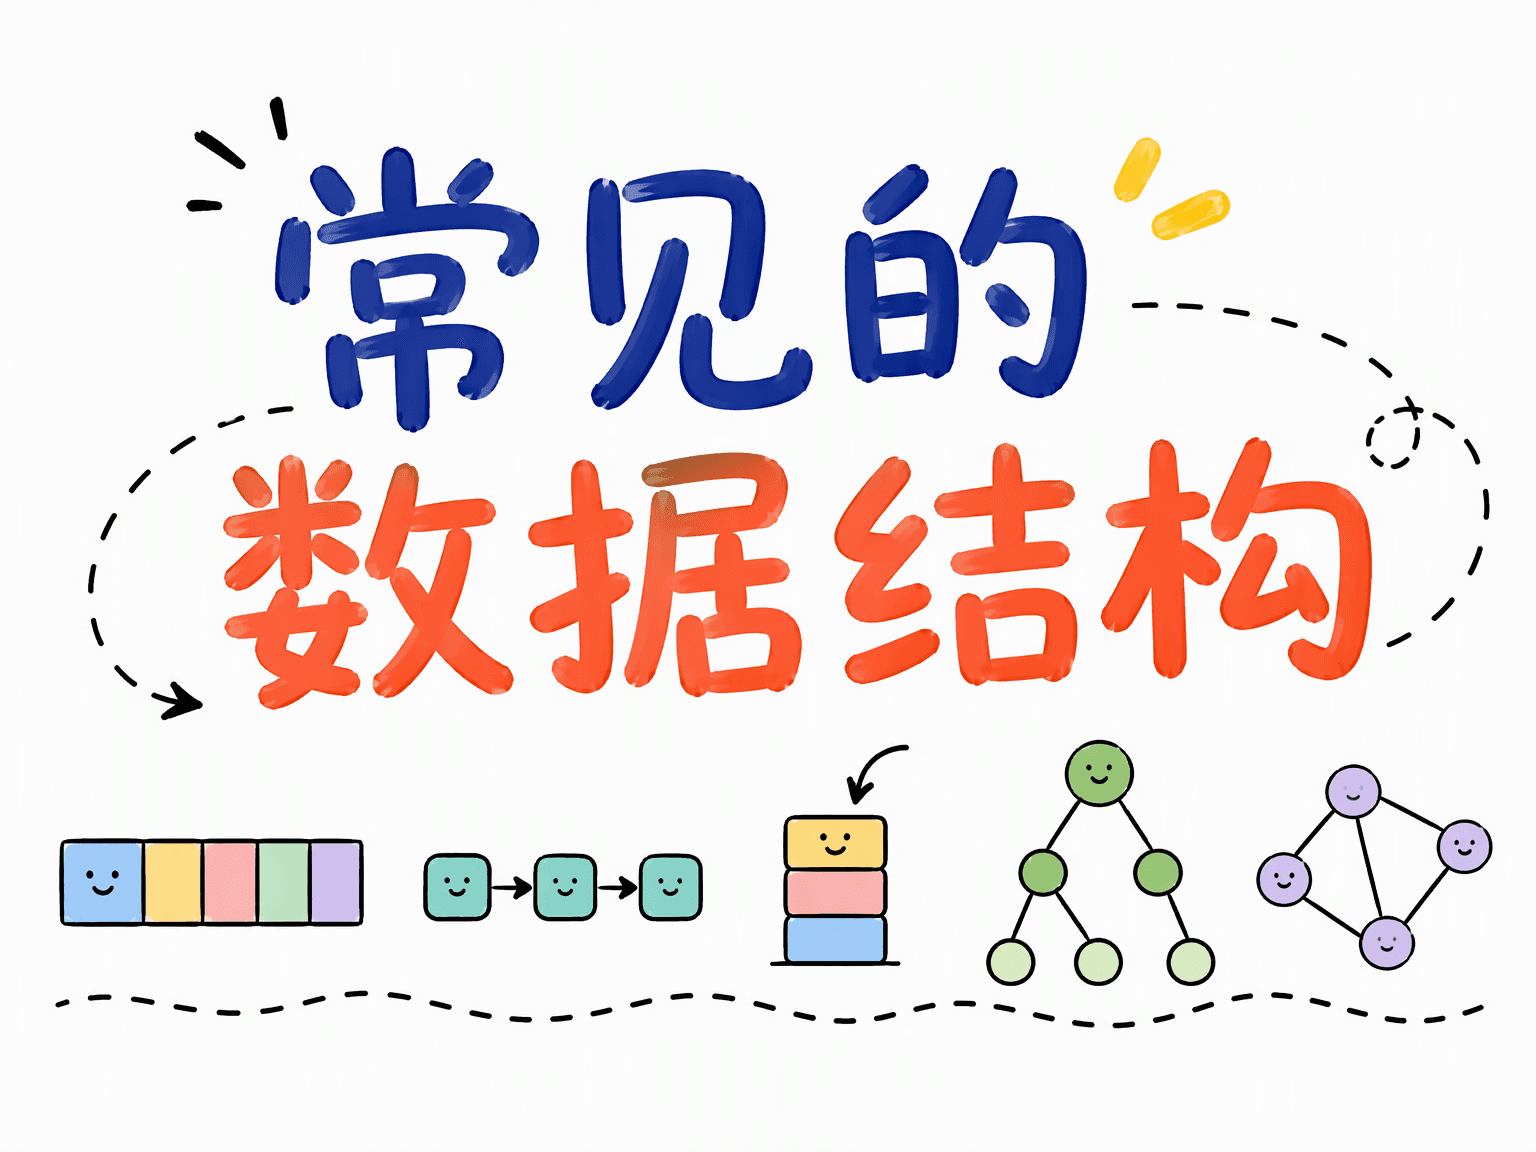
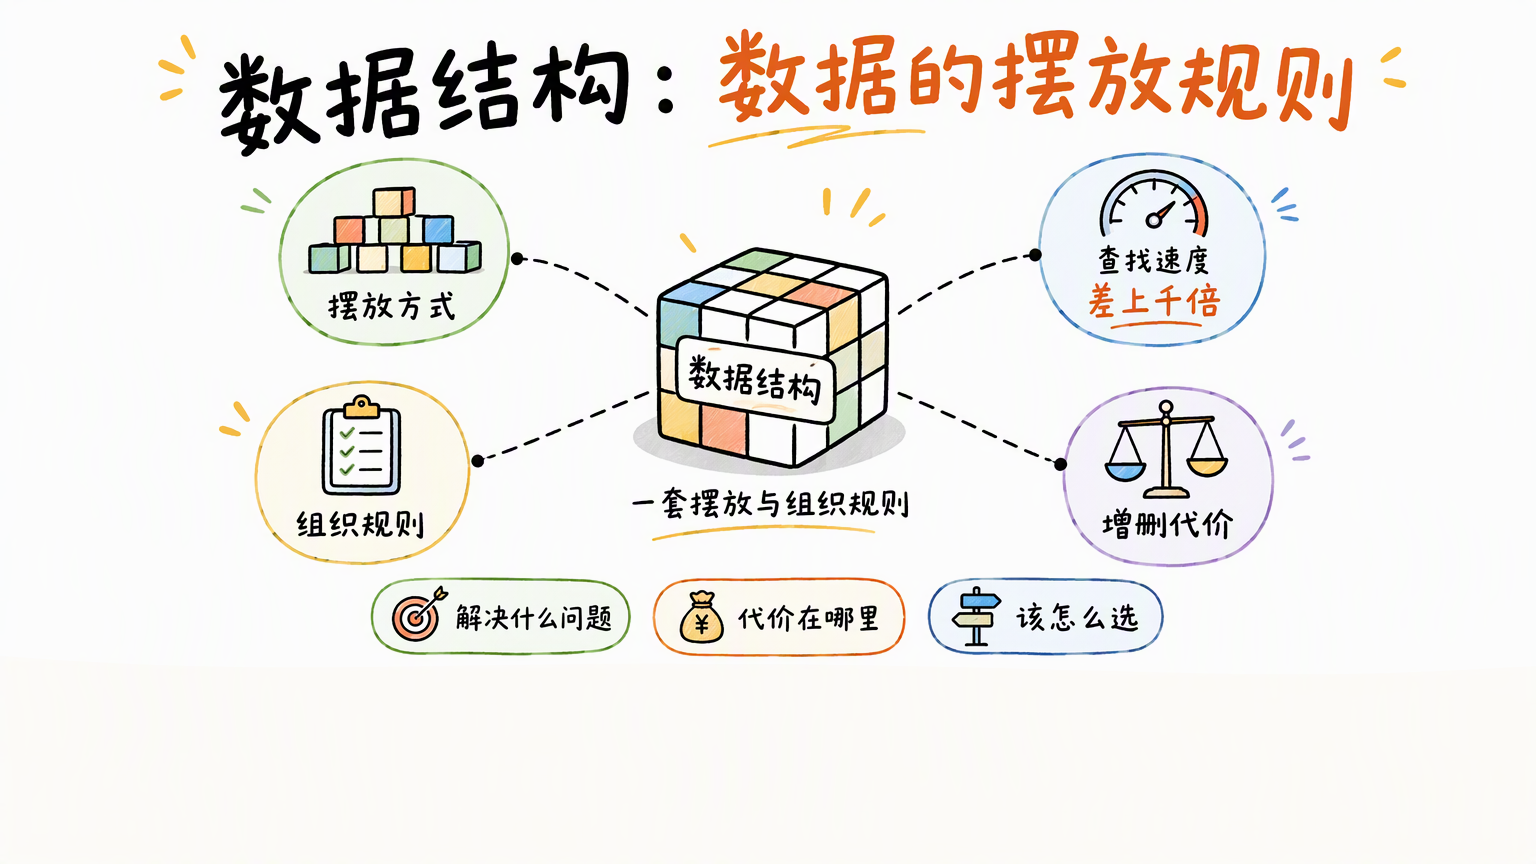
常见数据结构,简单说就是数据在计算机里怎么摆放、怎么组织的一套规则。
同一批数据,摆法不同,查找速度、插入删除的代价可能差上千倍。所以理解数据结构的重点不是记住某个实现,而是知道每种摆法解决了什么问题、付出了什么代价,以及在实际写代码做系统时该怎么选。
一把衡量尺子:三类操作与大 O
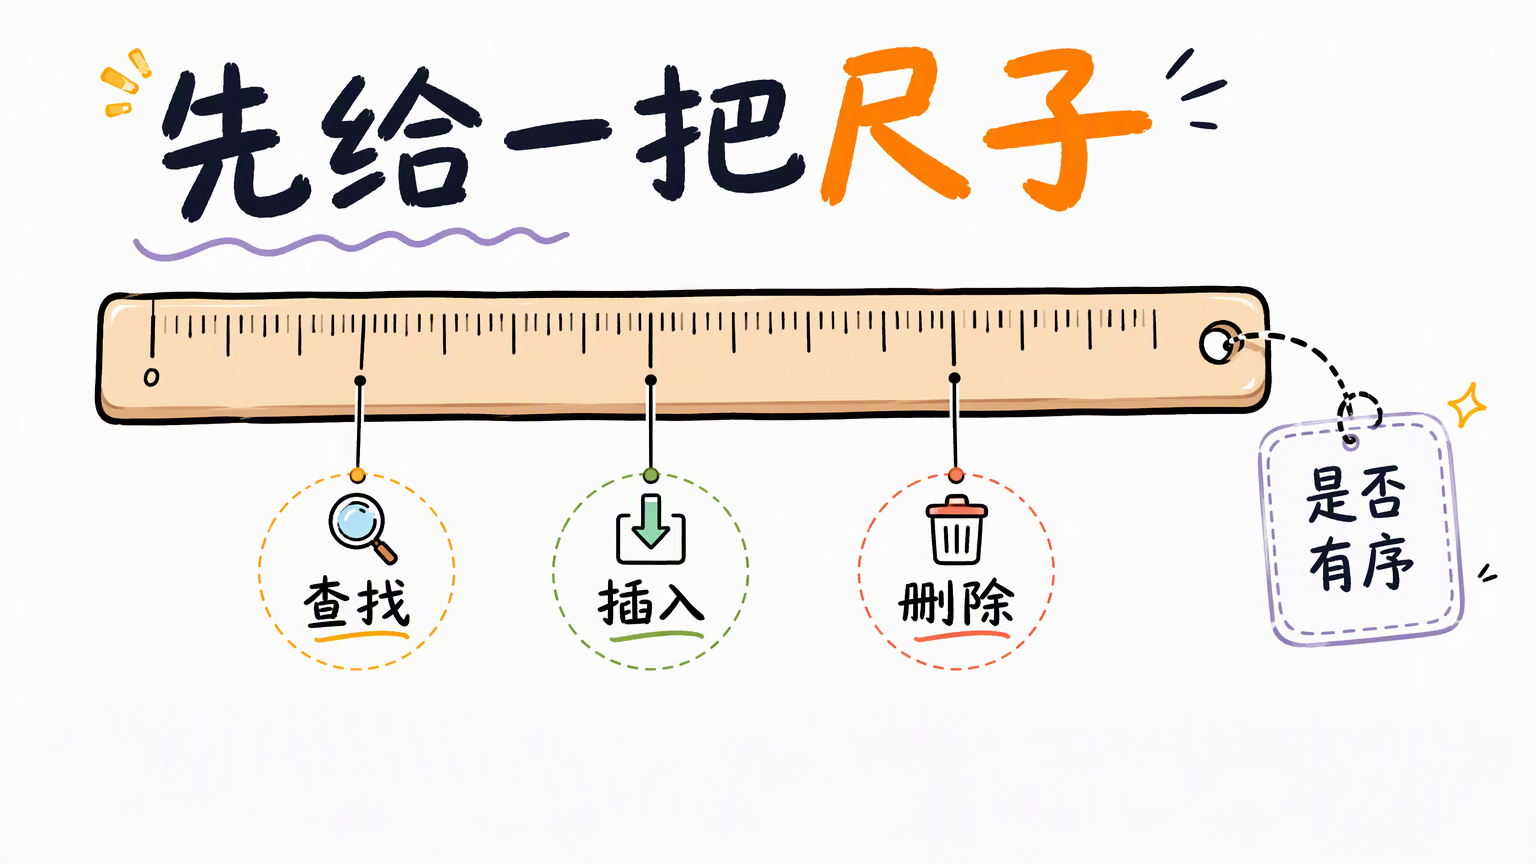
衡量一个结构好不好用,主要看三类操作的成本:查找、插入、删除。再补一个附加需求:数据要不要保持有序。
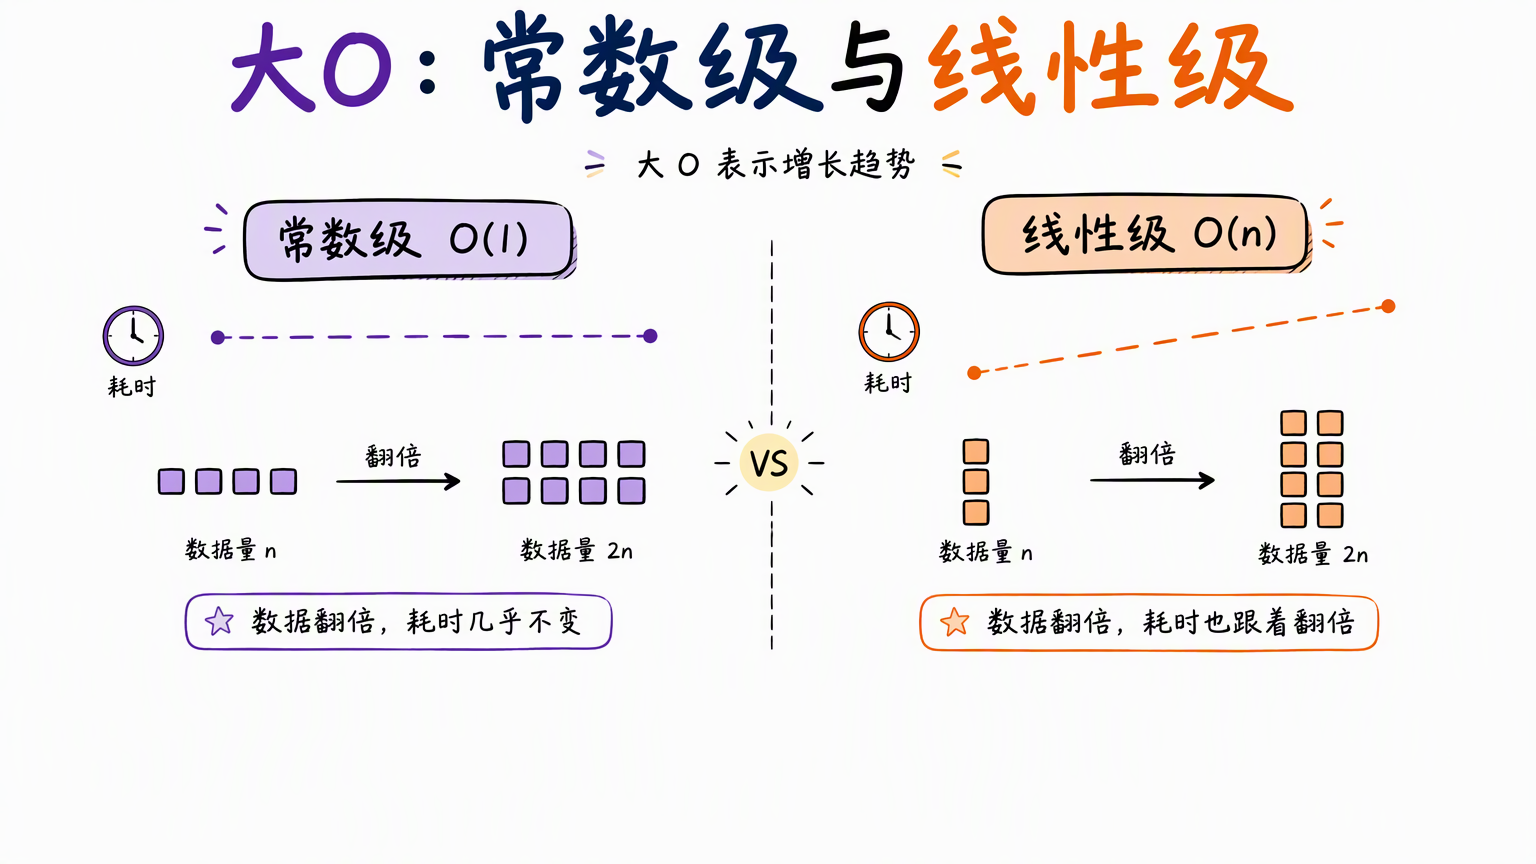
计算机里用大 O 表示这个成本随数据量增长的变化趋势:
- 常数级:数据翻倍,耗时几乎不变。
- 线性级:数据翻倍,耗时也跟着翻倍。
所以比较数据结构,比的从来不是单次操作快不快,而是数据量涨上去之后还撑不撑得住。
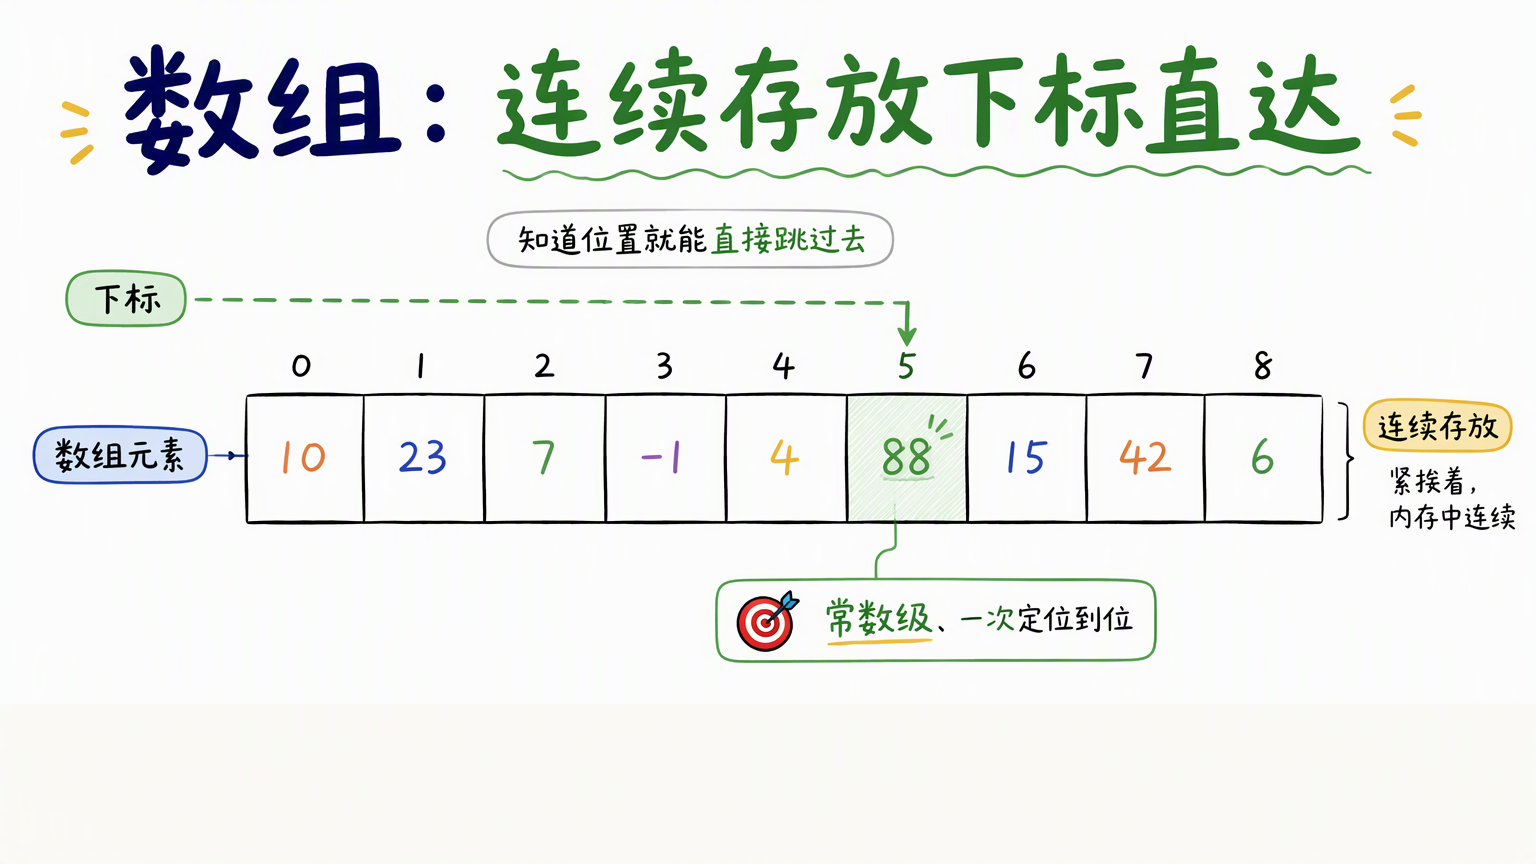
数组:连续存放,按下标直达
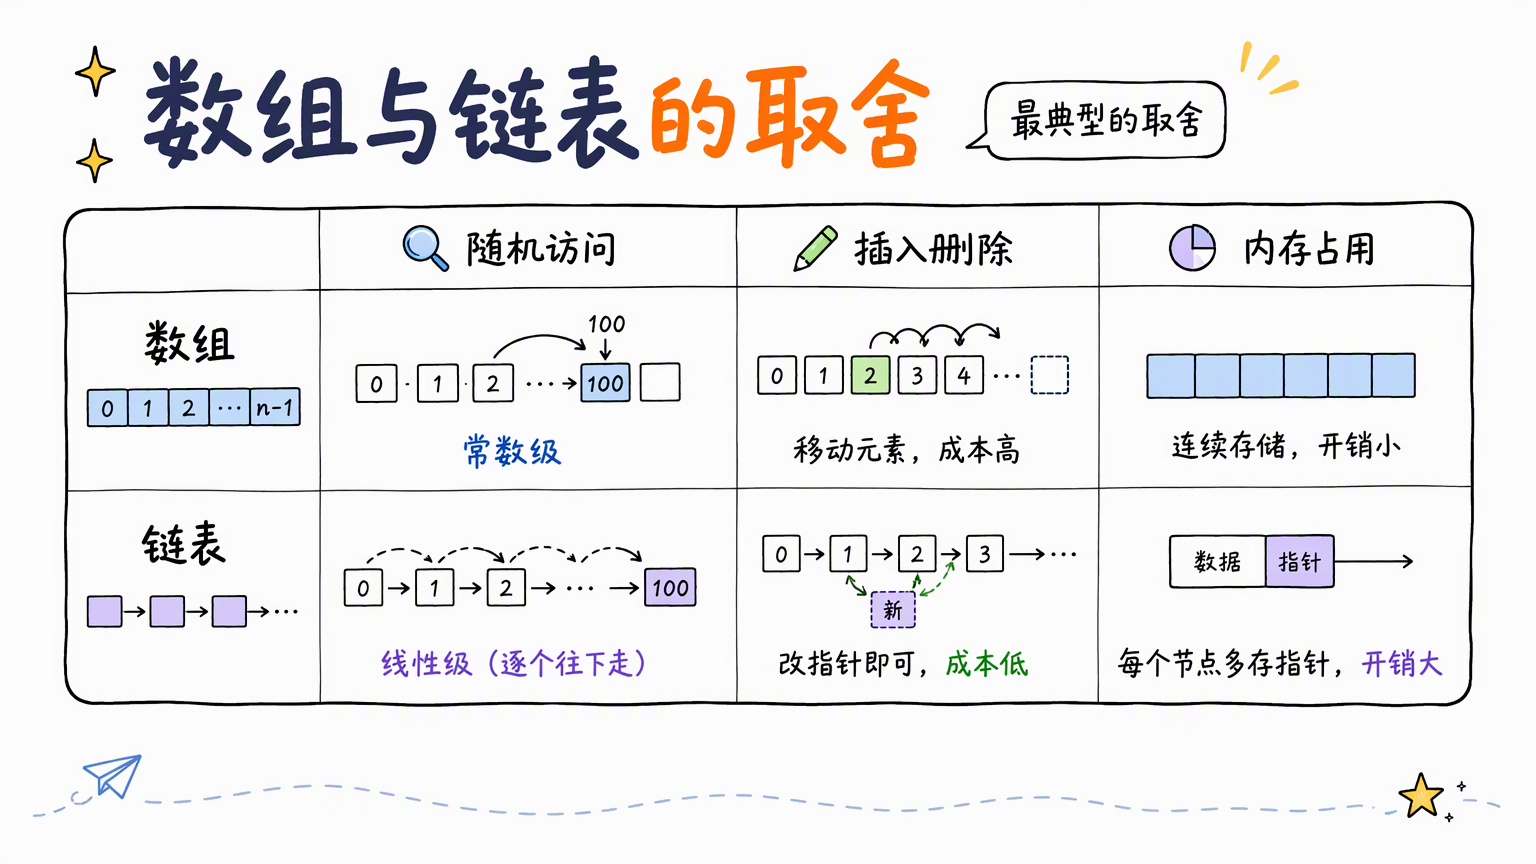
数组把元素排成一排,连续放在内存里,每个元素有个编号,也就是下标。知道位置就能直接跳过去,读取是常数级,一次定位到位。
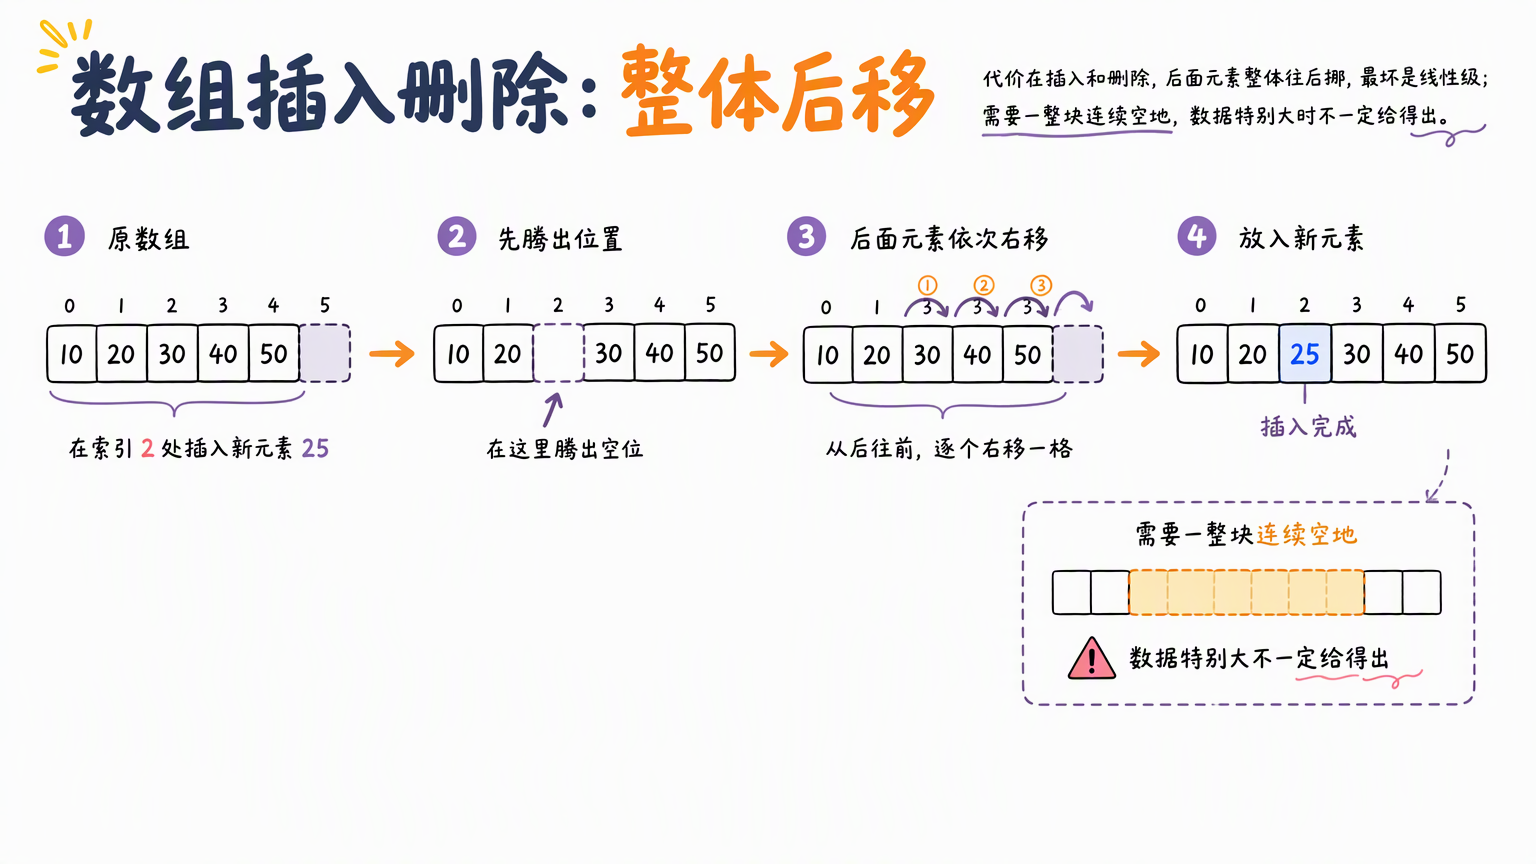
代价在插入和删除:中间要腾一个位置,后面的元素都得整体往后挪,最坏是线性级。
连续存放还有个副作用:内存里必须找得到一整块足够大的空地,数据特别大时不一定给得出。
链表:改指针代替搬元素
链表不要求连续存放,每个节点除了存数据,还存一个指向下一个节点的指针。
它的长项是插入和删除:只要改几根指针,不用搬动其他元素。
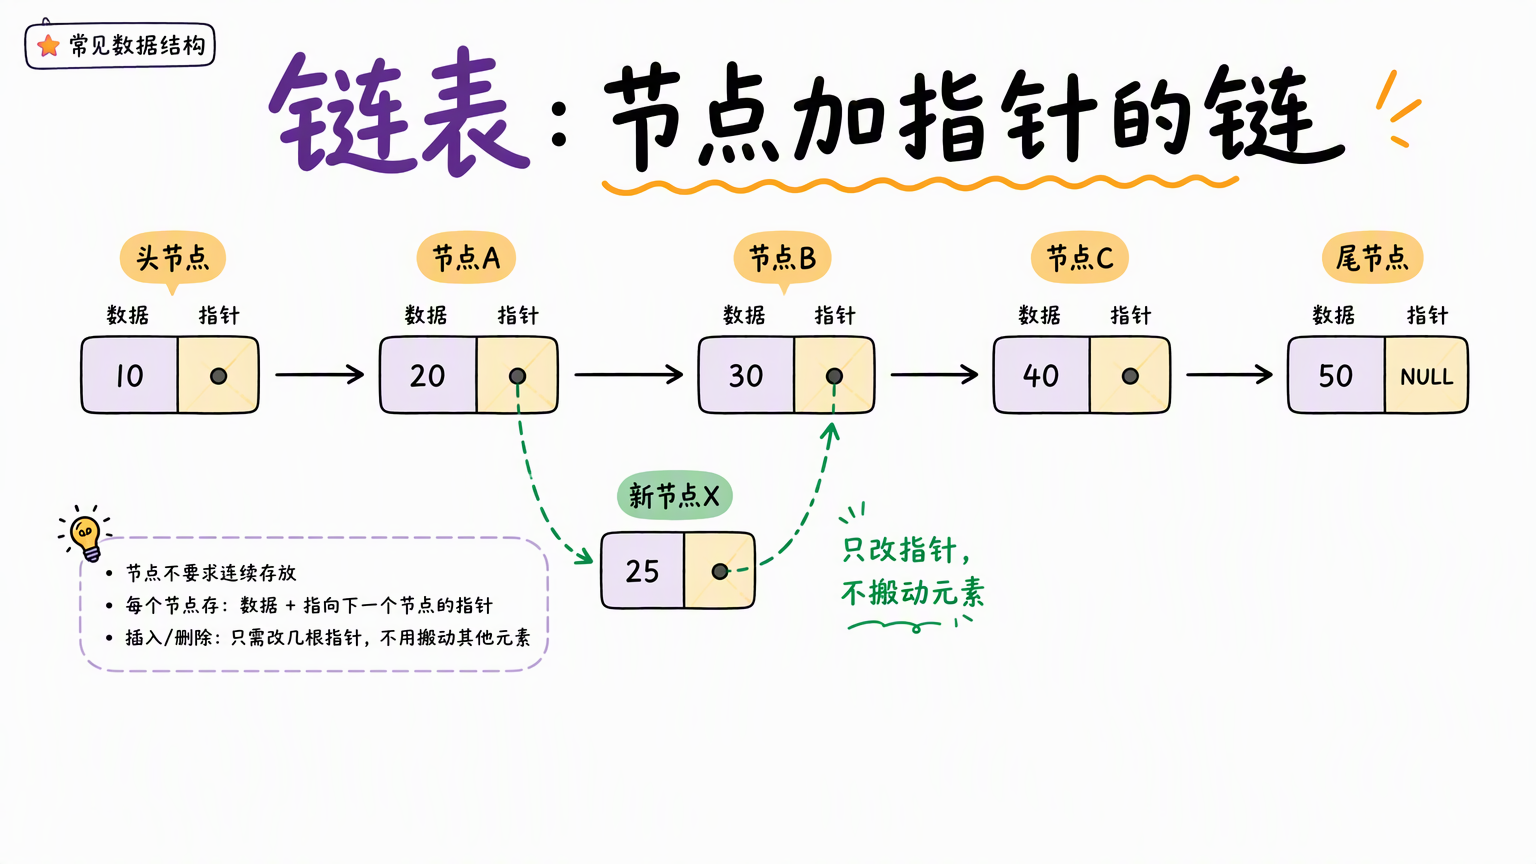
代价在访问:想找第一百个元素,只能从头一个个往下走,随机访问退化成了线性级。此外每个节点都要额外存指针,同样的数据它占的内存更多。
这是最典型的取舍——数组擅长按下标直达,链表擅长频繁增删。
栈与队列:只管进出的顺序
- 栈只允许在一端进出,后进先出,像叠盘子,最后放上去的最先被拿走。常用于函数调用和撤销操作。
- 队列是先进先出,像排队买票,先来的先被服务。打印机接收任务就是按到达顺序排队处理。常用于任务排队和消息缓冲。
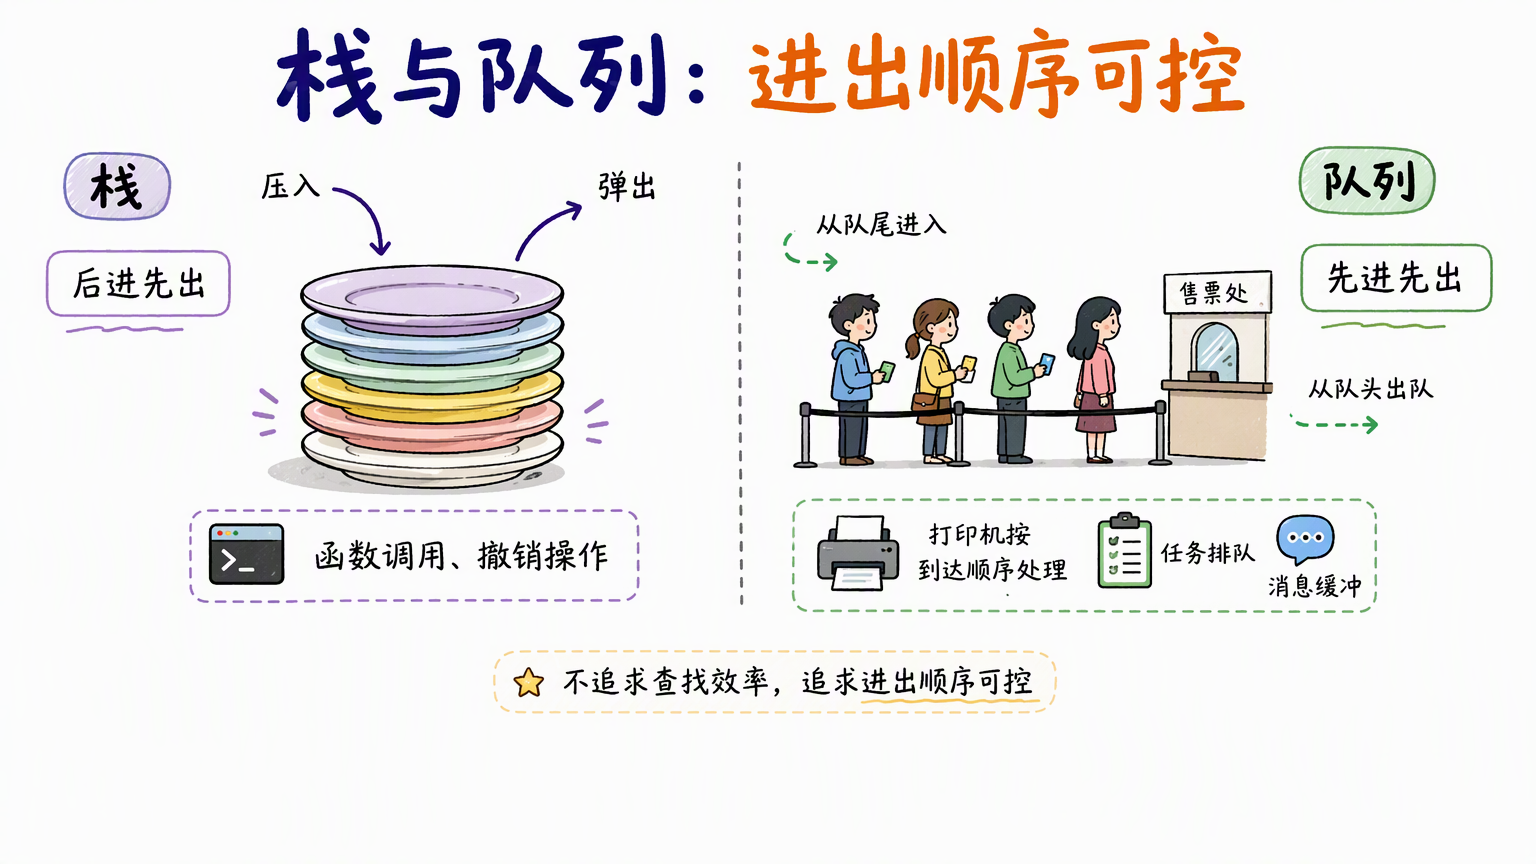
它们不追求查找效率,追求的是进出顺序可控。
哈希表:用哈希函数把键换算成下标
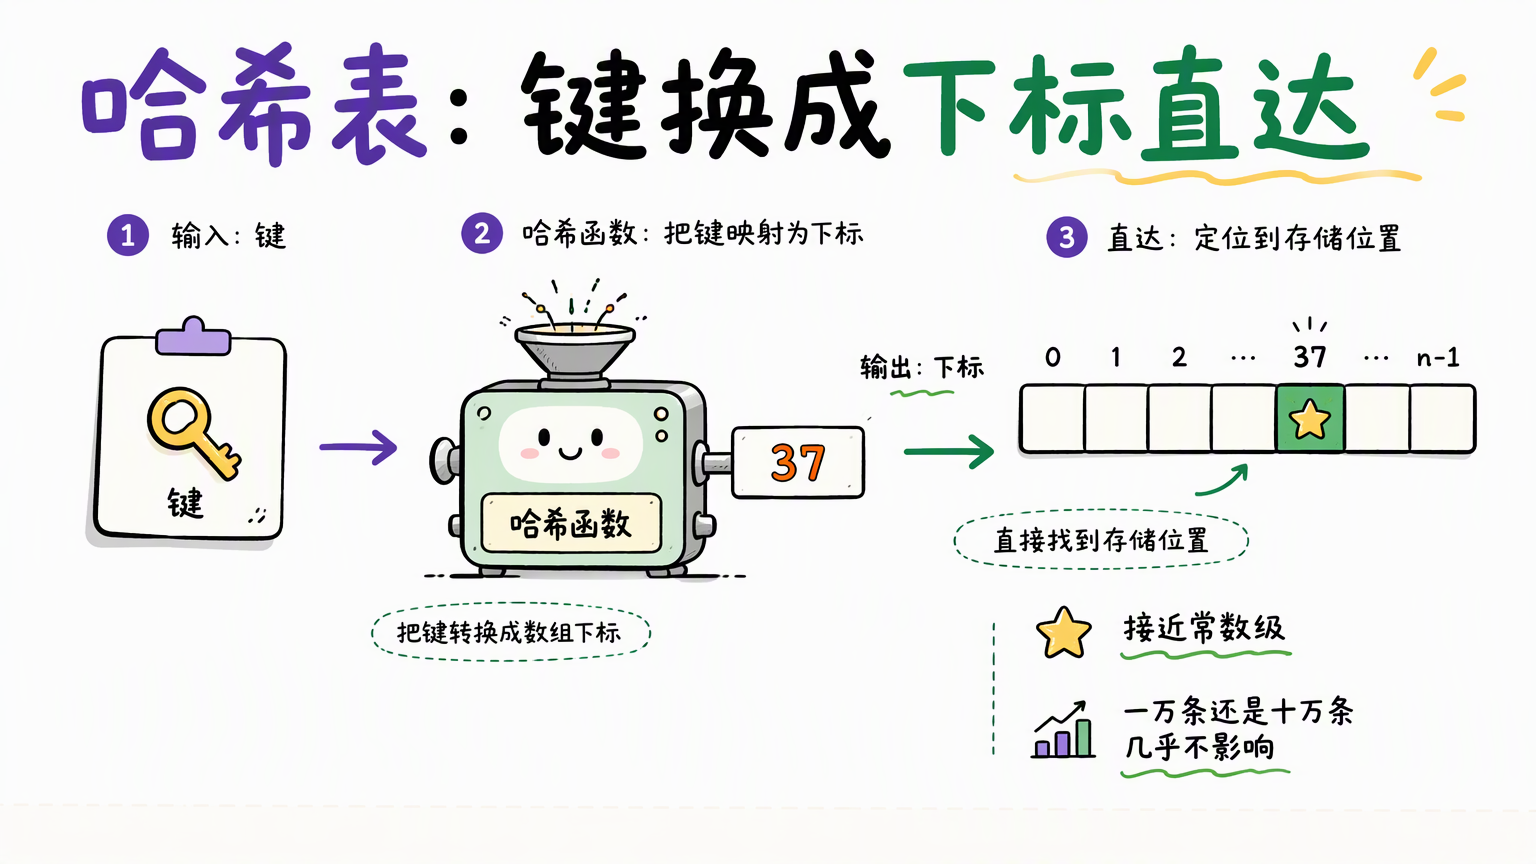
哈希表用哈希函数把键换算成数组下标,直接定位到存储位置。理想情况下查找成本接近常数级,表里有一万条还是十万条几乎不影响速度。
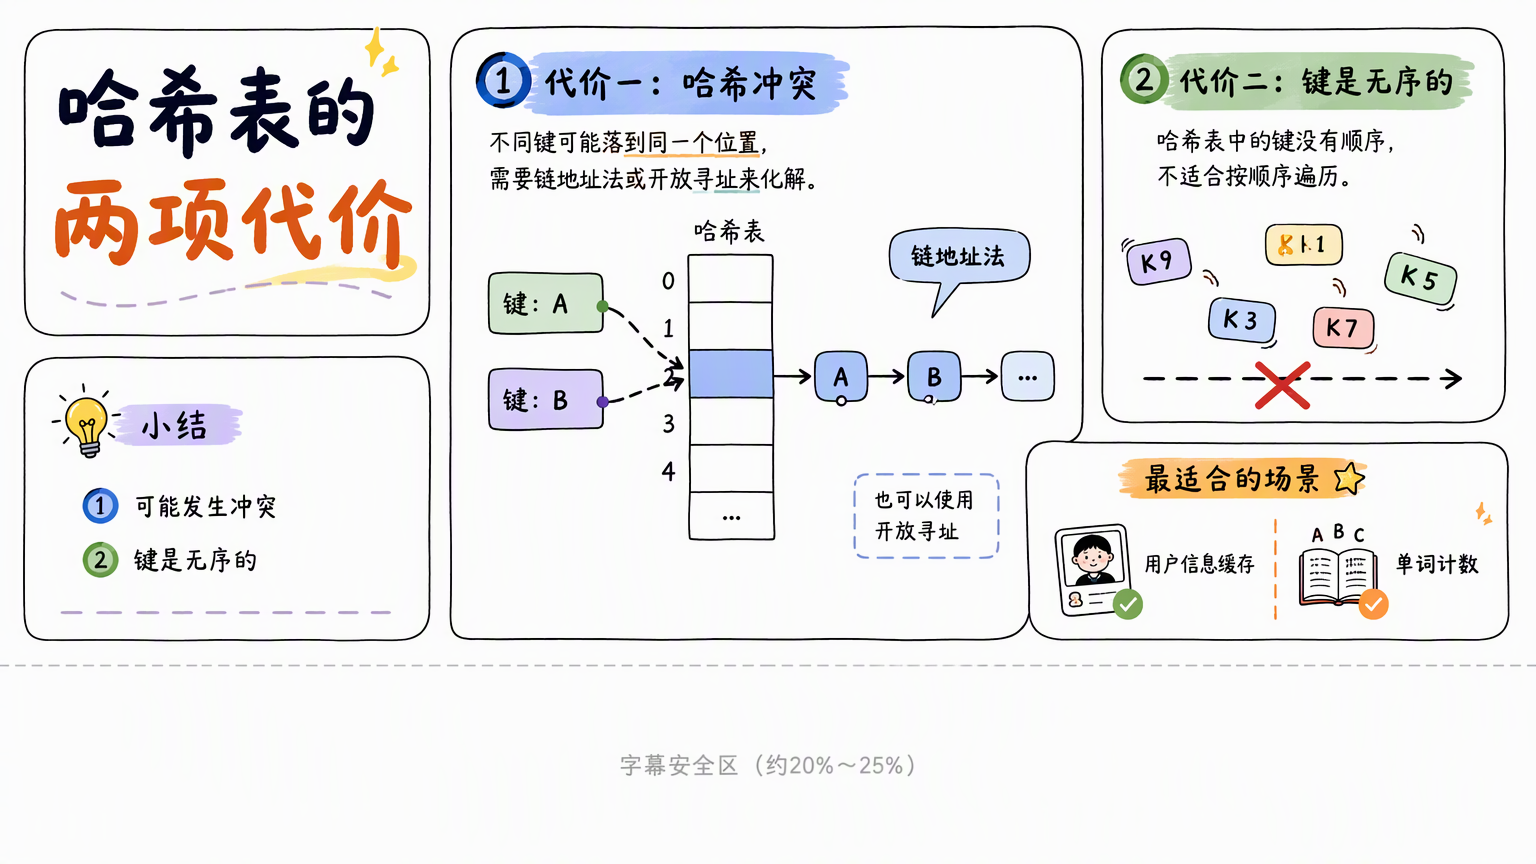
代价有两个:
- 哈希冲突。不同键可能算出同一个位置,得靠链地址法或者开放寻址来化解。
- 键是无序的。想按顺序遍历就不合适。
因此哈希表最适合按某个键快速取到值的场景,比如用户信息缓存、单词计数。
树:处理层级与有序
二叉树每个节点最多两个子节点。二叉搜索树再规定左小右大,每次比较就能排除一半范围,平均是对数级。
但普通二叉搜索树可能退化成一条链,于是有了红黑树这类平衡树,靠旋转维持高度平衡。
堆也是树的一种,专门用来快速取最大或最小值,优先队列底层就是它。
文件系统的目录结构、公司的组织架构,本质上都是树。
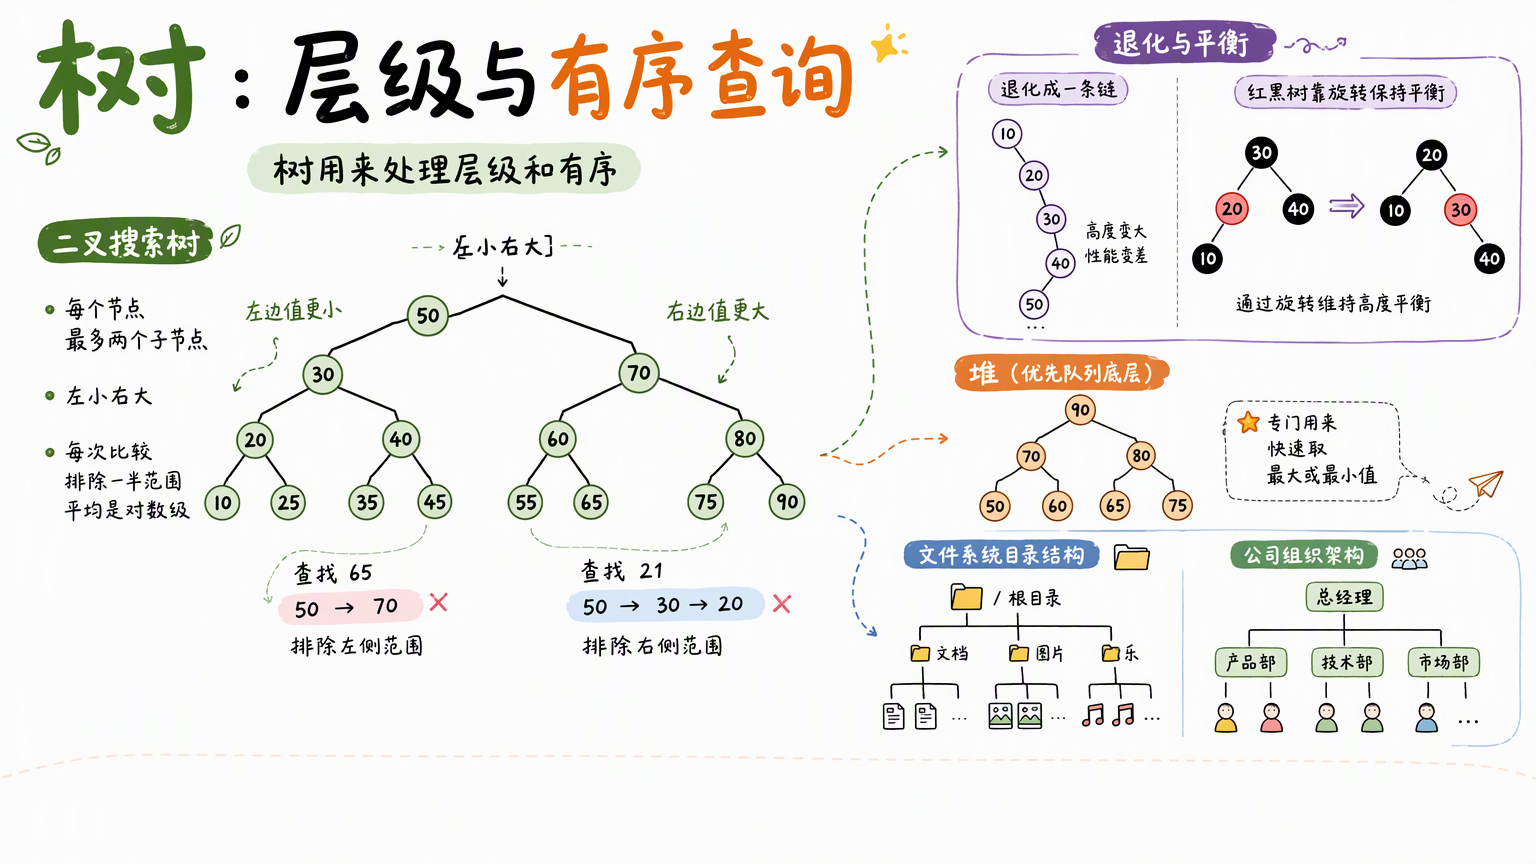
图:表达多对多关系
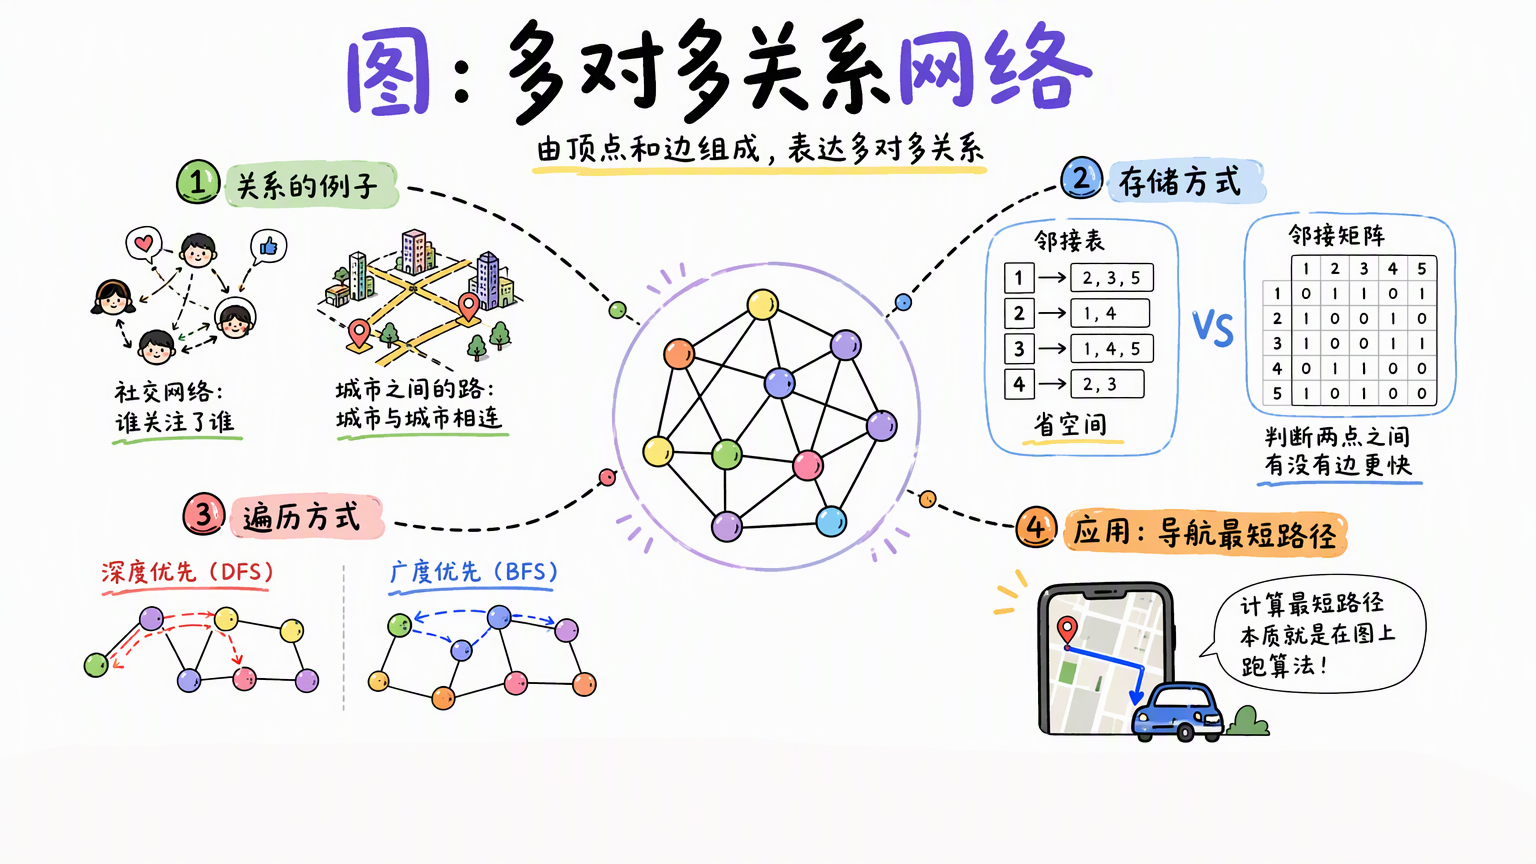
图由顶点和边组成,表达的是多对多关系,比如社交网络里谁关注了谁,地图上城市和城市之间的路怎么连。
存储时常在两种方式之间选:
- 邻接表:省空间。
- 邻接矩阵:判断两点之间有没有边更快。
图没有天然的顺序,通常用深度优先或者广度优先去遍历。导航软件算最短路径,本质就是在图上跑算法。
放在一起看:没有绝对优劣,只有适配
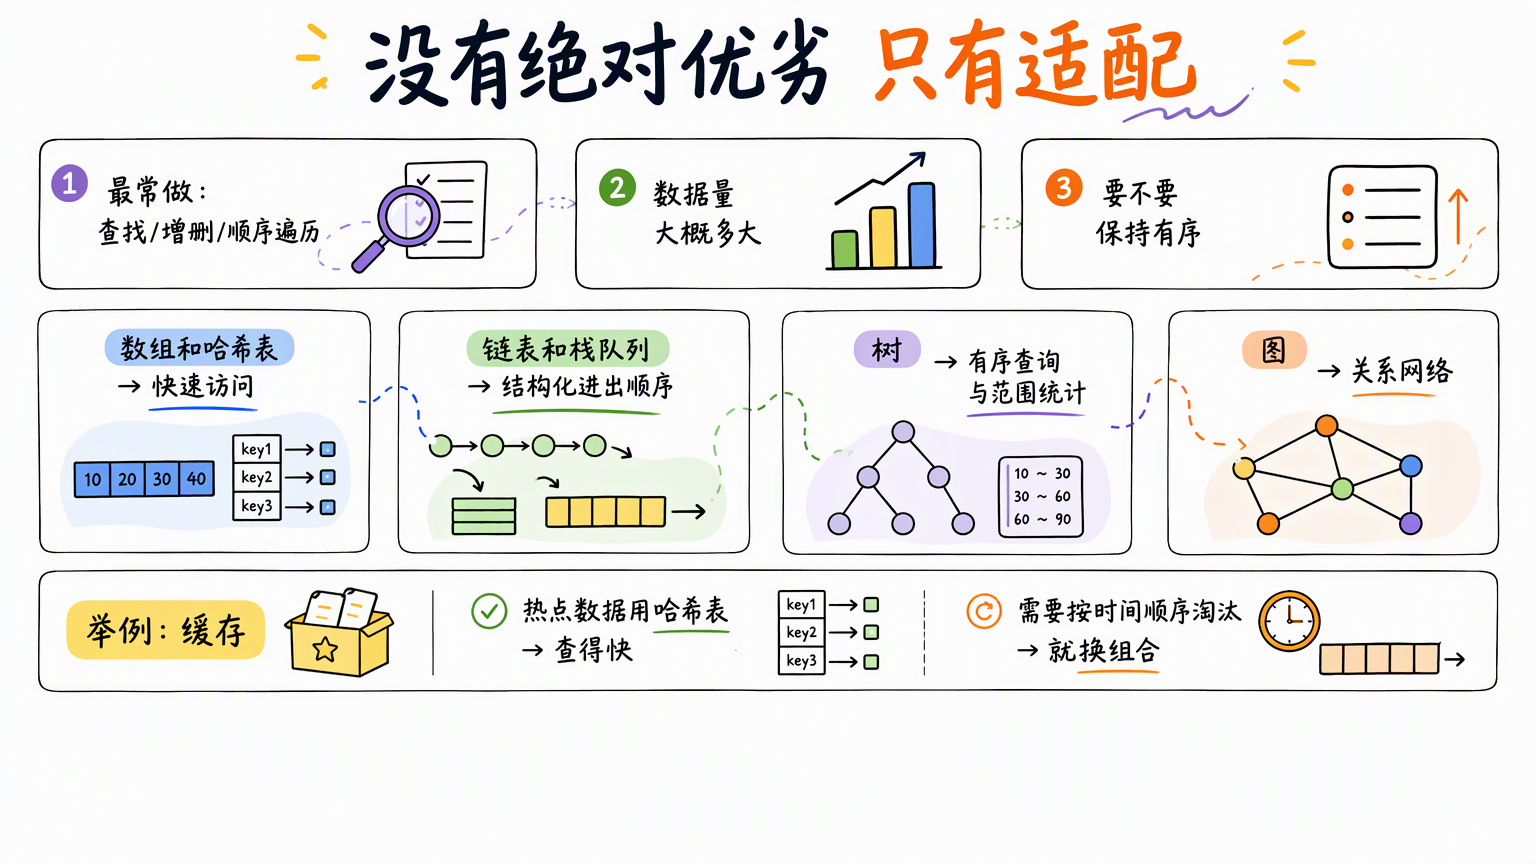
判断标准就三条:
- 最常做的是查找、增删还是顺序遍历。
- 数据量大概多大。
- 要不要保持有序。
按分工来看:数组和哈希表负责快速访问,链表和栈队列负责结构化的进出顺序,树负责有序查询和范围统计,图负责关系网络。
同样拿缓存举例,热点数据用哈希表查得快;如果需要按时间顺序淘汰,就得换成别的组合。
限制与现实条件
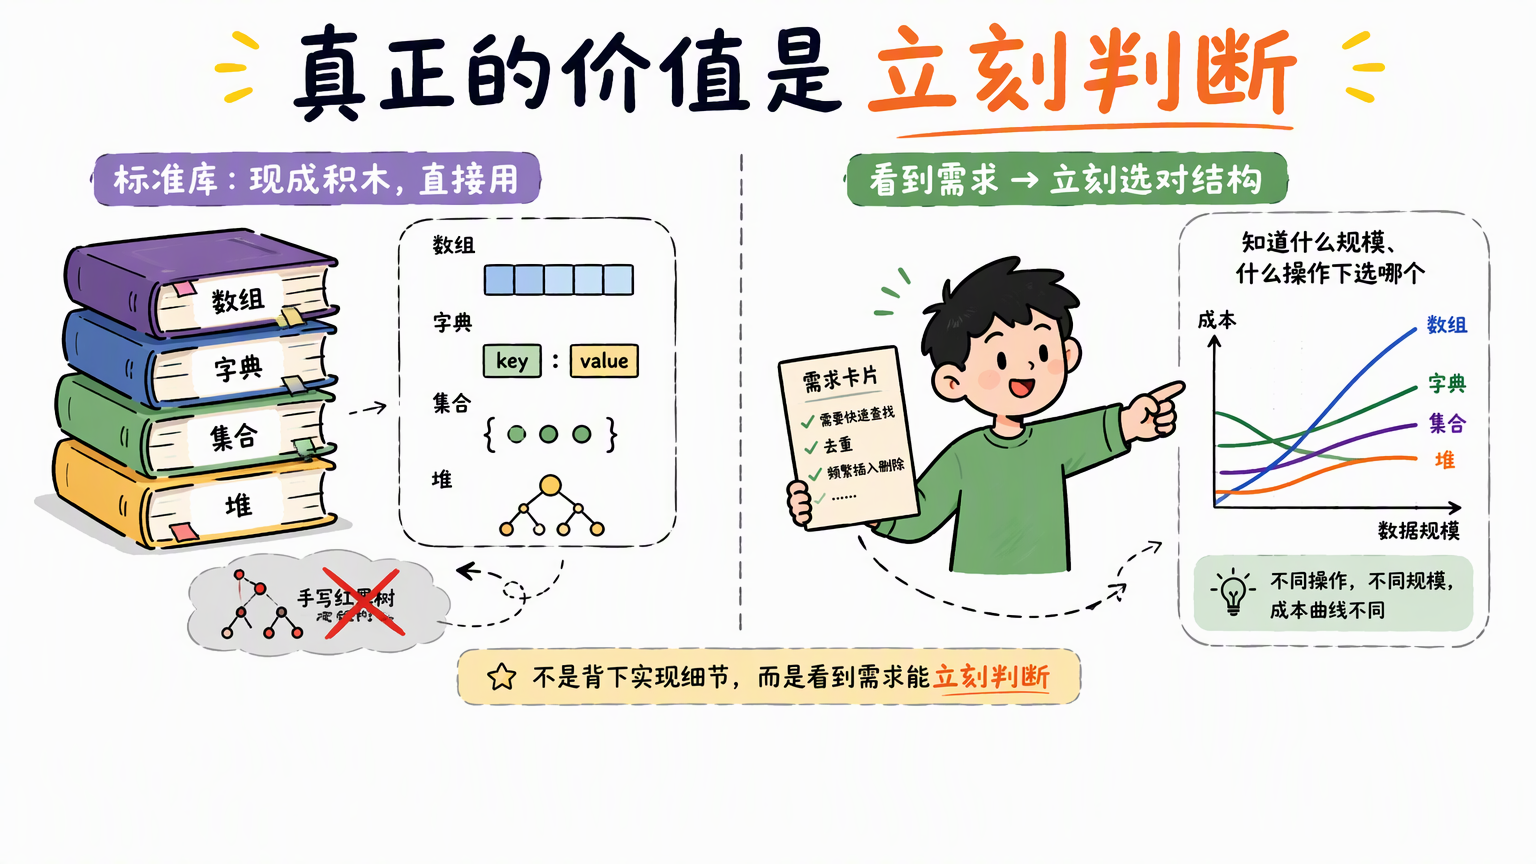
主流语言已经把这些结构做成了标准库,数组、字典、集合、堆都是现成的,你不需要手写红黑树。
但前提是你得知道它们的成本曲线,知道在什么规模、什么操作下该选哪一个。否则标准库再全,也选不对摆法。
常见问题
问:比较数据结构时应该看什么指标?
看查找、插入、删除三类操作的成本随数据量增长的趋势,而不是单次操作快不快。
问:数组和链表最核心的差别是什么?
数组连续存放、按下标直达,但中间插入删除要挪元素;链表靠改指针增删,但随机访问退化成线性级,还要为指针多付内存。
问:哈希表既然查找接近常数级,为什么不能全用它?
因为它有哈希冲突需要化解,而且键是无序的,按顺序遍历不合适。
问:已经有了二叉搜索树,为什么还需要红黑树?
普通二叉搜索树可能退化成一条链,平衡树靠旋转维持高度平衡,避免这种退化。
问:栈和队列的价值在哪里?
不在查找效率,而在进出顺序可控:栈后进先出,队列先进先出。
总结
数据结构这门功课真正的价值,不是背下实现细节,而是让你在看到需求的时候,能立刻判断出该用哪种摆法。
先用查找、插入、删除这三类操作和"是否有序"这把尺子量一量,再看数据量涨上去之后还撑不撑得住,选型就不再靠感觉。