什么是 Claude Code 的核心循环
Claude Code 的核心循环(agent loop)是一个持续执行“模型决策、工具执行、结果回传”的程序。模型决定下一步要不要调用工具,harness(运行框架)执行工具并把输出放回消息列表,模型再根据新结果继续推理,直到不再请求工具。
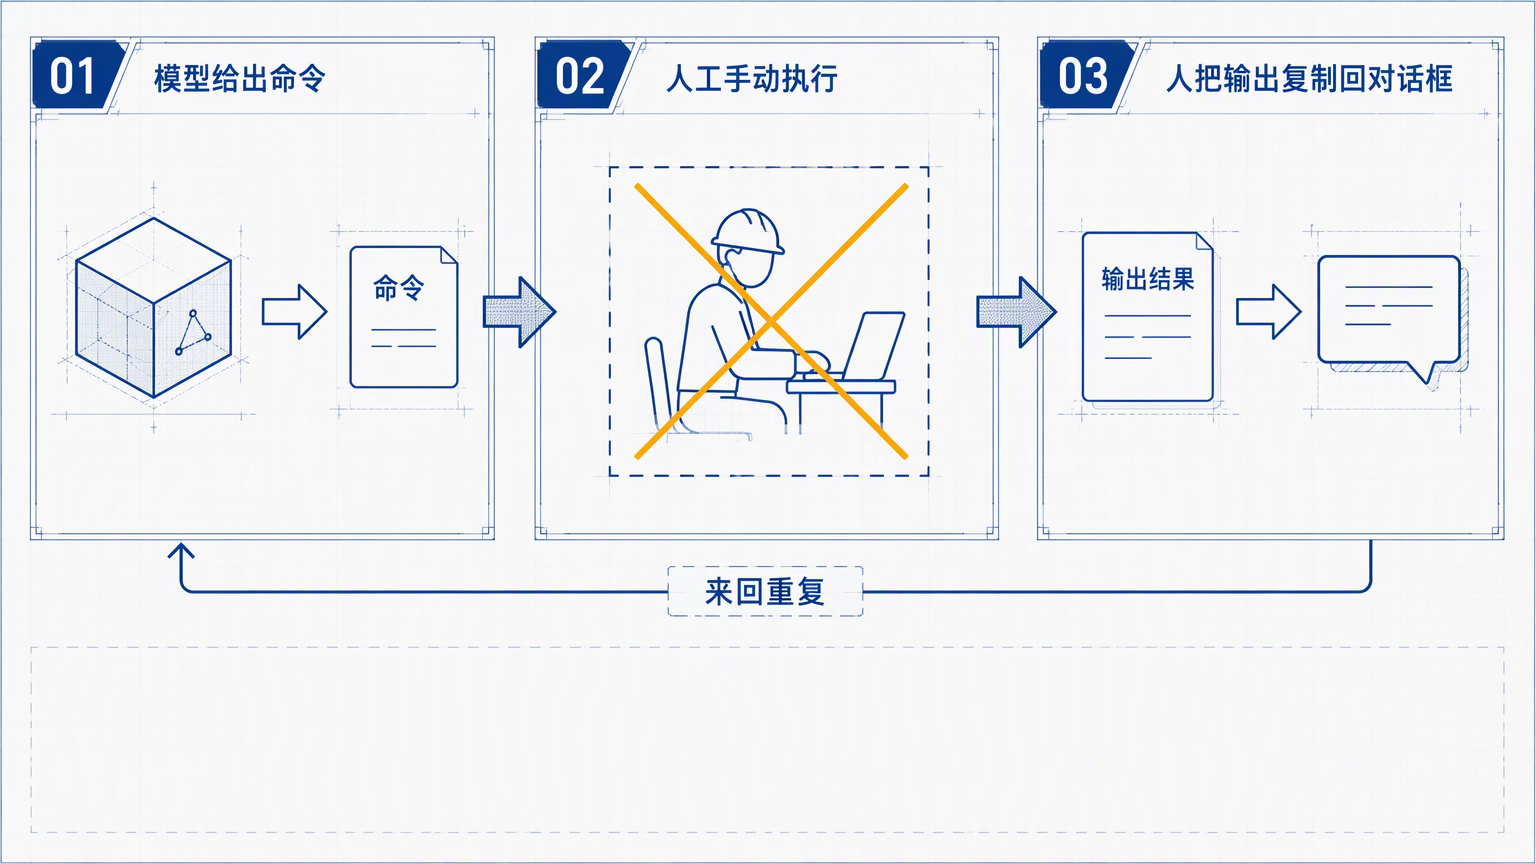
如果你让模型“看一下目录里有哪些文件,再跑一个脚本”,普通聊天流程通常是:模型给出命令,你手动执行,把终端输出复制回对话框,模型再给下一条命令。Claude Code 把中间这段人工往返交给程序,所以模型可以连续读取文件、运行脚本和检查结果。
这个定义可以直接用于判断一个系统是不是 agent loop:只要模型能够发出工具调用,系统执行工具并把结果作为新消息回传,循环就成立。
为什么需要把人工从中间拿掉
手动执行命令的问题不是命令本身,而是每一步都需要人充当“消息搬运工”。这会带来三个实际成本:
- 延迟增加:每轮都要等待人复制、粘贴和确认。
- 上下文容易丢失:复制输出时可能截断日志、漏掉错误码或粘错目录。
- 无法稳定扩展:两三步还能手动完成,几十轮排错就很难保持一致。
agent loop 把这段交互固定成程序流程。模型负责决策,harness 负责执行,消息列表负责保存上下文。三者的边界清楚后,系统才有可能加入权限、超时、重试和审计。
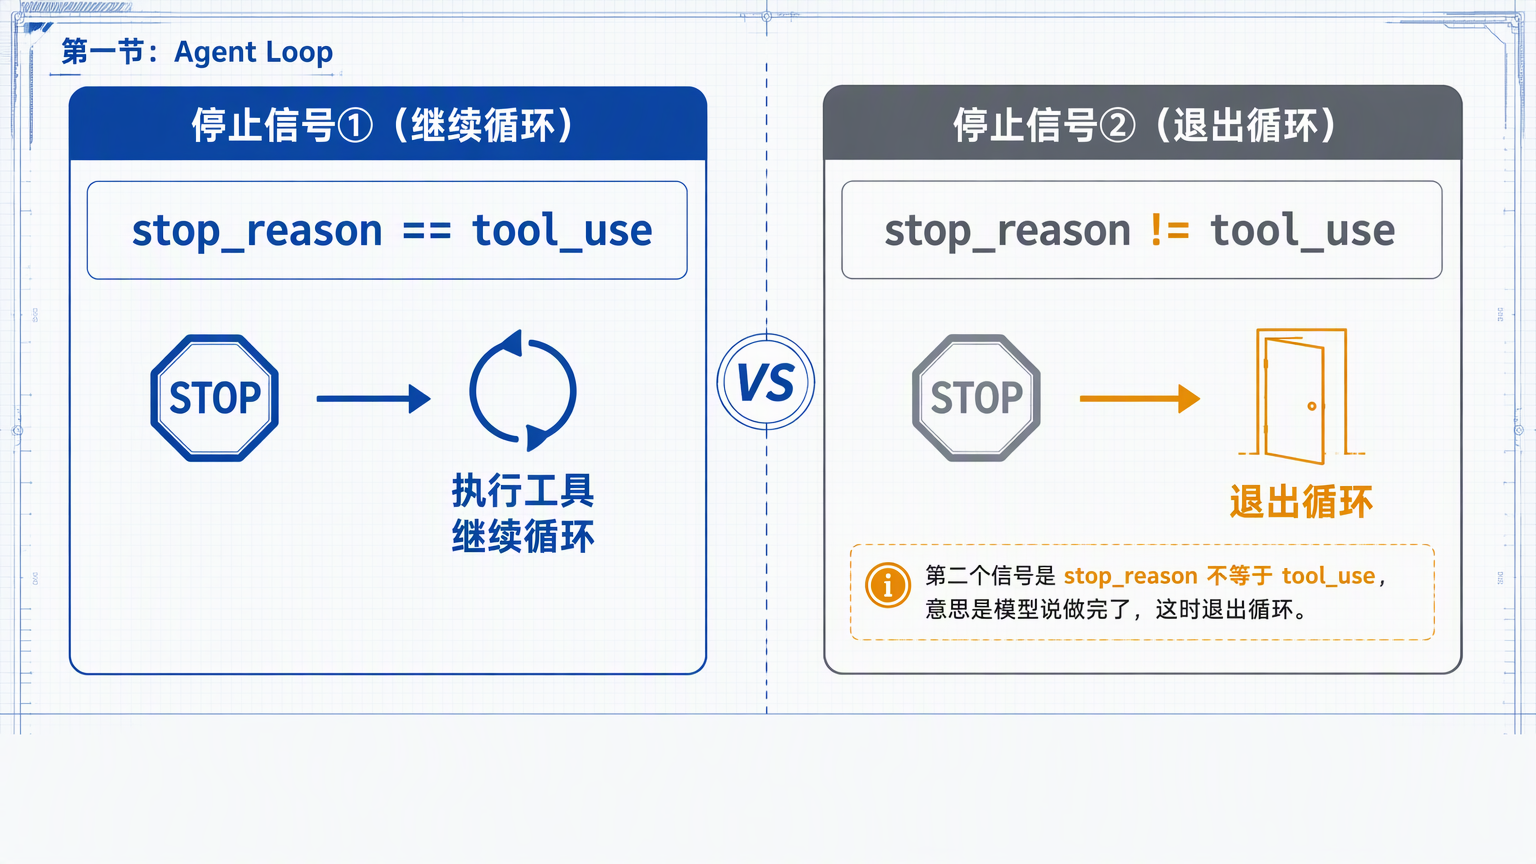
agent loop 只看哪两个信号
教学版可以只观察模型响应里的两个状态:
| 信号 | 含义 | 下一步 |
|---|---|---|
stop_reason == "tool_use" | 模型请求调用工具 | 执行工具,把 tool_result 回传,再次调用模型 |
stop_reason != "tool_use" | 模型没有继续请求工具 | 退出循环,返回最终回答 |
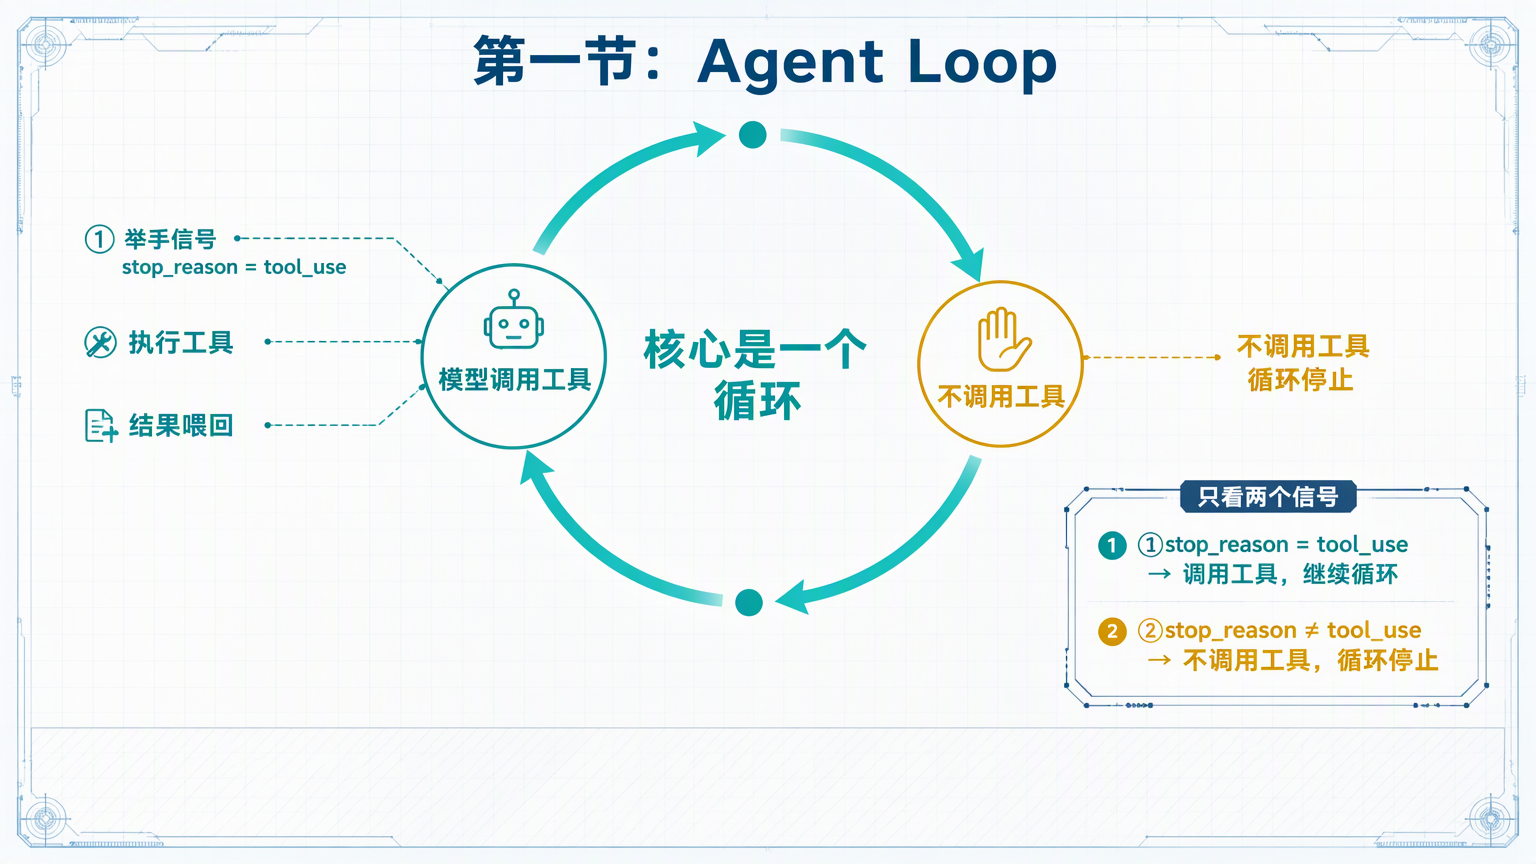
因此,循环的判断不是“模型是不是已经足够聪明”,而是一个明确的协议字段。tool_use 表示模型举手说“我要行动”;其他停止原因表示当前轮次可以结束。
如何把循环翻译成五步代码
最小实现可以拆成五步,顺序不能颠倒:
- 把用户问题放入第一条消息。
- 把消息和工具定义一起发送给模型。
- 把模型回答追加到消息列表,检查是否请求工具。
- 执行模型指定的工具,收集输出。
- 把工具输出包装成新消息,再回到第 2 步。
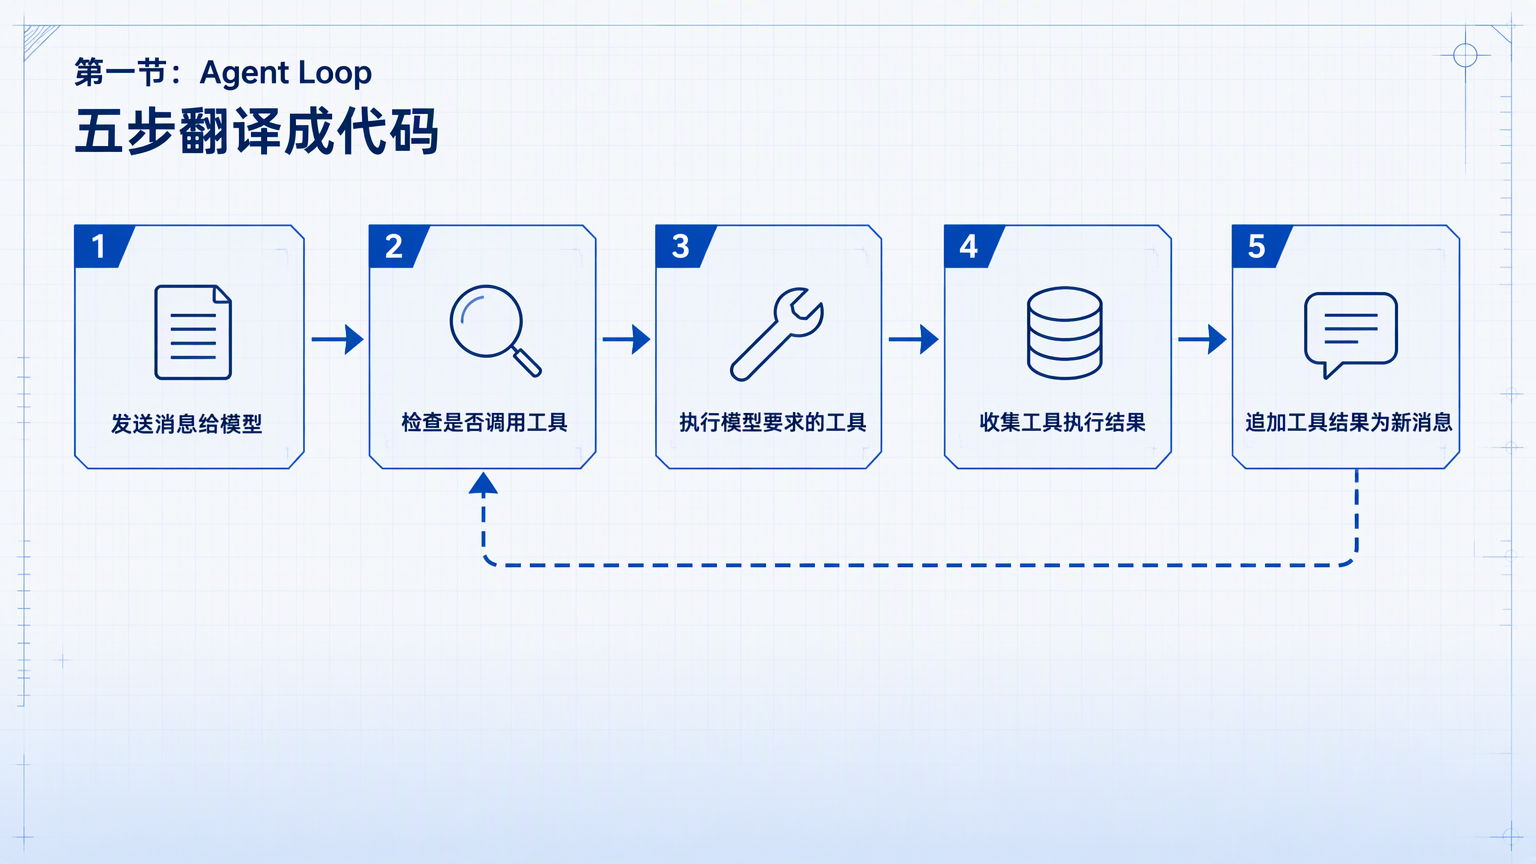
这五步里,第 3 步决定循环是否继续,第 4 步把模型的文本意图变成真实动作,第 5 步把外部世界的反馈重新接回模型上下文。
最小可运行的 agent harness 怎么写
下面的函数展示核心结构。示例使用 Anthropic 风格的 client.messages.create 接口,并假设 TOOLS 中已经声明了可用工具:
def agent_loop(messages):
    while True:
        response = client.messages.create(
            model=MODEL,
            system=SYSTEM,
            messages=messages,
            tools=TOOLS,
            max_tokens=8000,
        )

        messages.append({
            "role": "assistant",
            "content": response.content,
        })

        if response.stop_reason != "tool_use":
            return response.content

        results = []
        for block in response.content:
            if block.type == "tool_use":
                output = run_bash(block.input["command"])
                results.append({
                    "type": "tool_result",
                    "tool_use_id": block.id,
                    "content": output,
                })

        messages.append({
            "role": "user",
            "content": results,
        })
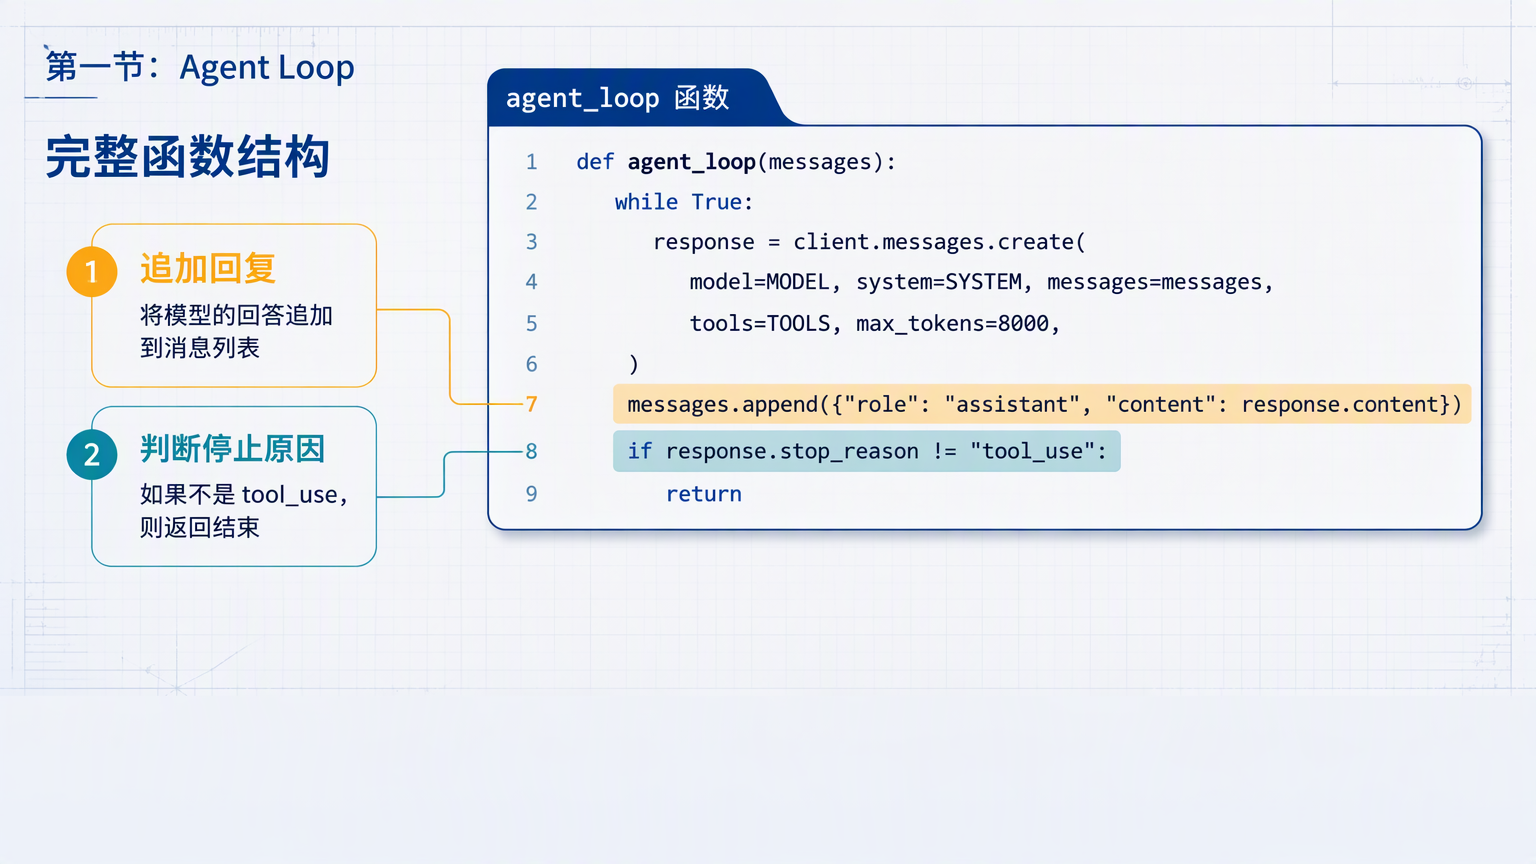
关键点只有两个:先把模型回答追加进 messages,再检查 response.stop_reason。如果不是 tool_use,函数返回;如果是 tool_use,就进入工具执行阶段。
真实 SDK 可能要求 content、消息类型或错误字段使用不同的数据结构,调用前应以所用 SDK 的类型定义为准。上面的代码用于解释循环协议,不是可以直接授予生产权限的完整命令执行器。
工具执行阶段具体做什么
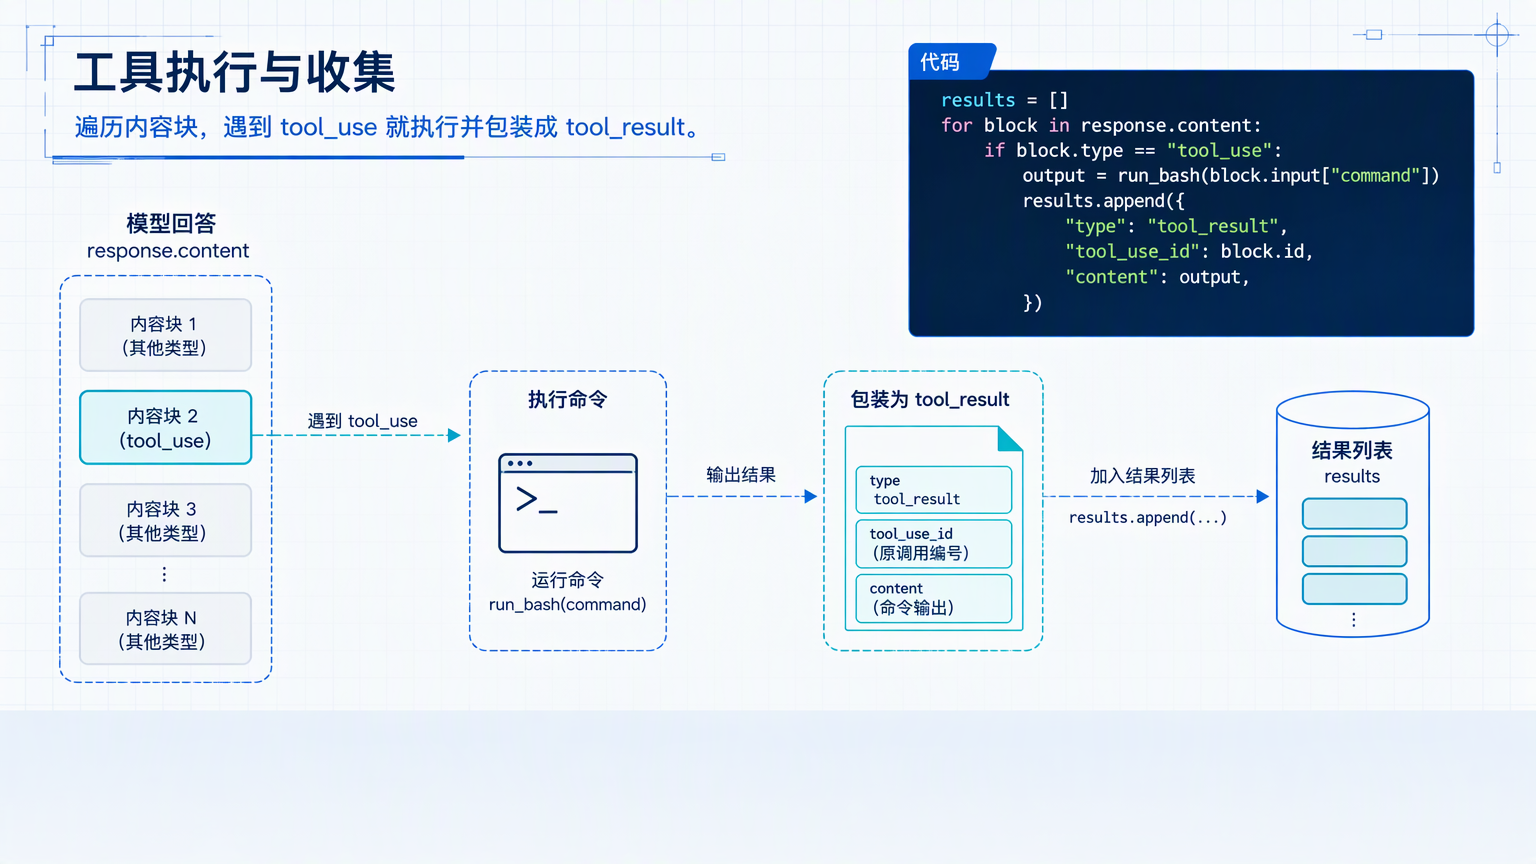
模型的回答可能包含文本、思考摘要和多个内容块。harness 遍历这些内容块,只处理 tool_use 类型:读取工具名和参数,执行对应函数,再把输出包装成 tool_result。tool_use_id 必须原样带回,这样模型才能把结果对应到刚才的调用。
results = []
for block in response.content:
    if block.type == "tool_use":
        output = run_bash(block.input["command"])
        results.append({
            "type": "tool_result",
            "tool_use_id": block.id,
            "content": output,
        })
执行结果随后作为一条新的用户消息加入列表:
messages.append({
    "role": "user",
    "content": results,
})
下一轮模型收到的上下文因此包含三部分:原始问题、模型刚才的工具调用、工具返回的真实输出。循环可以从第 2 步重新开始。
为什么这不到 30 行的代码很重要
这段代码不是智能本身,而是让模型能够持续行动的最小运行框架。职责可以这样分开:
| 部件 | 负责什么 | 不负责什么 |
|---|---|---|
| 模型 | 判断是否调用工具、选择工具、填写参数 | 直接访问你的文件系统或终端 |
| 工具 | 执行命令、读取文件、调用 API | 决定下一步任务目标 |
| harness | 调度调用、保存上下文、回传结果 | 代替模型进行开放式决策 |
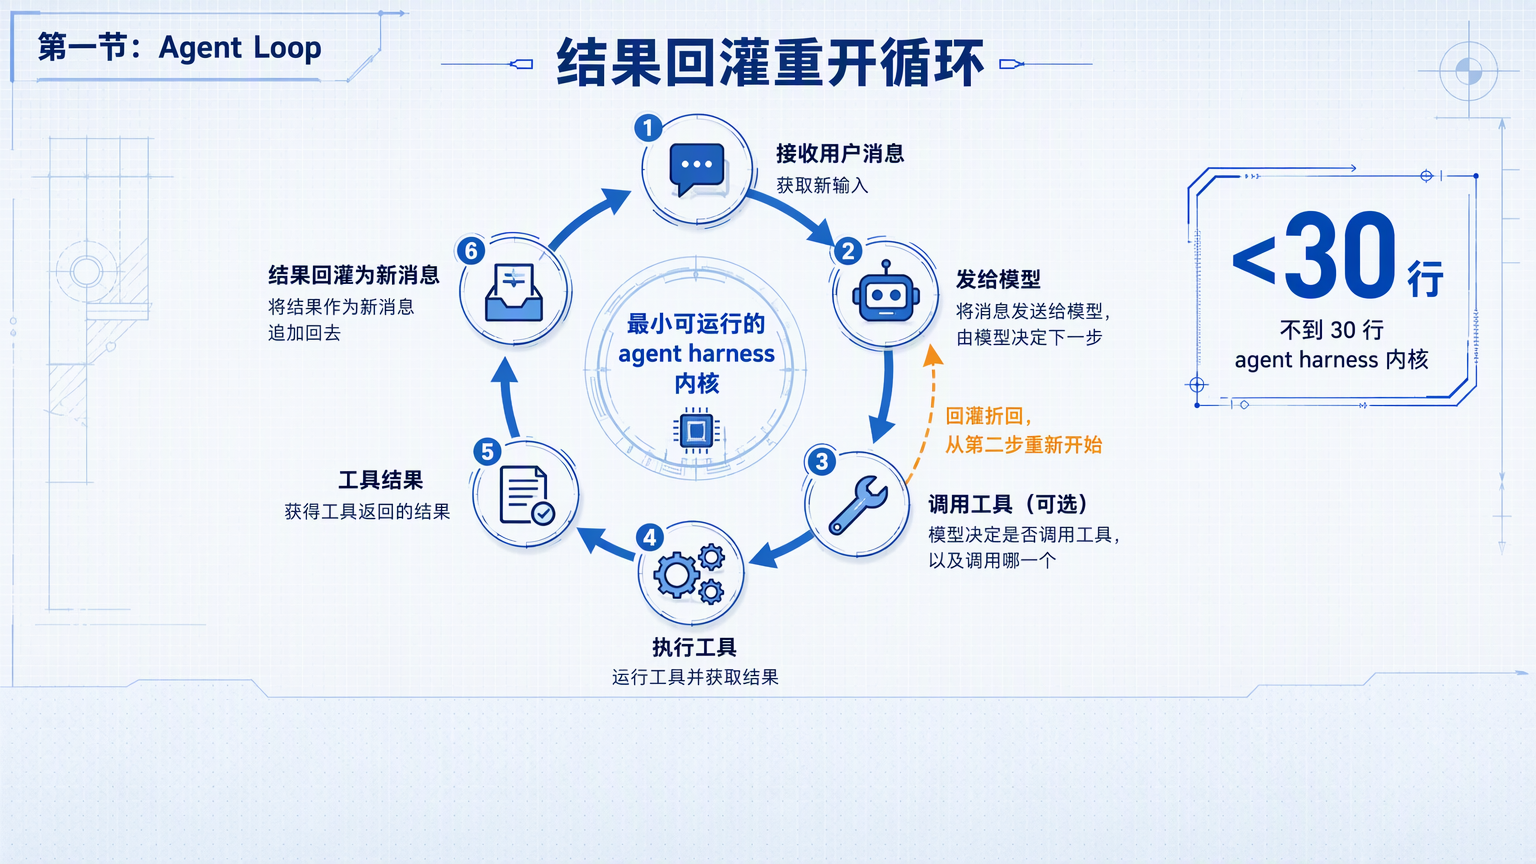
后续章节可以在这个循环上叠加更多机制,循环的基本形状仍然是“调用模型 → 发现工具调用 → 执行工具 → 回传结果”。
只有 bash 一个工具时,模型能做什么
如果 TOOLS 里只有一个 bash,模型仍然可以完成很多基础操作,但都要通过命令拼接:
| 任务 | bash 命令示例 | 主要问题 |
|---|---|---|
| 读取文件 | cat README.md | 文件过大时输出可能超限 |
| 写入文件 | echo 'text' > file.txt | 转义、覆盖和多行内容容易出错 |
| 查找文件 | find . -name '*.py' | 参数复杂,结果需要再次解析 |
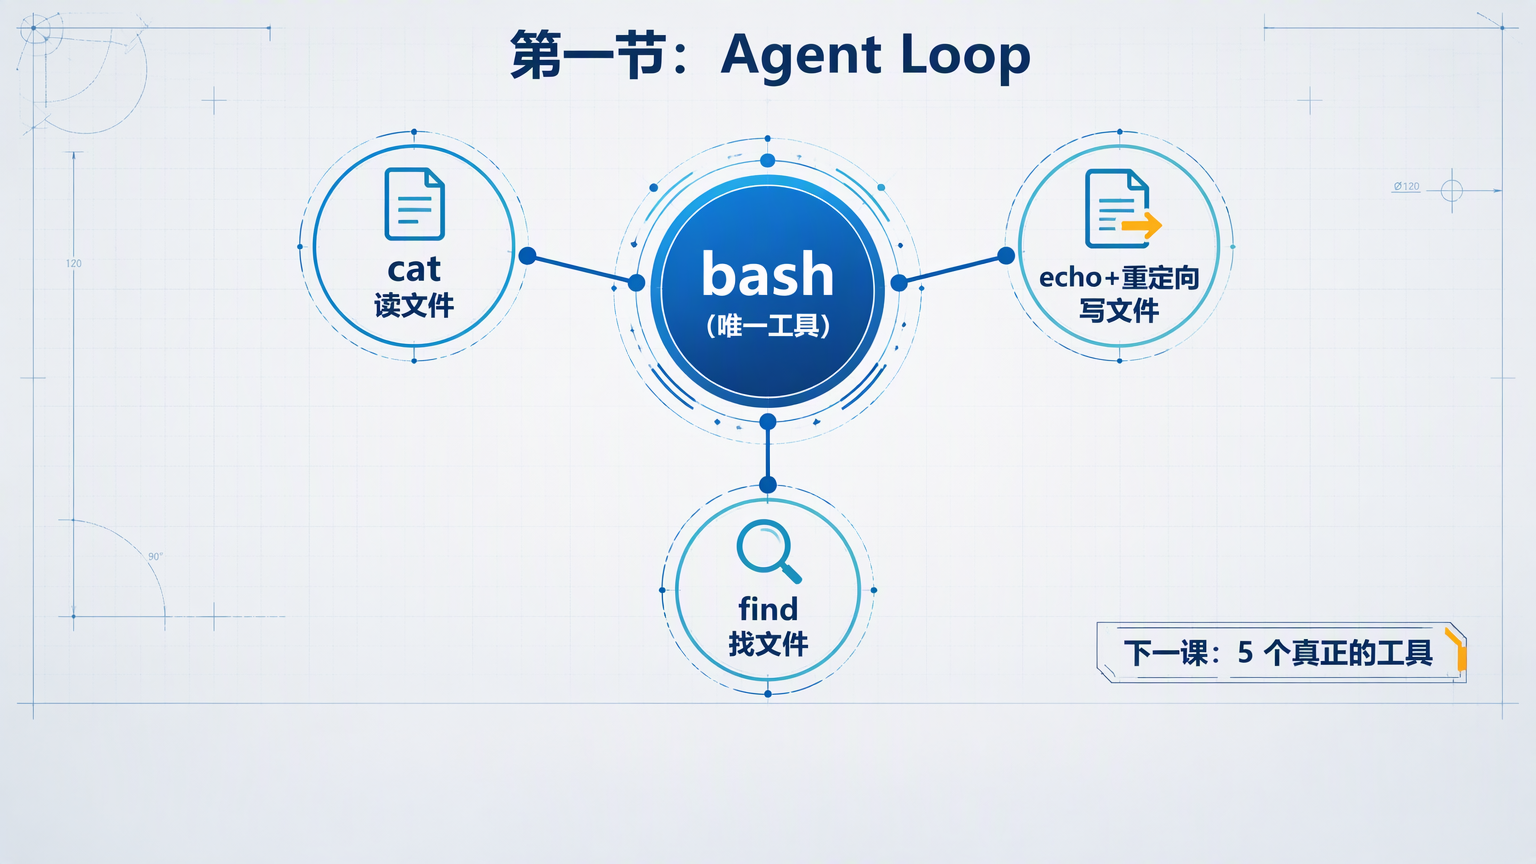
这正是下一课要解决的问题:给模型提供读取、写入、查找、编辑等更明确的工具,并观察多个工具调用是否会并行发生,以及并行执行时如何避免互相覆盖。
生产实现为什么不能只看 stop_reason
教学代码用 stop_reason 判断是否继续,生产版通常要考虑流式响应。流式传输过程中,stop_reason 可能尚未更新,但内容流里已经出现了 tool_use 块。此时如果只看字段,harness 可能过早退出。
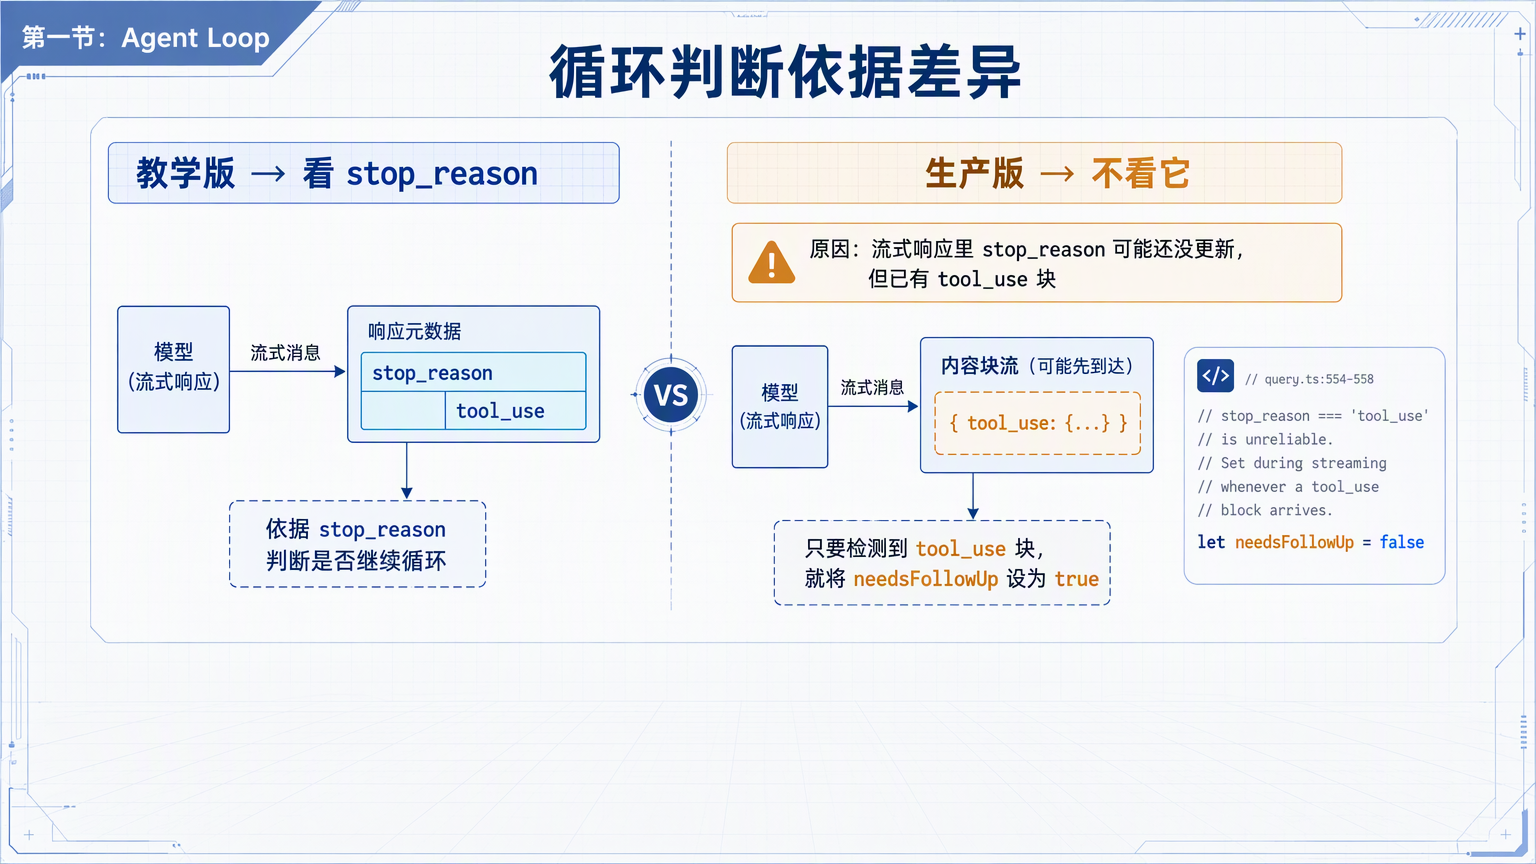
生产实现通常维护一个 needsFollowUp 标志:流式接收内容时,只要检测到 tool_use 块,就把它设置为 true。循环是否继续由这个标志决定;message_delta 中的真实 stop_reason 可以服务于日志或其他状态处理,但不作为唯一依据。
// query.ts:554-558
// stop_reason === 'tool_use' is unreliable.
// Set during streaming whenever a tool_use block arrives.
let needsFollowUp = false;
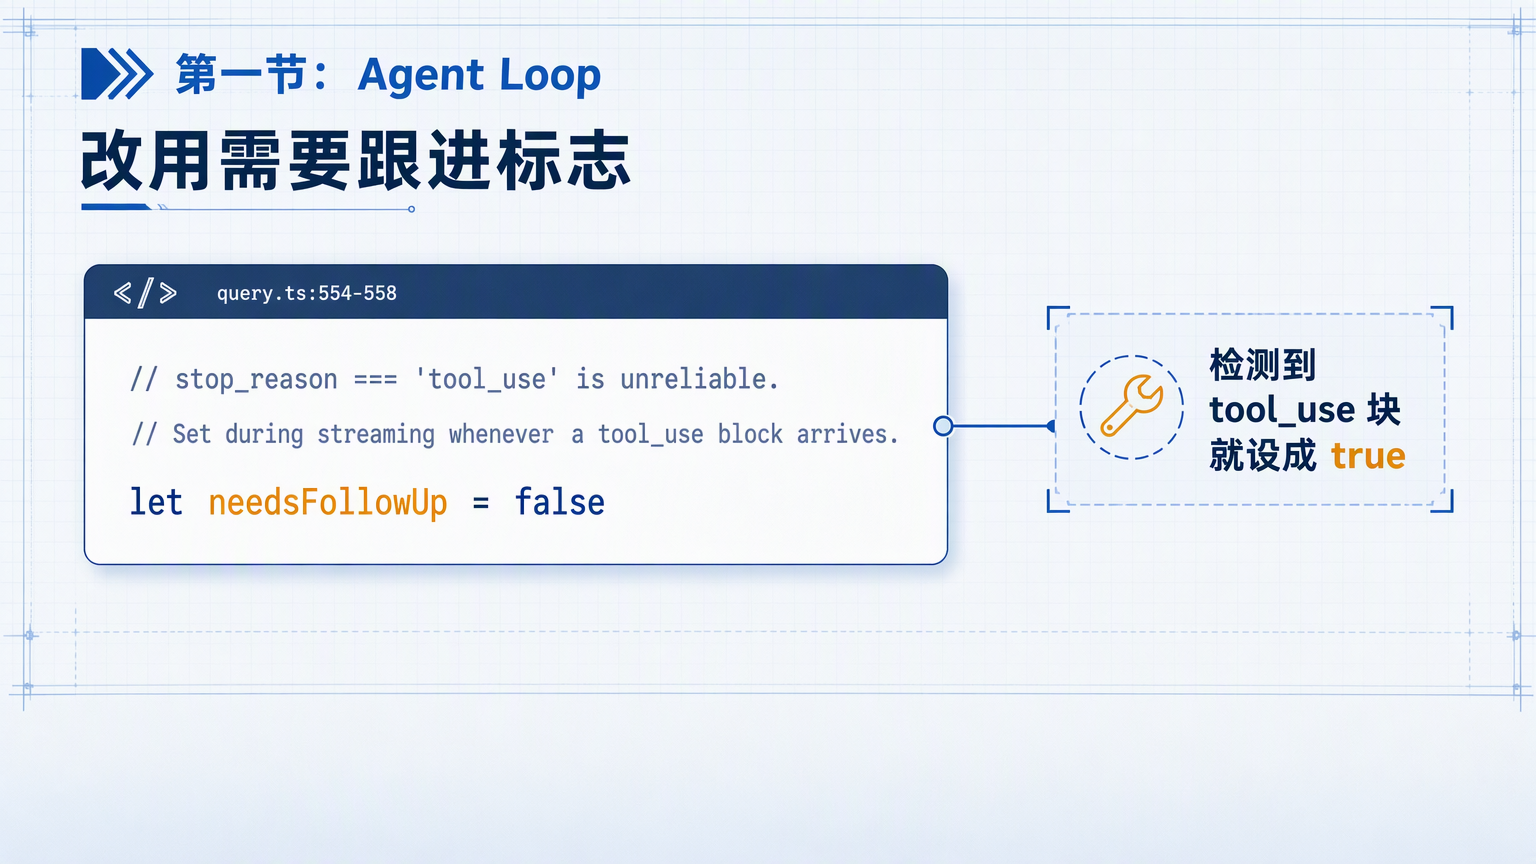
这条差异只适用于流式实现。非流式调用可以直接读取完整响应中的停止原因,但仍应处理 SDK 返回异常、内容块缺失和工具参数校验失败。
生产版状态对象为什么有十个字段
教学版只需要一个 messages 数组,生产版还要记录保护循环的状态。常见字段包括:
- 工具、信号和权限上下文。
- 压缩状态和上下文追踪。
- token 恢复尝试次数,上限可能是 3 次。
- 本轮是否尝试过响应式压缩,以及 8K 到 64K 的升级覆盖。
- 后台生成的工具使用摘要。
- 停止钩子是否产生阻塞错误。
- 轮次计数和上一次继续的原因。
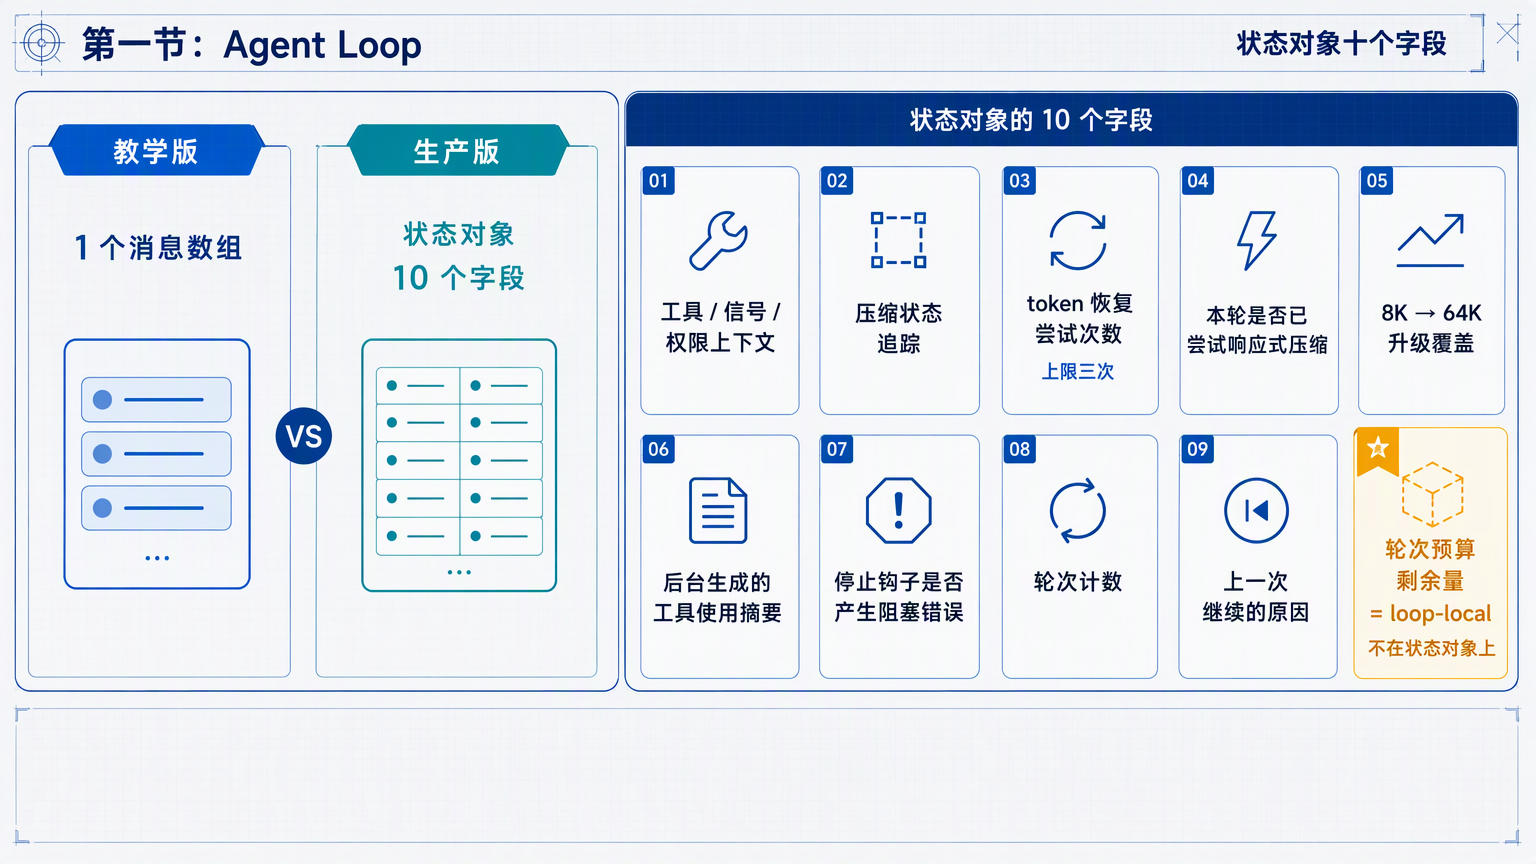
轮次预算的剩余量是一个容易被忽略的细节:它通常是循环内部的局部变量(loop-local),不属于状态对象。这样做能让本轮预算随着循环推进,而不会被错误地当成跨轮持久状态。
生产版有哪些退出和恢复路径
教学版通常只有“模型不调用工具,退出”这一条路径。生产版还要处理阻塞上限、提示过长、模型报错、用户中止、钩子停止、轮次上限、token 预算续跑和响应式压缩重试等情况。
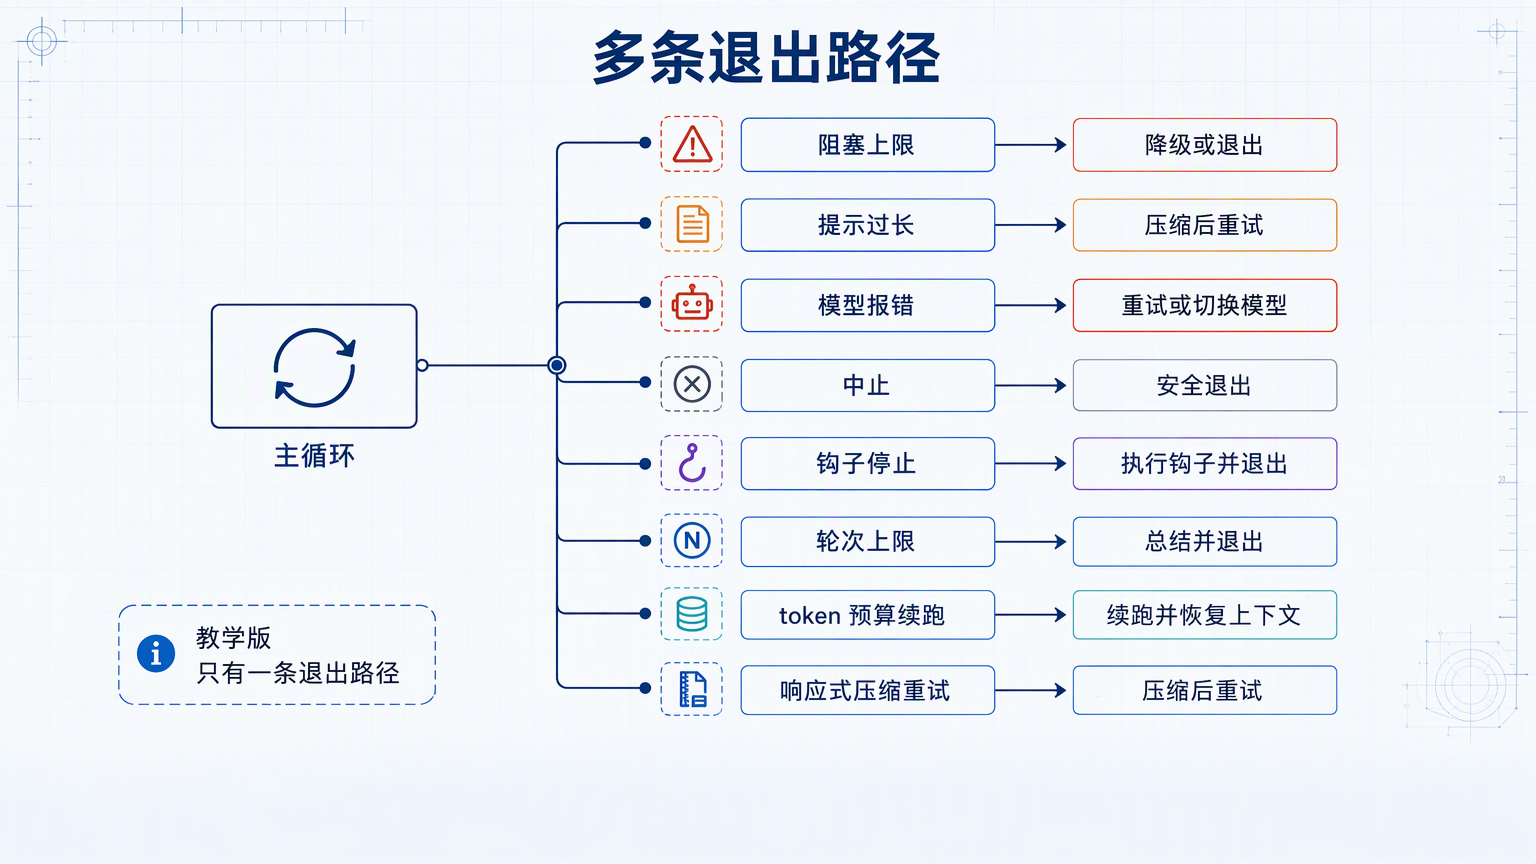
可以把这些路径归纳为三类:
- 可恢复错误:压缩上下文、重试请求或切换模型后继续。
- 需要降级的错误:达到阻塞上限、预算用尽或工具权限不足时,返回可解释的部分结果。
- 安全退出:用户中止、停止钩子阻塞或检测到危险命令时,立即停止执行。
这些保护机制不会改变核心决策协议,只是给循环增加了更多“继续、重试、降级、退出”的边界。
工具为什么可以并行执行
生产版可能在模型仍然生成响应时就开始执行已经完整解析出的工具调用。对于并发安全的工具,可以并行运行;会写同一个文件、修改同一数据库记录或依赖前一步结果的工具,则应独占执行或等待前序结果。
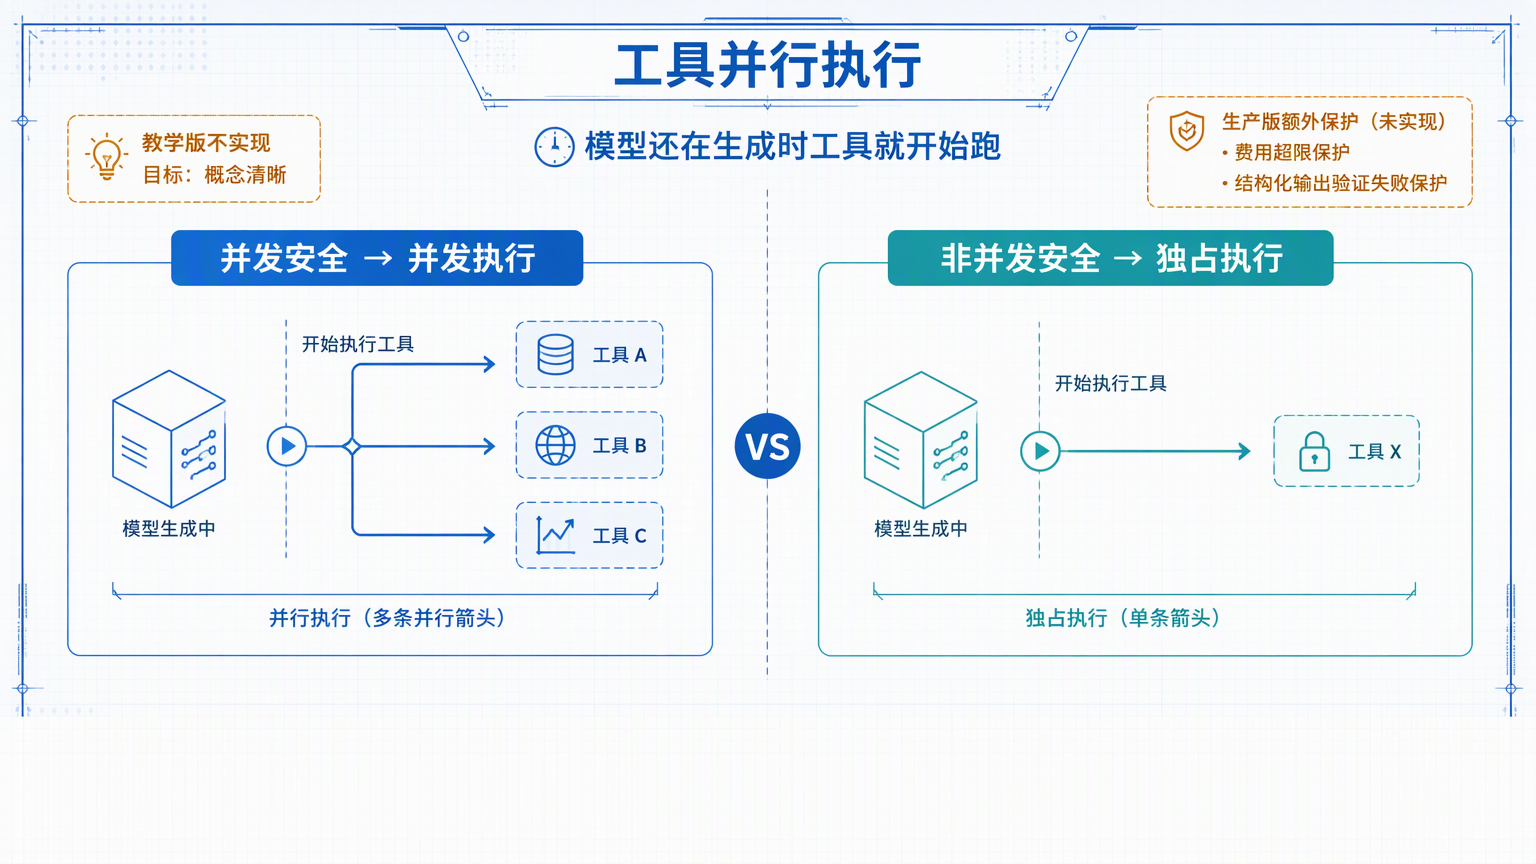
教学版刻意不实现这部分,因为它的目标是先把协议讲清楚。生产版还可能加入费用超限、结构化输出验证失败等保护,代价是状态机和测试复杂度都会增加。
| 执行方式 | 适合的工具 | 主要约束 |
|---|---|---|
| 并行 | 独立查询、只读搜索、互不共享状态的计算 | 需要限制并发数和总费用 |
| 独占 | 写文件、数据库更新、部署、依赖前序输出的命令 | 保证顺序和资源一致性 |
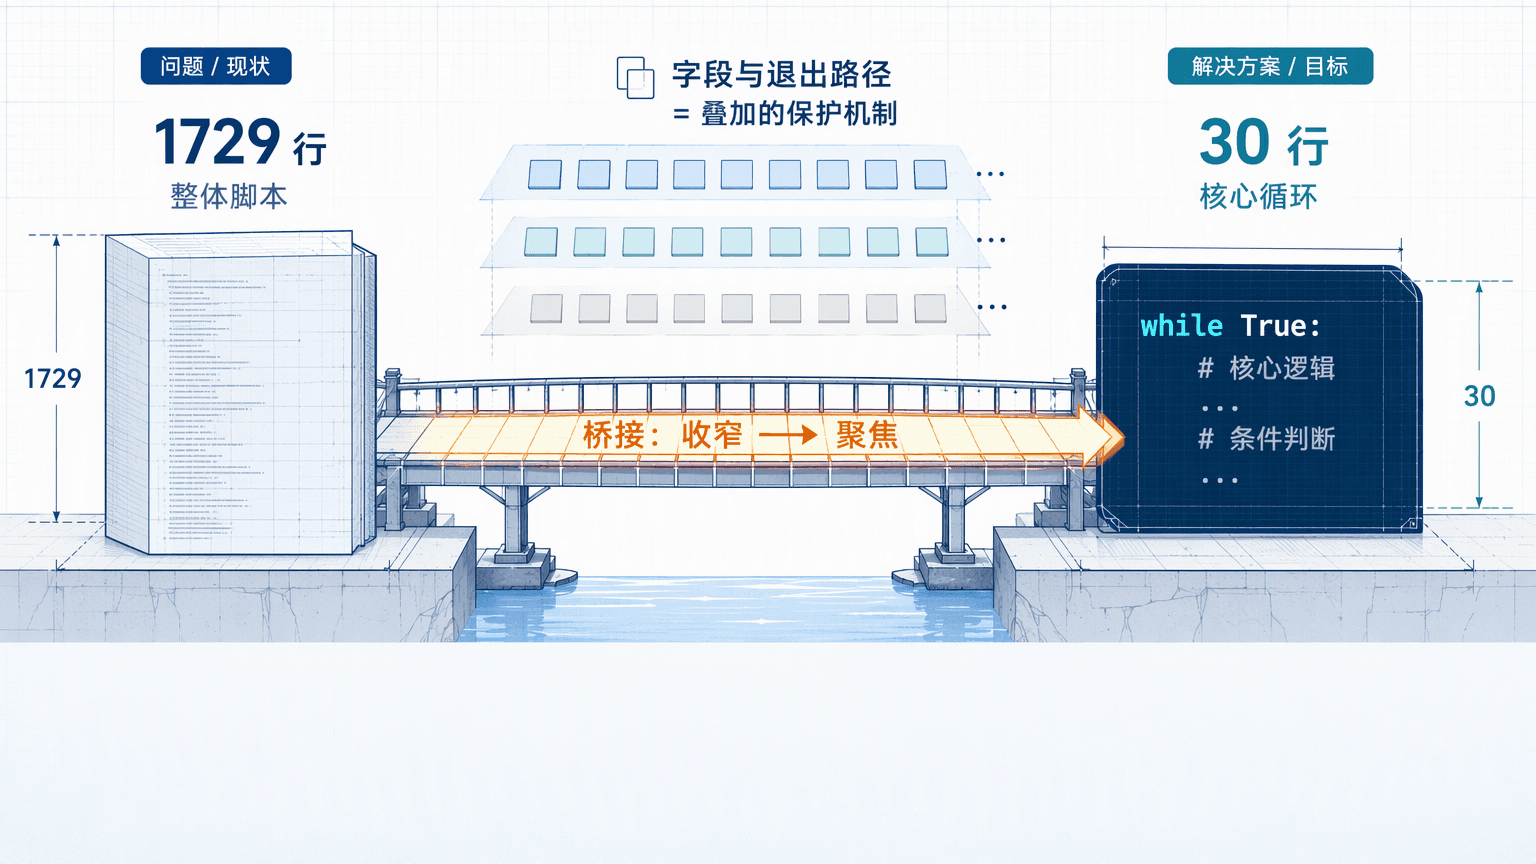
1729 行生产实现和 30 行教学版差在哪里
生产代码变长,通常不是因为核心循环变得更神秘,而是因为它要覆盖真实环境中的保护条件。可以用下面的关系理解两者:
| 维度 | 教学版 | 生产版 |
|---|---|---|
| 循环判断 | 读取 stop_reason | 流式检测 tool_use,维护 needsFollowUp |
| 状态 | 一个消息数组 | 工具、权限、压缩、预算、钩子和轮次状态 |
| 退出路径 | 不调用工具就退出 | 重试、压缩、降级、中止、预算续跑和安全退出 |
| 工具执行 | 顺序执行 | 按并发安全性选择并行或独占 |
| 目标 | 说明协议 | 在成本、权限、延迟和错误下持续运行 |
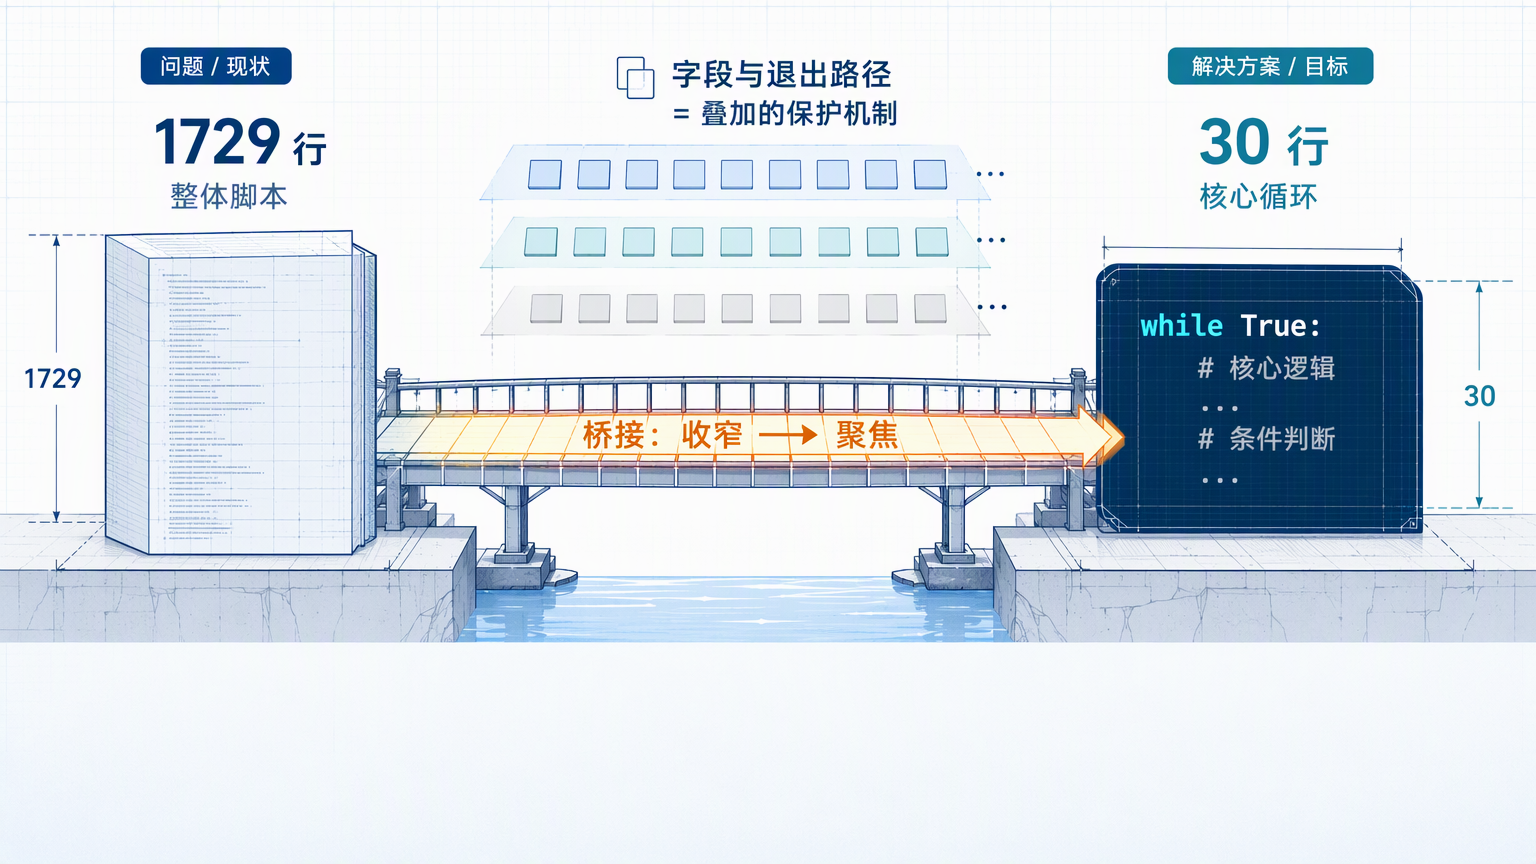
所以,读生产实现时可以先定位三处:模型调用发生在哪里、工具结果如何回灌、循环依据哪个标志继续。其余字段和分支大多是在这三处周围提供保护。
常见问题
Claude Code 的 agent loop 是不是 ReAct?
两者都通过“行动后观察结果,再继续推理”的循环工作。ReAct 是一种更宽泛的智能体方法,Claude Code 的具体实现还包含流式工具调用、权限控制、上下文压缩和多种退出策略。
stop_reason 为什么不能在生产版作为唯一判断?
因为流式响应中停止原因可能晚于内容块到达。模型已经发出 tool_use 时,stop_reason 可能仍未更新,所以生产实现要在收到工具块时设置 needsFollowUp。
一个消息数组为什么能保存整个循环?
每轮都把 assistant 的工具调用和 user 的 tool_result 追加到同一个数组。下一次模型调用读取完整数组,就能看到任务、动作和观察结果的顺序。
为什么必须保留 tool_use_id?
它是工具调用和工具结果之间的关联标识。模型一次请求多个工具时,ID 能让每个结果准确对应到原来的调用。
只有 bash 工具可以做出 Claude Code 吗?
可以做出概念验证,但可控性较差。明确的读文件、写文件、编辑、搜索和测试工具能减少命令拼接错误,也更容易做权限限制、参数校验和审计。
agent loop 会不会无限循环?
会。生产系统需要设置轮次上限、token 预算、超时、重复调用检测和用户中止机制。教学版省略这些保护,是为了突出核心协议,并不适合直接执行不受限制的真实命令。
小结
Claude Code 让模型自己干活的核心,是一个由工具调用驱动的 while True 循环:模型做决策,harness 执行工具,工具结果回到消息列表,循环直到模型不再请求工具。
这不到 30 行的结构解释了 1729 行生产实现的骨架。生产版新增的状态、并行策略、压缩机制、权限检查和退出路径,都是为了让同一个循环在流式响应、错误、成本和安全约束下继续可靠运行。