什么是 C 语言?
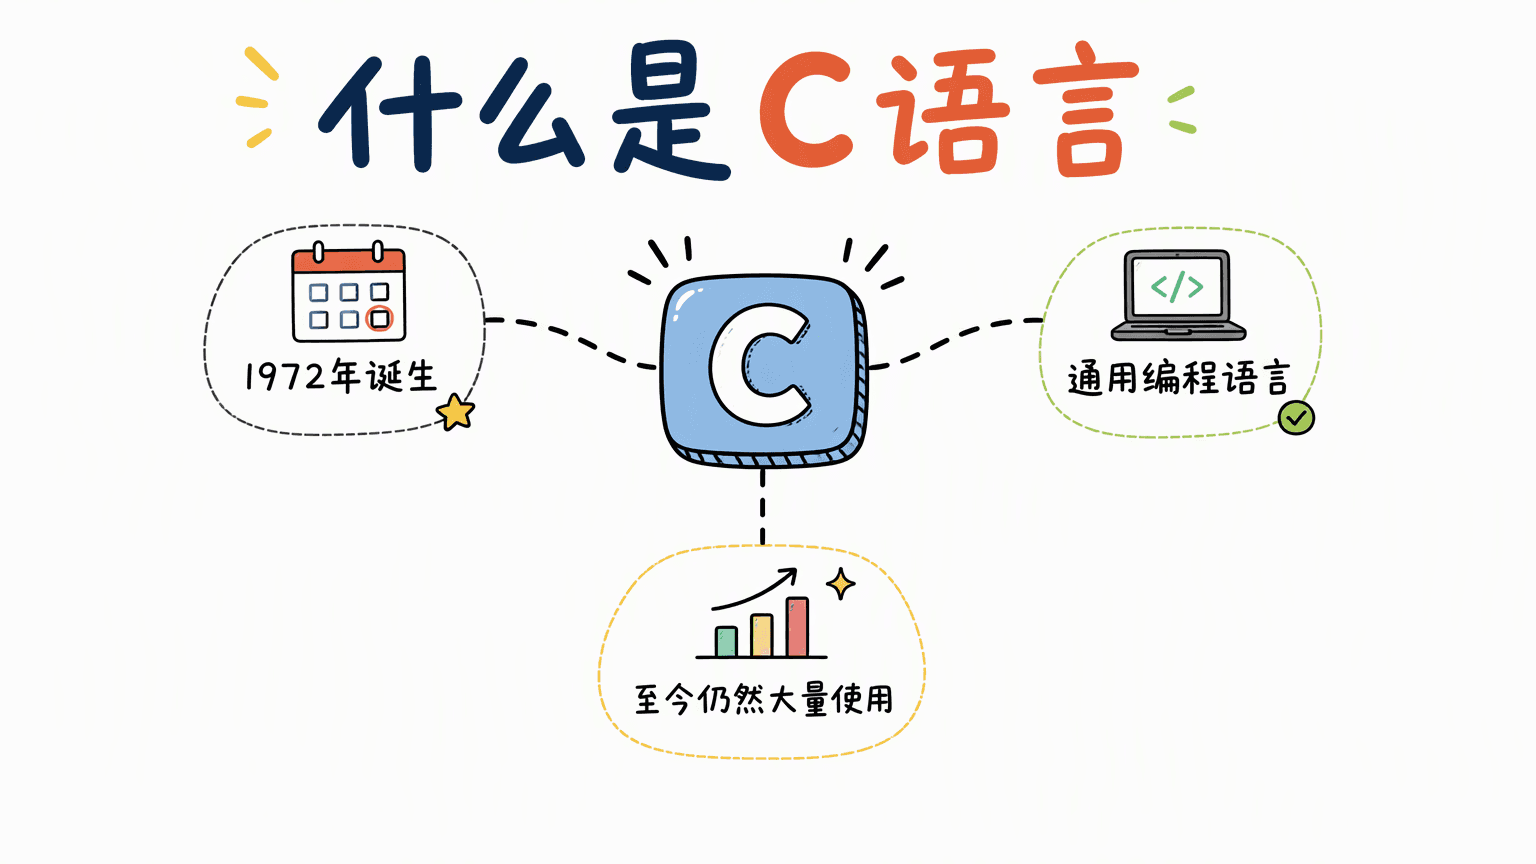
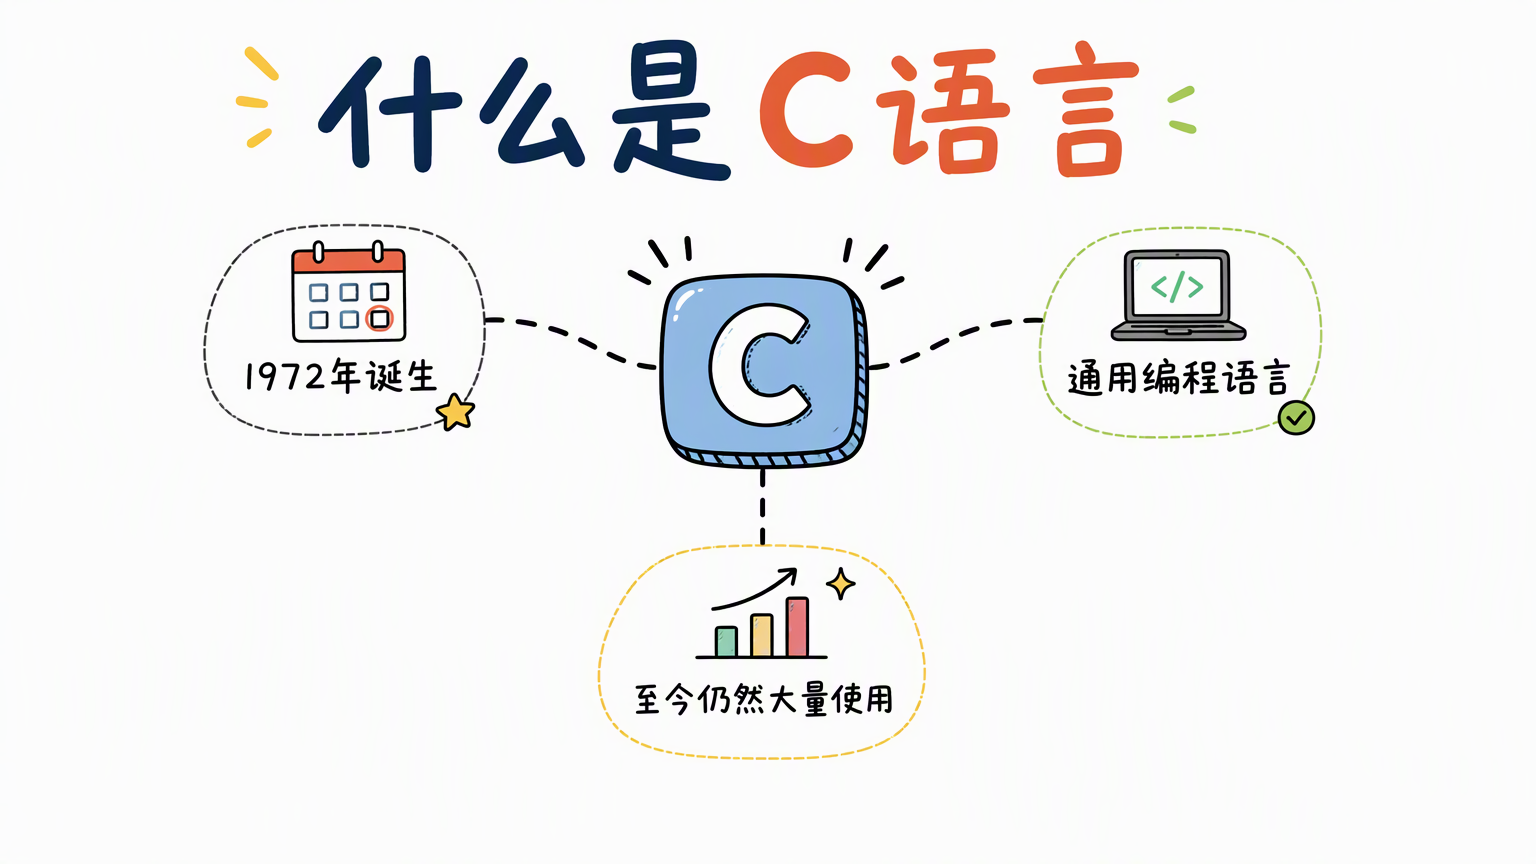
C 语言是一门诞生于 1972 年的通用、静态类型、过程式编程语言。它让程序员可以用相对易读的语法,直接控制内存、数据布局和硬件接口。 C 通常先经过编译器翻译成机器码,再由处理器执行,因此适合操作系统、驱动、嵌入式设备和高性能基础设施。
C 解决的是一个很具体的问题:汇编语言离硬件很近,却难读、难写、难移植;更高级的语言容易表达业务,却可能无法精确控制资源。C 在两者之间提供了一个稳定的折中:保留指针、位运算和内存布局等底层能力,同时用函数、结构体和标准库组织更大的程序。
所以,“C 是高级语言里的低级语言”说的是它离硬件近,不是能力低。它给开发者的默认承诺是:你写下的每一层数据和资源操作,都可以追溯到程序在机器上的实际行为。
C 语言是谁设计的?为什么会和 Unix 一起出现?
C 由贝尔实验室的丹尼斯·里奇(Dennis Ritchie)主导设计。它的直接背景是 Unix:团队需要一种比汇编更容易维护、又能保留系统控制力的语言来重写操作系统。
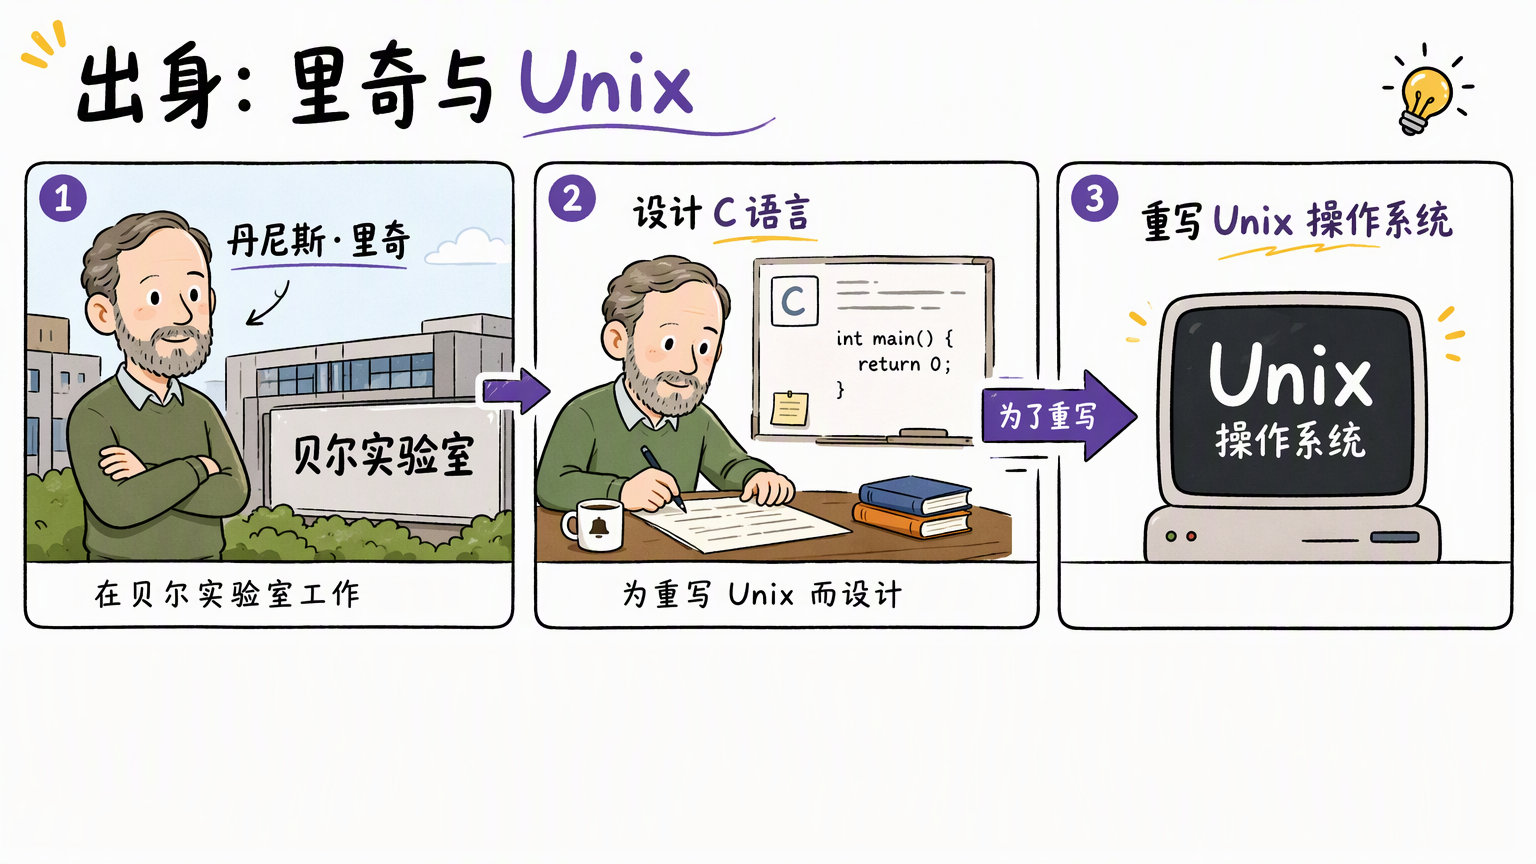
早期 Unix 曾使用汇编实现。1973 年左右,Unix 的大部分代码被改写为 C,这件事证明了操作系统可以用一种相对可移植的高级语言实现。换一台机器时,团队不必从头重写全部汇编,只需要移植编译器、少量启动代码和硬件相关部分。
这段历史解释了 C 的设计取向:它不是为了隐藏机器,而是为了用一套简洁的抽象覆盖多种机器。函数调用、指针、数组、结构体和整数运算都足够直接,编译器也有空间把它们映射为高效指令。
为什么 C 被称为“高级语言里的低级语言”?
“高级”和“低级”描述的是抽象层距离,不是语言好坏。汇编通常直接对应某种处理器的指令;C 用变量、表达式和函数组织这些操作,但仍允许程序员触碰地址和字节。
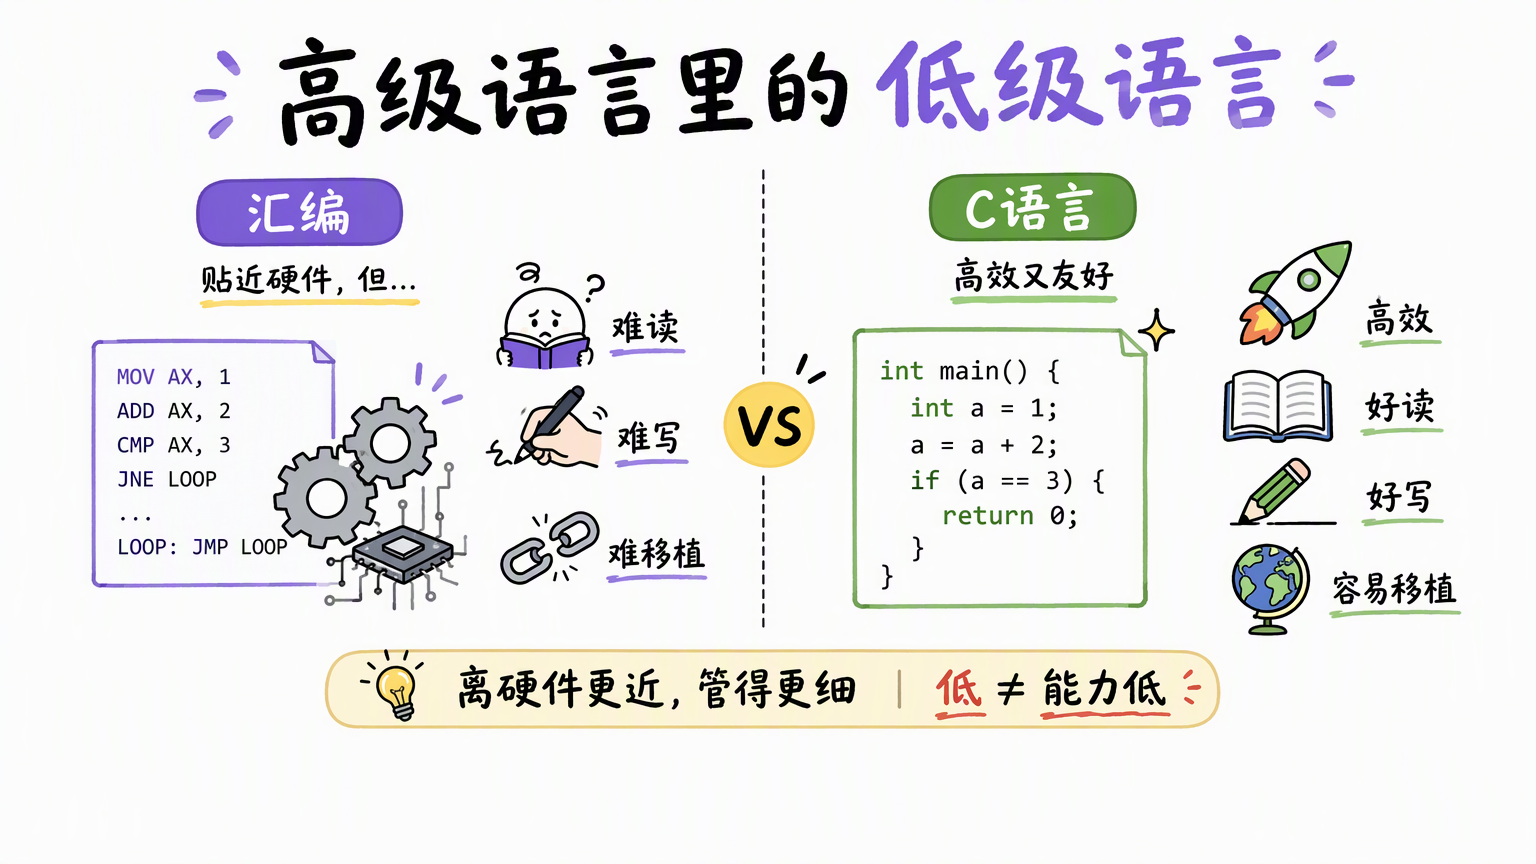
| 维度 | 汇编 | C 语言 | 更高级的语言 |
|---|---|---|---|
| 硬件距离 | 直接使用寄存器和指令 | 可通过指针、位运算和布局控制 | 通常由运行时隐藏更多细节 |
| 可读性 | 强依赖处理器指令集 | 函数和类型让代码更易组织 | 语法通常更贴近业务表达 |
| 可移植性 | 通常绑定某种架构 | 同一标准下可跨编译器和平台 | 依赖运行时或虚拟机 |
| 资源控制 | 几乎全部手动控制 | 手动管理关键资源 | 常见自动内存管理或更强约束 |
C 的位置带来一个实际结果:代码足够接近硬件,能写出小而快的程序;代码又没有被某一种处理器指令集完全锁定。这也是它长期留在系统软件中的原因。
为什么说 C 是计算机世界的“承重墙”?
C 的“地基”地位来自它被放在很多系统的最底层。Windows、Linux 和 macOS 的内核或底层组件大量使用 C;驱动、网络协议栈、文件系统和嵌入式固件也常用 C 实现。Python 的主流实现 CPython、SQLite、Git 等基础软件同样包含大量 C 代码。
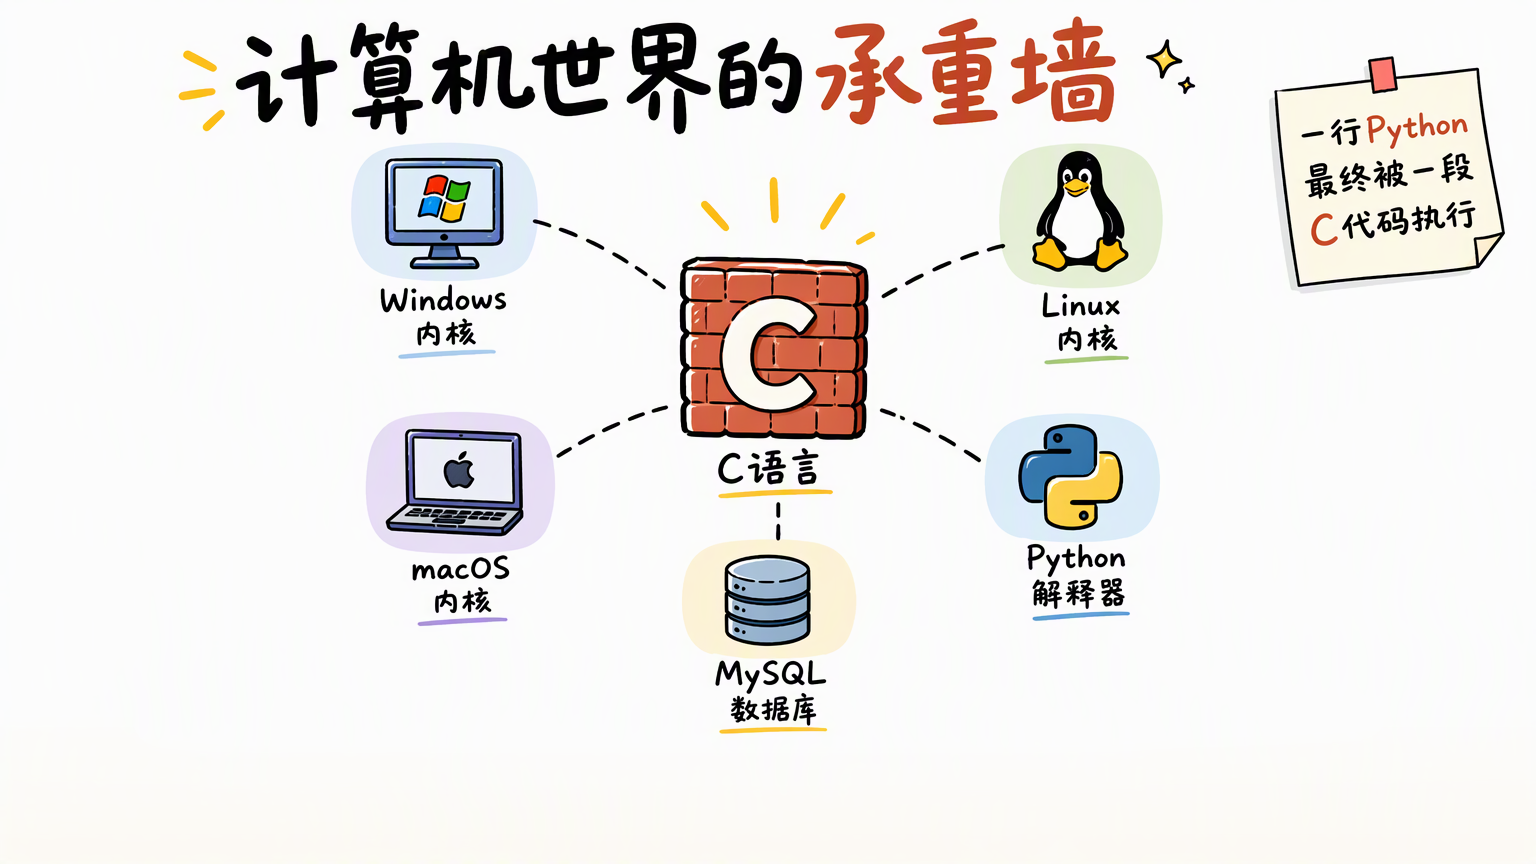
当你运行一行 Python 时,解释器需要分配对象、执行字节码、读写文件并调用操作系统接口。这些关键路径很可能最终进入 C 写成的运行时或系统库。学习 C 的价值因此不只是“多会一门语言”,而是能看见高级抽象下面的数据结构、调用约定和资源边界。
C 标准为什么能让代码跨平台?
C 标准规定了语言语法、标准库接口以及许多行为边界。常见版本包括 ANSI C(通常对应 C89/C90)、C99、C11、C17;更新的 ISO C23 也已经发布。不同编译器只要实现同一标准的相应部分,同一份源代码就有机会在电脑、服务器和单片机上重新编译。
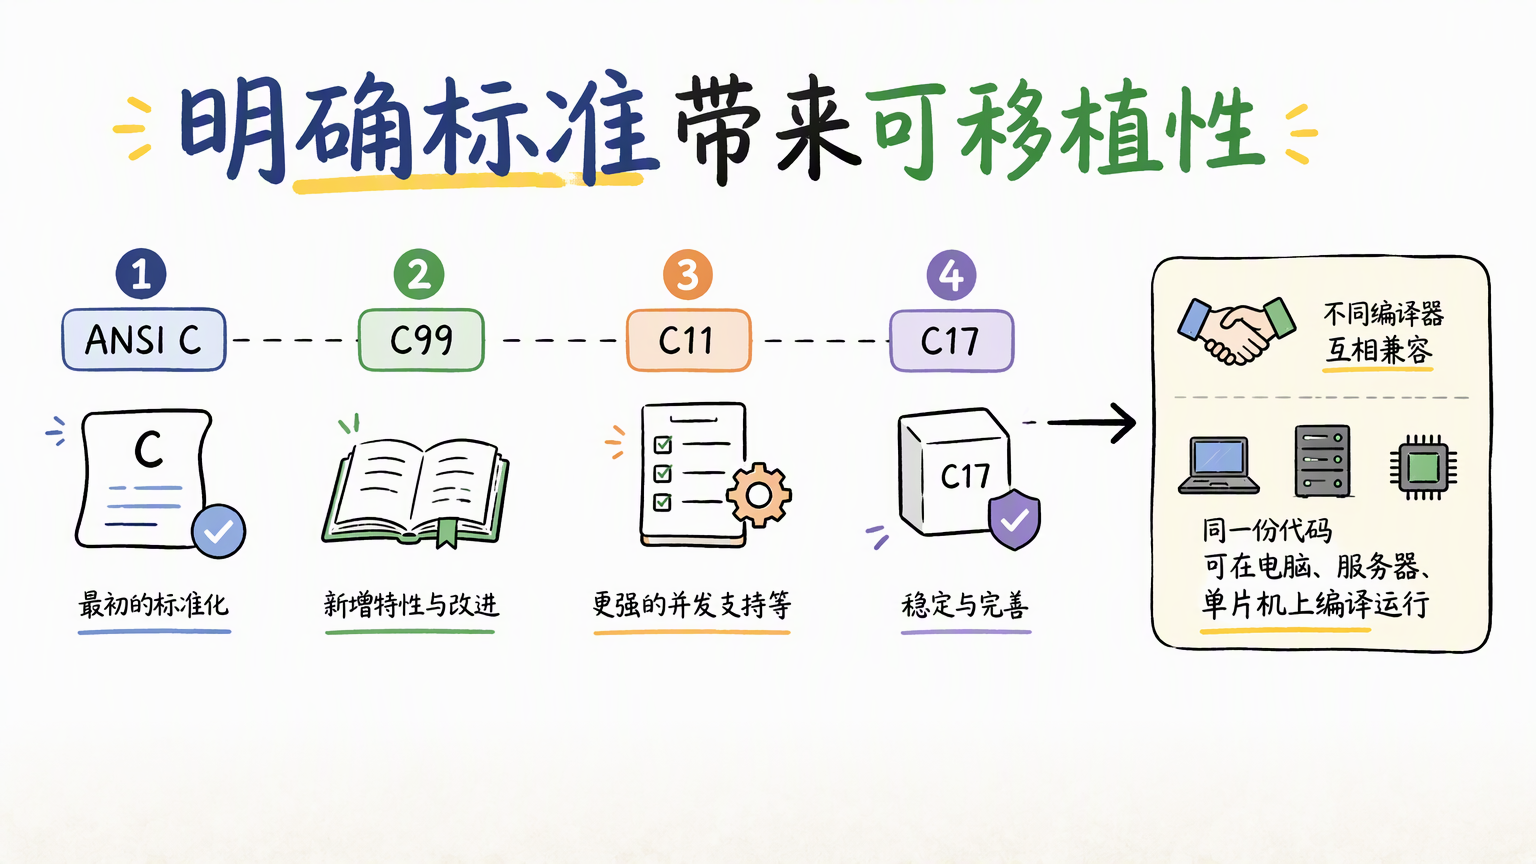
标准带来的可移植性不是“任何代码都能原样运行”。它要求开发者区分三类行为:
- 标准保证的行为:例如
printf等标准库接口的约定,通常可以放心依赖。 - 实现定义的行为:由编译器或目标平台选择,并需要在文档中说明,例如某些整数类型的具体表示。
- 未定义行为:标准不作保证,例如访问数组边界之外的元素;编译器可以基于“这不会发生”的假设进行优化。
因此,C 的可移植性来自“遵守标准并隔离平台差异”,不是来自忽略平台差异。真正的工程代码还要通过编译器警告、测试和目标平台验证。
C 代码为什么要先编译再运行?
C 通常采用编译执行方式:源代码先被翻译成目标平台的机器指令,生成可执行文件;程序运行时,操作系统直接加载这份结果,不必每次重新解析全部源代码。
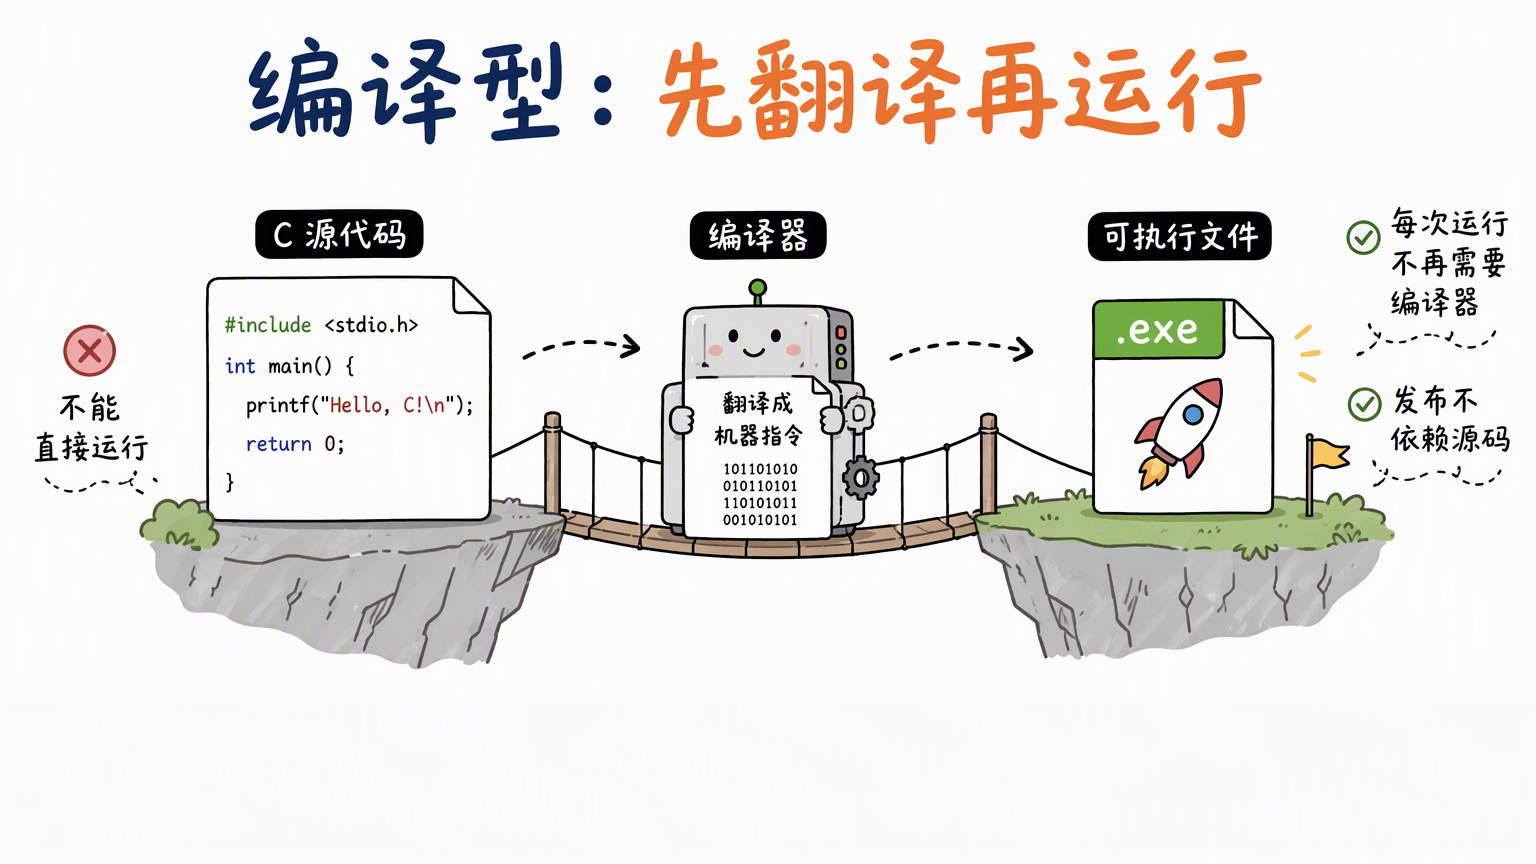
这带来三项直接结果:
- 运行时开销可控:很多检查和翻译工作在构建阶段完成。
- 发布边界清楚:可以发布可执行文件和依赖库,不必暴露完整源码。
- 错误暴露更早:语法错误、部分类型错误和未声明函数等问题通常在编译时报告。
编译并不等于程序一定正确。越界、空指针、数据竞争和权限错误仍可能通过编译,必须靠测试、静态分析和运行时工具继续检查。
C 的静态类型和过程式编程是什么意思?
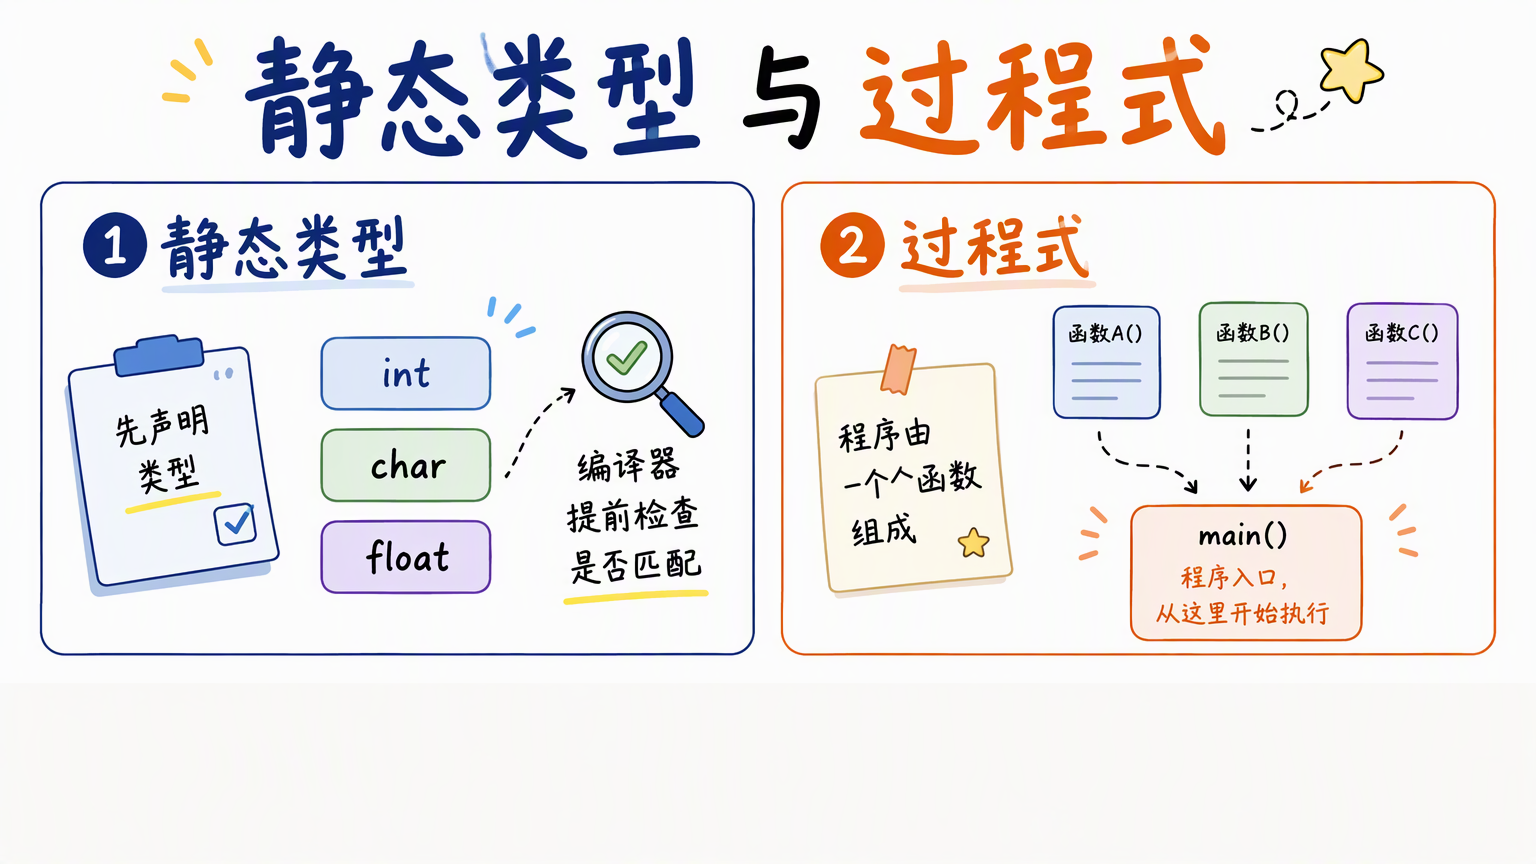
C 是静态类型语言:变量和函数在编译阶段就有确定的类型,编译器可以检查许多不匹配。它也是过程式语言:程序通常由一组函数组成,从 main 函数进入,再按调用关系执行。
#include <stdio.h>

int add(int a, int b) {
    return a + b;
}

int main(void) {
    int result = add(20, 22);
    printf("%d\n", result);
    return 0;
}
add 明确接收两个 int 并返回一个 int。如果调用方把不兼容的值传入,编译器可能直接发出诊断。类型系统能减少一部分错误,但不会替你验证网络数据、业务规则或文件内容。
C 指针到底是什么?
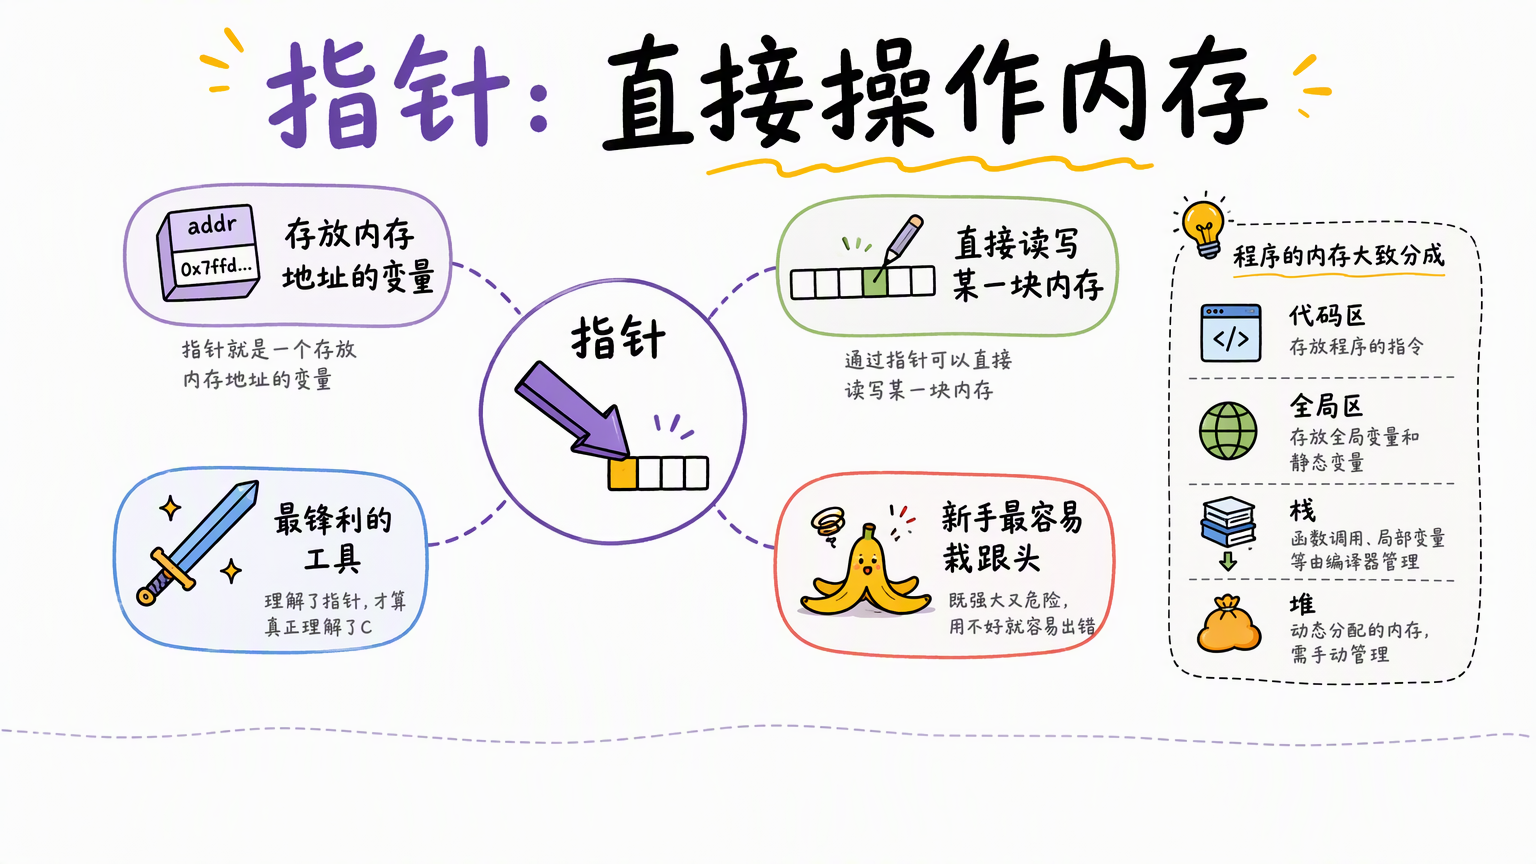
指针是保存内存地址的变量。 普通变量保存一个值,指针保存“这个值放在什么位置”。通过解引用运算符 *,程序可以访问该地址上的对象;通过取地址运算符 &,程序可以得到对象的地址。
int count = 3;
int *p = &count;

*p = 4;  // 通过指针修改 count
指针让 C 可以实现数组遍历、字符串、链表、回调函数和系统调用接口。它也把责任交给了程序员:指针必须指向仍然有效的对象,访问必须符合对象的边界和类型规则。空指针、野指针、悬空指针和错误的指针运算,都是常见崩溃和安全漏洞来源。
C 程序的内存通常怎样分区?
不同操作系统和编译器的实际布局会变化,但可以用四个区域建立基础模型:代码区、全局/静态区、栈和堆。
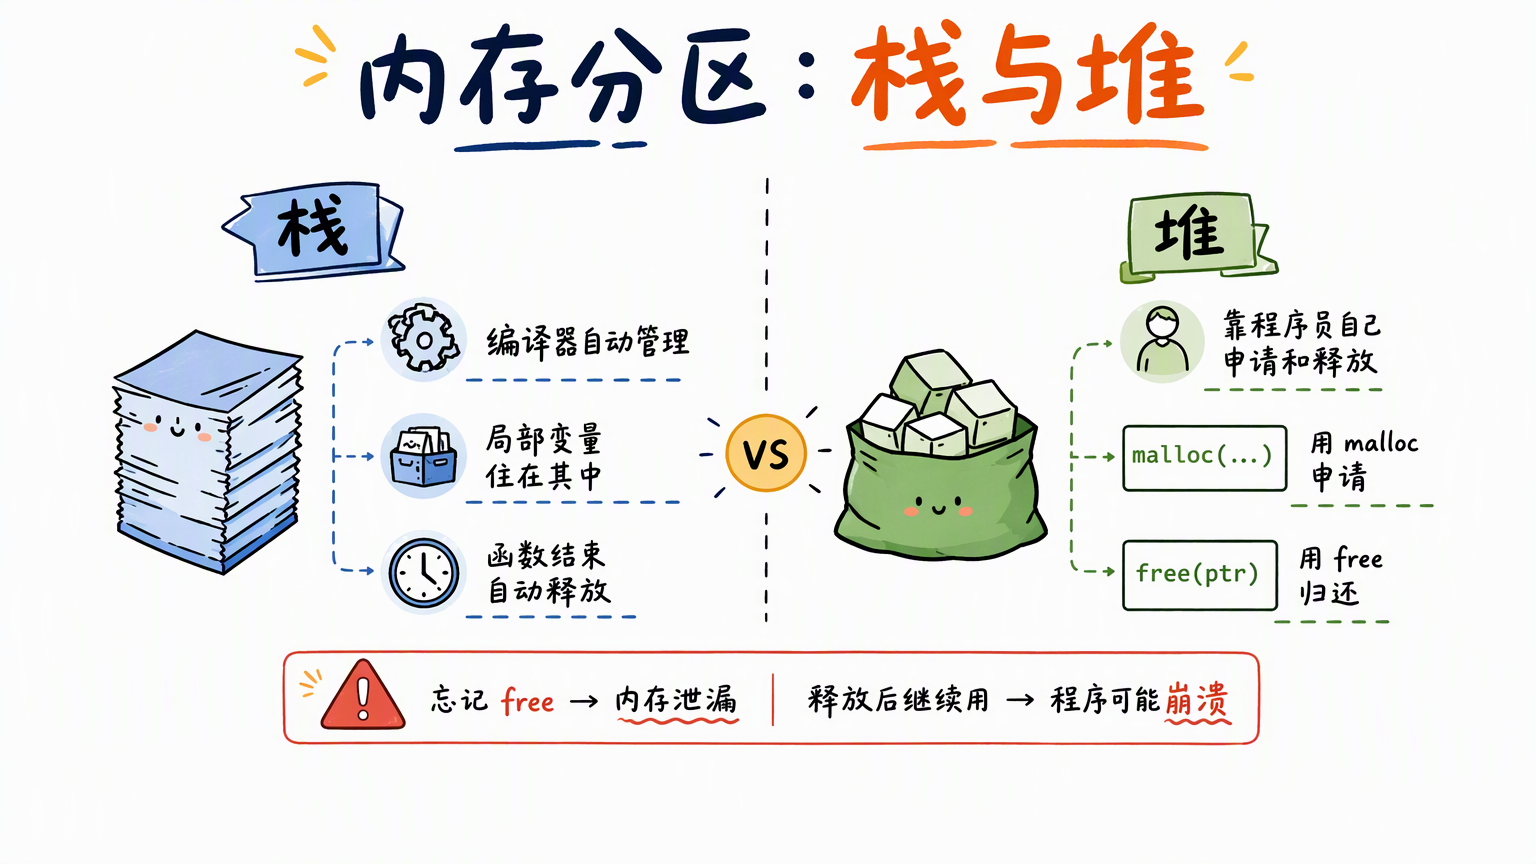
| 区域 | 常见内容 | 生命周期与管理方式 |
|---|---|---|
| 代码区 | 编译后的机器指令 | 由进程加载,通常随进程结束释放 |
| 全局/静态区 | 全局变量、static 变量 | 通常覆盖整个进程生命周期 |
| 栈 | 函数参数、局部变量、调用帧 | 函数进入时建立,返回时自动回收 |
| 堆 | 动态申请的对象 | 用 malloc/calloc 申请,用 free 释放 |
int *numbers = malloc(3 * sizeof *numbers);
if (numbers != NULL) {
    numbers[0] = 10;
    free(numbers);
    numbers = NULL;
}
上例把数组放在堆上,并在不再使用时释放。忘记 free 可能造成内存泄漏;释放后继续使用可能造成悬空指针;申请大小计算错误则可能导致越界。C 没有内置垃圾回收,资源生命周期需要由设计、代码审查和工具共同保证。
C 语言的构建流程有哪四步?
一个典型的 GCC 构建过程可以拆成预处理、编译、汇编和链接四步。它们共同把多个源文件和库组合成最终程序。
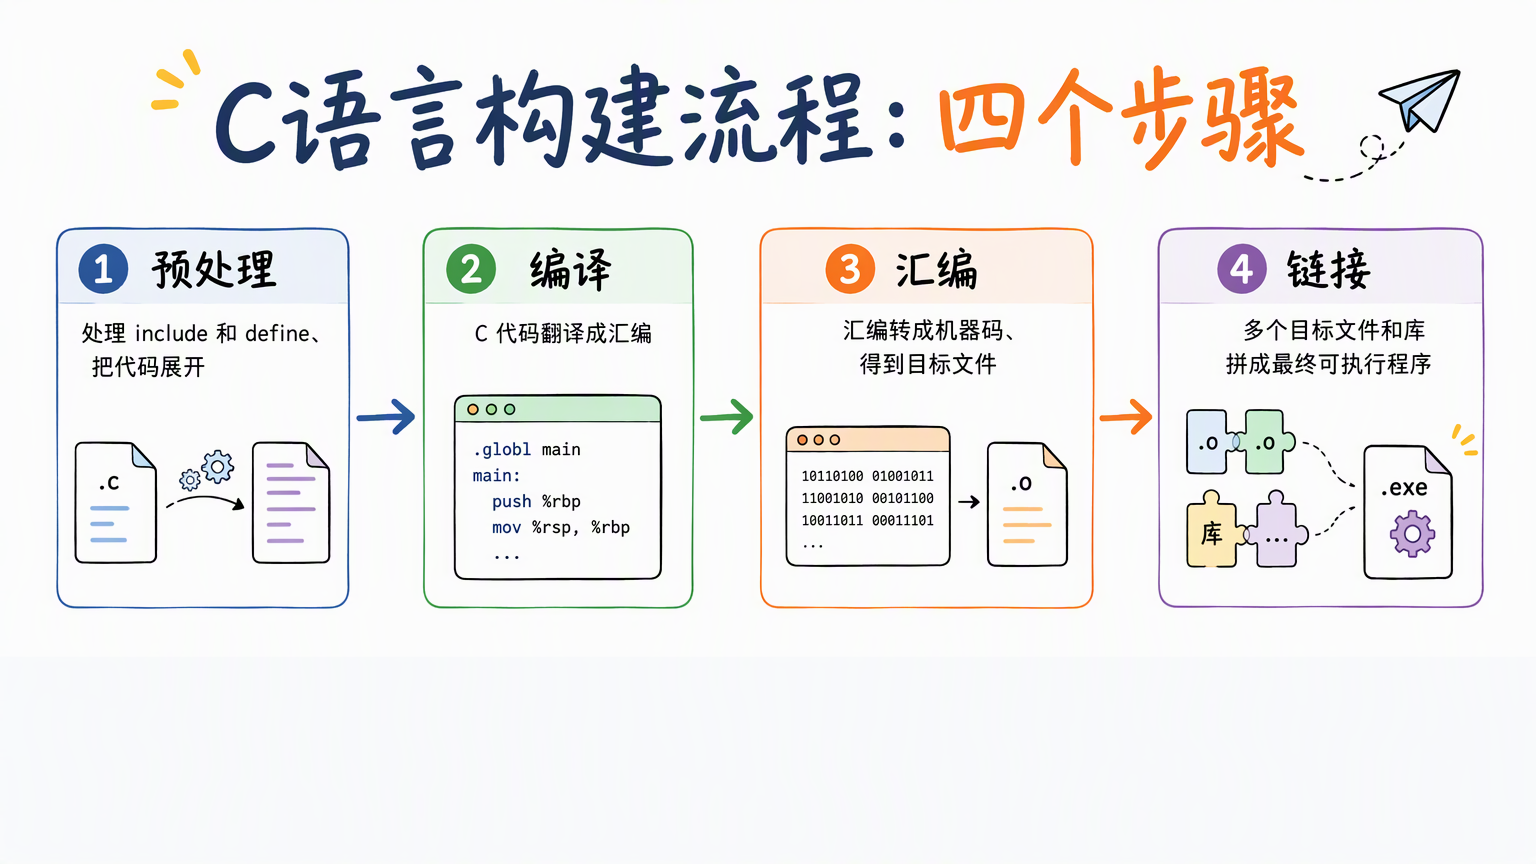
- 预处理:展开
#include、#define和条件编译,生成处理后的源代码。 - 编译:把 C 代码分析并转换为汇编代码,同时报告语法和部分类型问题。
- 汇编:把汇编指令转换成目标文件中的机器码。
- 链接:把多个目标文件和库拼接起来,解析函数、变量的引用,生成可执行文件或库。
例如,下面的命令要求 GCC 使用 C17 标准、打开常见警告,并生成名为 hello 的程序:
gcc -std=c17 -Wall -Wextra -O2 main.c -o hello
./hello
编译器把“翻译工作”提前完成,运行时就可以直接执行产物。但程序仍依赖目标平台的 ABI、操作系统和动态库;把 Linux 上生成的可执行文件直接复制到 Windows,通常不能运行。
一个最小的 C 程序是怎样跑起来的?
下面的程序只做一件事:从 main 开始,调用标准库里的 printf 输出一行文本。
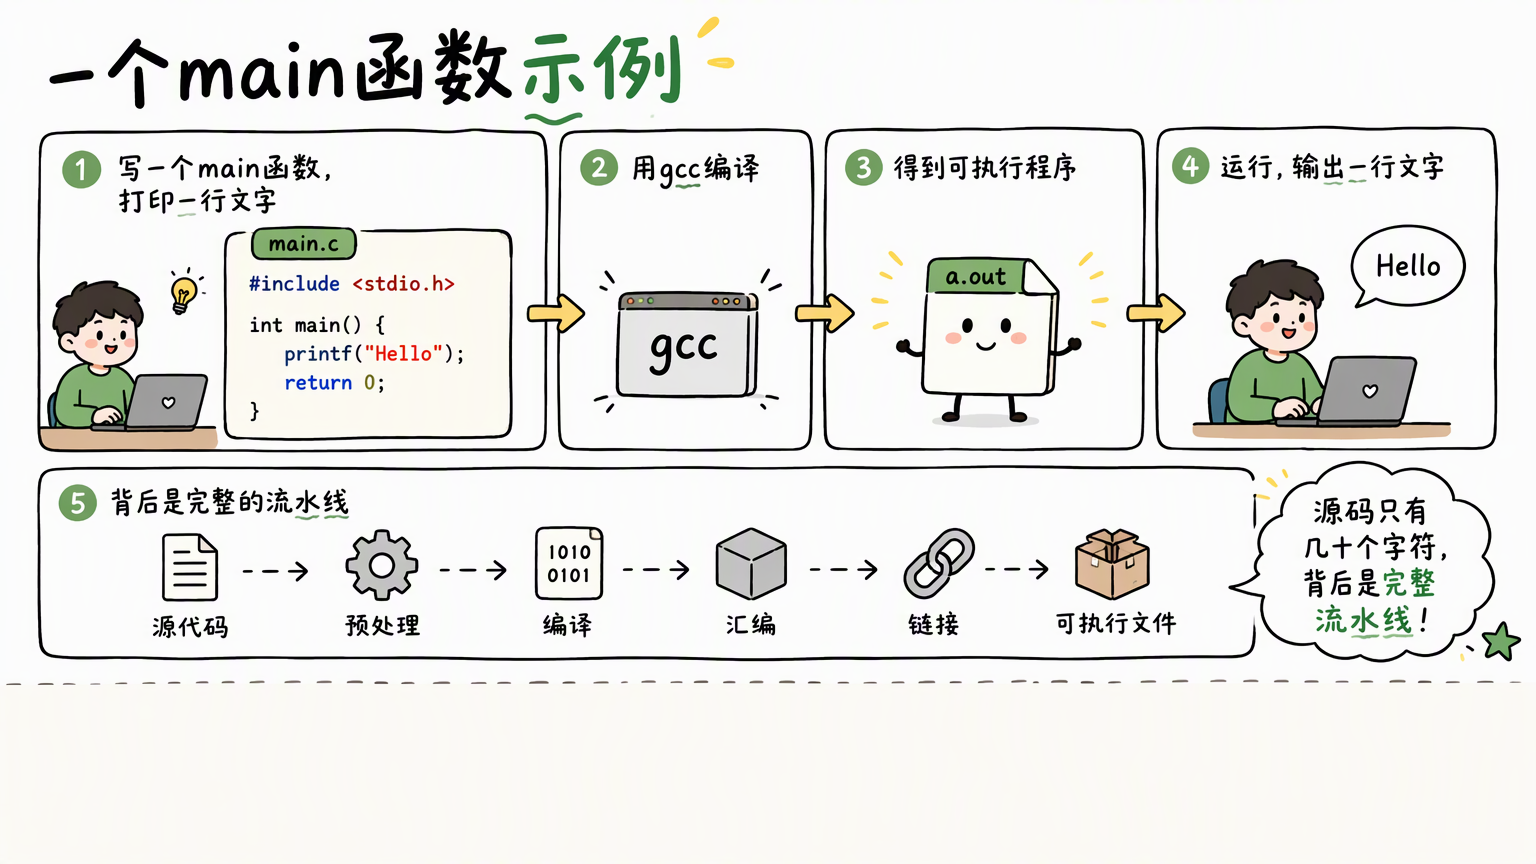
#include <stdio.h>

int main(void) {
    printf("Hello, C!\n");
    return 0;
}
源码只有几十个字符,背后仍会经历完整流水线:stdio.h 在预处理阶段展开,代码被编译和汇编,链接器把 printf 的实现接入程序,操作系统再加载可执行文件并调用 main。理解这个例子,就理解了“源代码、编译器、库、操作系统和 CPU”之间的基本关系。
C 语言今天还用在哪里?
C 仍然适合那些需要小体积、低延迟、确定资源使用方式,或必须直接连接硬件的场景。
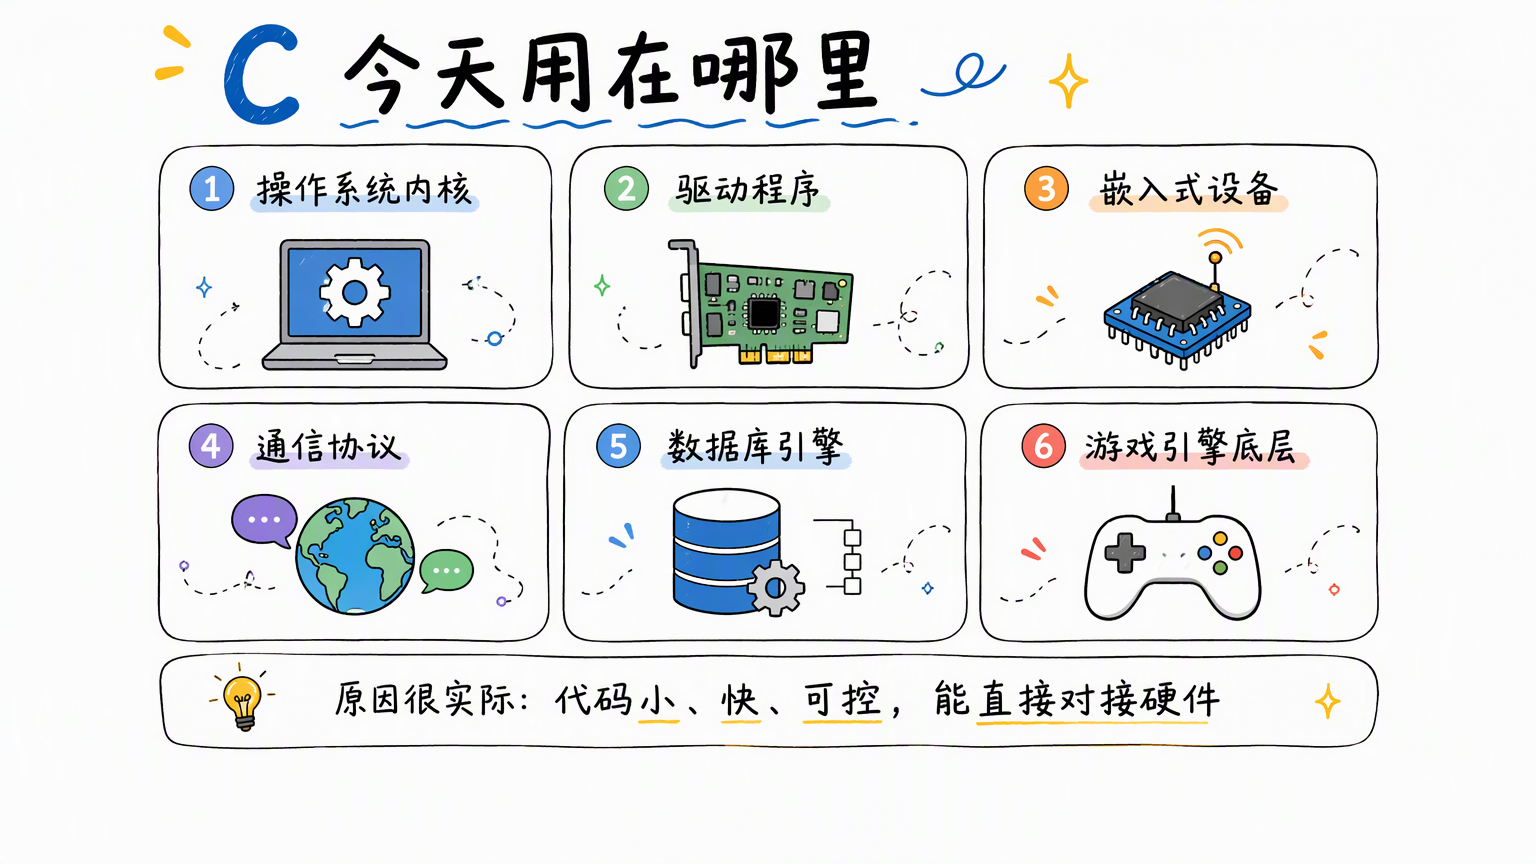
常见使用场景包括:
- 操作系统内核和驱动:处理中断、内存、进程、文件系统和设备寄存器。
- 嵌入式设备:在内存和算力有限的芯片上控制传感器、电机和通信模块。
- 通信协议和基础库:实现网络栈、加密库、压缩库和跨语言接口。
- 数据库和存储引擎:SQLite 等组件需要紧凑的二进制、明确的内存和 I/O 控制。
- 语言运行时和游戏引擎底层:为上层语言或引擎提供对象管理、调度和高性能计算能力。
这些场景的共同点不是“必须使用 C”,而是需要对内存、延迟、二进制布局和平台接口有较强控制力。Rust、C++、Go 等语言也会参与其中,但大量已有系统和 C ABI 让 C 仍然是重要的连接层。
C 语言的代价是什么?
C 把控制权交给程序员,也把与控制权对应的责任交给程序员。它不提供内置垃圾回收,数组边界和很多资源约束也不会自动替你检查。
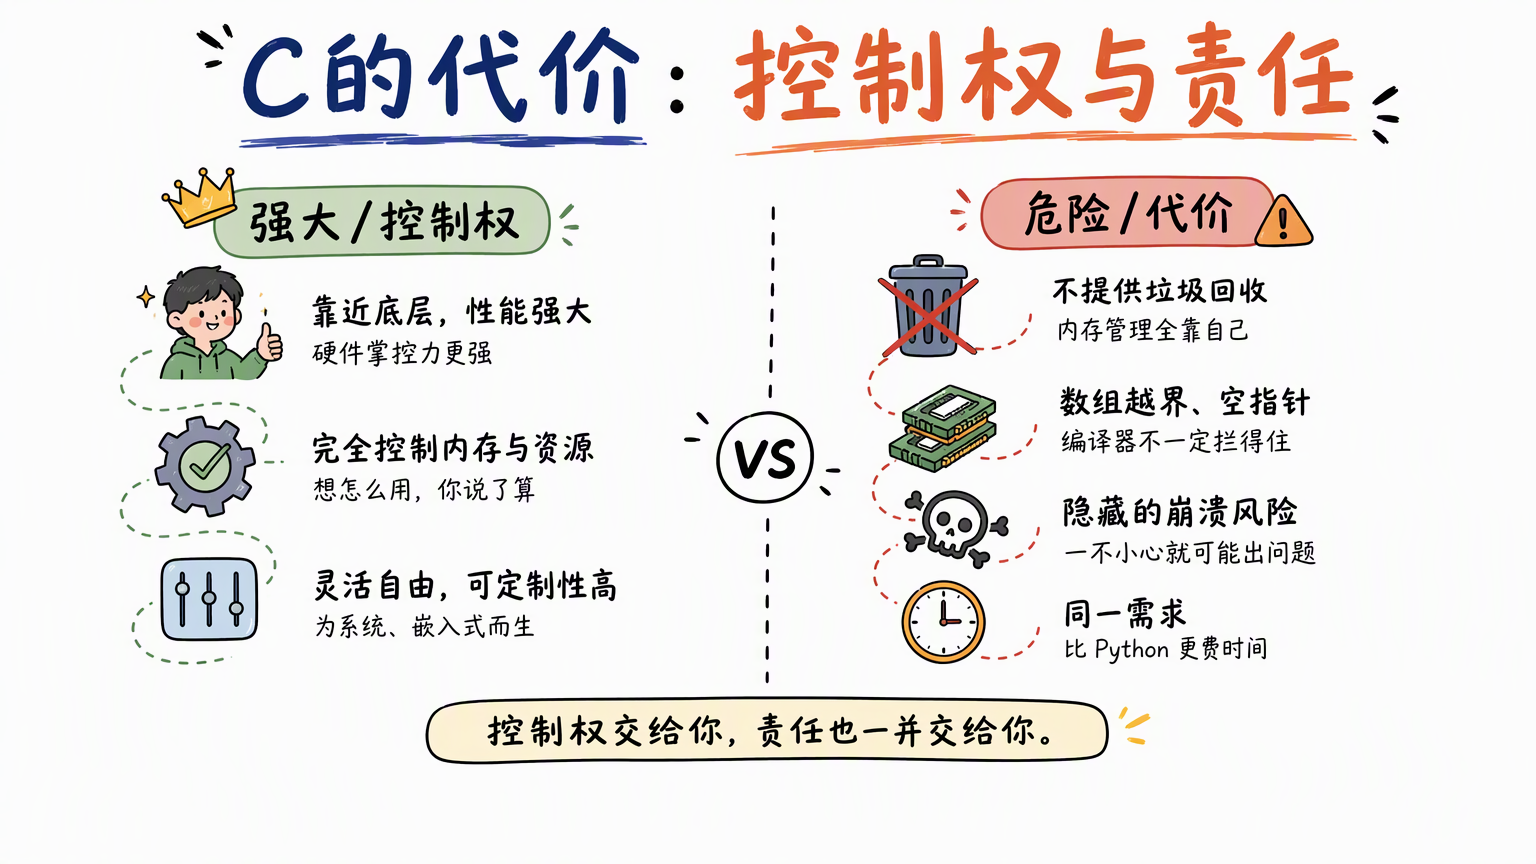
| 优势 | 对应代价 |
|---|---|
| 可以精确控制内存和布局 | 需要自己管理申请、释放和所有权 |
| 生成的代码小、快、可预测 | 优化和性能问题需要开发者理解平台细节 |
| 适合裸机、内核和驱动 | 指针、并发和未定义行为更容易造成崩溃或漏洞 |
| ABI 和工具链成熟 | 旧代码、平台差异和构建配置需要长期维护 |
常见的 C 错误包括数组越界、使用空指针、释放后继续使用、重复释放和整数溢出。工程上通常会结合 -Wall -Wextra、AddressSanitizer、UndefinedBehaviorSanitizer、静态分析和单元测试,尽早发现这些问题。C 的效率来自显式控制,安全性则依赖严谨的约束和验证。
C 语言和 Python、Rust 有什么区别?
三者都能写通用程序,但默认取舍不同:
| 维度 | C | Python | Rust |
|---|---|---|---|
| 执行方式 | 通常编译为本地机器码 | 由解释器或虚拟机执行 | 通常编译为本地机器码 |
| 内存管理 | 手动管理 | 主要由垃圾回收或引用计数机制管理 | 编译期所有权和借用检查 |
| 硬件控制 | 直接,指针和布局可见 | 通过扩展模块或库间接控制 | 直接,同时提供更多编译期安全约束 |
| 上手重点 | 类型、指针、内存和构建 | 语法、库和运行时模型 | 所有权、生命周期和类型系统 |
| 常见优势 | 兼容性、可控性、运行时小 | 开发速度和生态表达力 | 内存安全与接近原生的性能 |
这不是语言排名。需要快速做脚本时,Python 往往更合适;希望在编译期拦截更多内存错误时,Rust 可能更合适;需要接入已有 C ABI、操作系统接口或极小运行时环境时,C 仍然很有价值。
常见问题
C 语言已经 50 多年了,为什么还没有过时?
C 仍然存在,因为操作系统、编译器、驱动、嵌入式芯片和大量基础库需要稳定的 ABI、可预测的资源使用和直接的硬件接口。新语言可以改善安全性或开发体验,但仍经常通过 C ABI 与既有系统连接。
学 C 语言必须先学指针吗?
不必第一天就掌握复杂指针。可以先学习变量、函数、数组和结构体,再理解地址、解引用、数组与指针的关系,最后练习动态内存和函数指针。指针是 C 的核心能力,但应该结合内存模型循序学习。
C 语言是最快的编程语言吗?
不能简单这样说。C 允许生成接近硬件的高效代码,但实际速度还取决于算法、编译器优化、缓存、I/O、并发和数据布局。它提供性能控制能力,不自动保证每个程序都快。
C 语言没有垃圾回收,会不会不安全?
手动内存管理确实增加了内存泄漏、越界和释放后使用的风险。通过明确所有权、限制指针生命周期、使用编译器警告、Sanitizer、静态分析和测试,可以降低风险;如果项目把内存安全放在首位,也应评估 Rust 等替代方案。
C17 和 C23 应该学哪个?
先掌握通用 C 语法、标准库、指针、内存和构建流程,再根据项目工具链选择标准。C17 在现有编译器和教学资料中仍很常见;如果项目明确使用 C23,可以再学习它新增的语法和库能力。写可移植代码时,应以目标编译器实际支持的标准为准。
总结:C 语言为什么仍然是编程的地基?
C 语言是一门诞生于 1972 年、以编译执行、静态类型、过程式组织和显式内存控制为特征的通用编程语言。它的重要性来自三点:离硬件足够近,能控制资源;标准和 ABI 足够成熟,能跨平台重用;生态位置足够底层,承载着操作系统、运行时、数据库和嵌入式软件。
学 C 不只是记住 int、char 或 malloc 的用法,而是理解数据如何进入内存、函数如何被调用、源代码如何变成机器指令,以及抽象如何落到真实设备上。C 没有替你隐藏计算机的承重结构,所以学会它之后,很多现代语言的设计都会变得更容易解释。