
什么是 Ollama?
Ollama 是一个用于下载、运行和管理大语言模型的工具。它把模型文件、推理引擎、硬件加速和本地 API 封装在一起,让用户不必先搭建 Python 环境或手写模型加载代码,就能在 macOS、Windows 和 Linux 上运行模型。
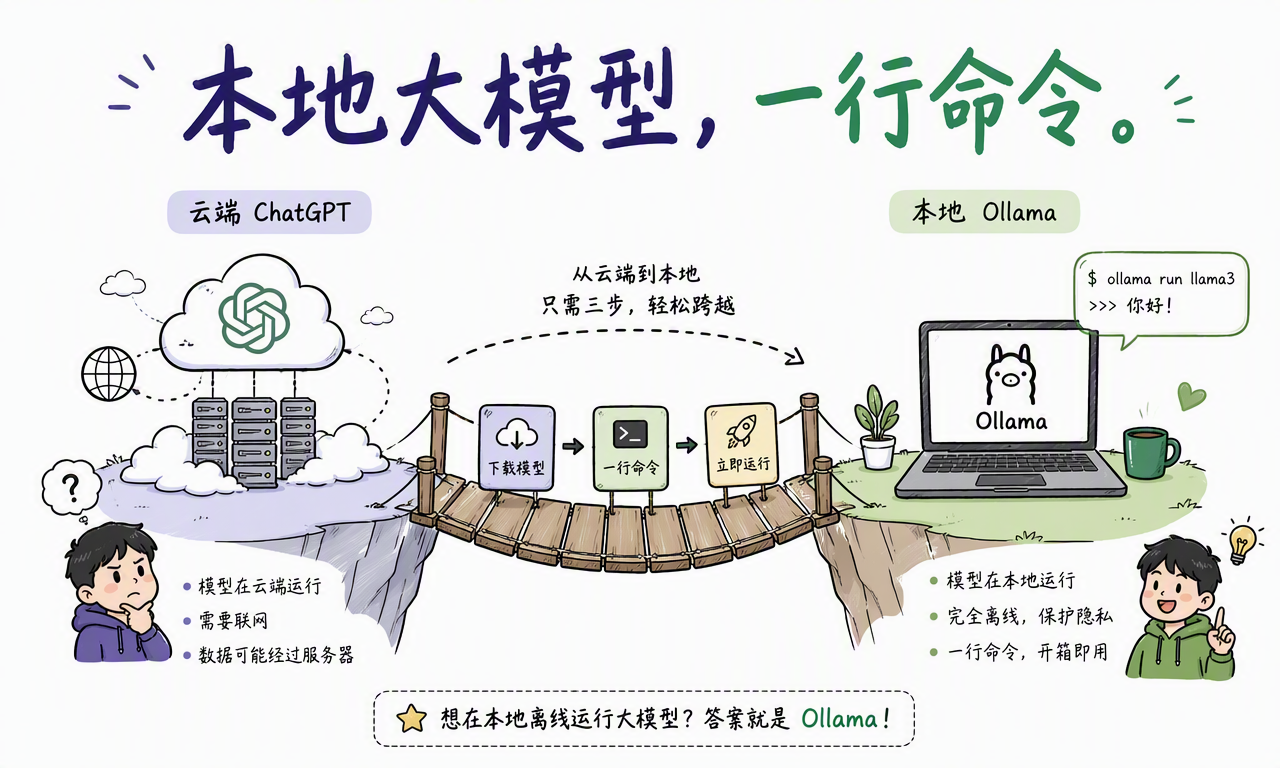
可以把 Ollama 理解成电脑上的“大模型运行时”:输入一个模型名称,它负责下载模型、加载到内存或显存、接收提示词并返回结果。模型可以在终端里直接使用,也可以通过 HTTP API 接入网页、桌面客户端、IDE 或自己的程序。
Ollama 本身不是一个大模型,也不是 ChatGPT 的离线版本。它更接近 Docker 与容器的关系:Ollama 提供统一的运行和管理方式,Llama、Qwen、Gemma、Mistral 等模型才是真正负责理解和生成内容的组件。

一句话总结:Ollama 是本地大模型的运行入口,它把原本分散的下载、量化模型选择、推理和接口服务压缩成少量命令。
Ollama 解决了本地运行大模型的什么问题?
Ollama 主要解决的是本地推理的工程门槛。在这类工具出现之前,开发者通常要自己寻找模型权重、确认模型格式、安装推理依赖、选择量化版本,并处理 CUDA、ROCm、Metal、内存和显存等硬件问题。

传统流程经常包含以下步骤:
- 在 Hugging Face 或项目仓库中寻找正确的模型与授权协议。
- 安装 Python、PyTorch、Transformers 或其他推理框架。
- 根据显存和内存选择 FP16、8-bit、4-bit 或 GGUF 量化版本。
- 配置 GPU 驱动、加速后端和模型加载参数。
- 编写脚本,再处理版本冲突、内存不足和运行速度问题。
Ollama 把这些工作收敛为统一的模型库、命令行工具和后台服务。它特别适合快速验证模型、学习大模型、开发原型,以及为本地 AI 应用提供稳定的推理接口。
不过,“门槛更低”不等于“没有成本”。模型仍然需要磁盘空间和运行内存,参数量越大、上下文越长,占用的资源通常越多;Ollama 简化的是部署过程,不会突破硬件本身的上限。
为什么本地运行大模型值得关注?
本地运行的核心价值是数据控制、离线可用和固定的本机推理环境。使用本地模型时,提示词和回答可以只在当前设备上处理,不必把代码、聊天记录或企业文档发送给外部模型服务。

它带来的变化主要有三点:
- 数据留在本机:适合处理代码、笔记、合同草稿和内部文档,但前提是使用本地模型,并且所连接的应用没有把数据转发到第三方。
- 断网后仍可推理:Ollama 与模型下载完成后,本地模型可以离线运行;首次安装、拉取模型和使用云模型仍需要网络。
- 延迟与成本可控:请求不必经过公网,也没有按 Token 计费,但成本转化为本地硬件、耗电、散热和维护。
Ollama 使用包括 llama.cpp 在内的推理后端,并依据可用硬件把模型加载到 CPU、GPU,或在两者之间分配。可以用 ollama ps 查看模型当前实际使用的处理器比例。
本地运行也不应被绝对化。复杂推理、超长上下文或大规模并发通常更适合有充足 GPU 的服务器或云服务;笔记本更适合小参数量、经过量化的模型和个人工作负载。
如何安装 Ollama 并用一行命令运行模型?
安装 Ollama 后,执行 ollama run llama3.2 就能完成缺失模型的下载并进入对话。第一次运行需要联网下载模型,之后可以离线再次启动。
官方提供的安装命令如下:
macOS 或 Linux
curl -fsSL https://ollama.com/install.sh | sh
Windows PowerShell
irm https://ollama.com/install.ps1 | iex
安装完成后,运行一个适合普通电脑入门的模型:
ollama run llama3.2
如果模型尚未下载,run 会先拉取模型,再打开交互式终端。因此,“一行命令运行大模型”并不是跳过了下载,而是把下载与启动合并进同一条命令。
Ollama 的工作流程是什么?
Ollama 的核心流程可以拆成三步:获取模型、运行推理、通过接口提供能力。

- 获取模型:
ollama pull llama3.2从模型库下载指定模型。模型名称后的标签可以区分参数规模、版本或量化方案。 - 运行模型:
ollama run llama3.2加载模型并进入对话;如果本地没有该模型,会自动先执行下载。 - 调用接口:Ollama 启动本地服务后,应用可以通过原生 API、官方 Python/JavaScript 库或部分 OpenAI 兼容接口发起请求。
常用的模型管理命令如下:
| 命令 | 作用 | 典型场景 |
|---|---|---|
ollama run llama3.2 | 下载缺失模型并开始对话 | 第一次体验模型 |
ollama pull llama3.2 | 只下载或更新模型 | 提前准备离线环境 |
ollama list | 查看本地已有模型 | 检查磁盘中的模型 |
ollama ps | 查看正在运行的模型及 CPU/GPU 比例 | 排查资源占用 |
ollama stop llama3.2 | 停止模型并释放运行资源 | 不再需要当前模型 |
ollama rm llama3.2 | 删除本地模型 | 释放磁盘空间 |
Ollama 默认会把 API 监听在本机的 127.0.0.1:11434。这个默认值意味着同一台电脑上的程序可以访问服务,而局域网中的其他设备默认不能直接访问。
如何通过 Ollama API 调用本地模型?
Ollama 提供原生 REST API,默认基础地址是 http://localhost:11434/api。例如,下面的请求会调用本地聊天接口:
curl http://localhost:11434/api/chat -d '{
  "model": "llama3.2",
  "messages": [
    { "role": "user", "content": "用一句话解释什么是 RAG" }
  ],
  "stream": false
}'
Ollama 还兼容 OpenAI API 的一部分接口。已有应用可以把客户端的 base_url 改为 http://localhost:11434/v1/,再使用本地模型名称:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:11434/v1/",
    api_key="ollama",
)

response = client.chat.completions.create(
    model="llama3.2",
    messages=[
        {"role": "user", "content": "解释这段函数的时间复杂度"}
    ],
)

print(response.choices[0].message.content)

这里要注意“兼容一部分”这个边界。OpenAI 的客户端格式、Chat Completions、Responses 等常用能力可以降低迁移成本,但 Ollama 并不承诺覆盖 OpenAI 平台的每个端点和每项云端能力。迁移现有应用时,仍应逐项验证流式输出、工具调用、结构化输出和多模态输入。
如何用 Modelfile 定制 Ollama 模型?
Modelfile 是 Ollama 的模型配置文件,可以指定基础模型、系统提示词、模板和推理参数。它适合创建可重复使用的模型配置,而不是每次调用时重新拼接一长段提示词。

下面创建一个回答简洁、优先指出风险的代码审查助手:
FROM llama3.2

PARAMETER temperature 0.2

SYSTEM """
你是一名代码审查助手。先报告会导致错误、安全问题或数据丢失的风险,
再给出最小修改建议;没有证据时不要猜测。
"""
把内容保存为 Modelfile 后执行:
ollama create code-reviewer -f Modelfile
ollama run code-reviewer
Modelfile 不等于训练模型,也不能任意“拼接”多个基础模型。它主要定义运行配置;需要加入领域能力时,可以导入兼容模型或应用在对应基础模型上训练的适配器,但基础模型、适配器与许可证必须相互匹配。
Ollama 适合哪些实际场景?
Ollama 适合数据不方便外发、需要离线运行、请求规模不大,或需要快速切换模型的个人与开发场景。它常被用作知识库、编程助手、模型评测和边缘应用的推理后端。
场景一:个人知识库问答
把 Ollama 连接到 AnythingLLM、Open WebUI 或 RAG 应用,可以让本地模型基于笔记、项目资料和内部文档回答问题。

一个完整的本地知识库不只有 Ollama,还包括文档解析、文本切分、Embedding、向量存储和检索。若其中任何一步调用云端服务,数据仍可能离开设备。因此,“本地 Ollama”不自动等于“整条 RAG 链路都在本地”。
场景二:本地辅助编程
Continue 等编辑器扩展可以把 Ollama 作为模型提供方,用于解释代码、生成测试、重构小函数和对话式开发。

本地编程助手可以避免把未公开代码直接发送给外部模型服务,但输出质量取决于所选模型、上下文长度和项目规模。小模型适合局部代码任务;跨文件重构、复杂 Agent 工作流和大型代码库理解通常需要更强模型与更多内存。
场景三:模型评测与学习
Ollama 可以让多个模型共享相似的运行入口,适合比较同一批提示词在不同模型上的表现。有效评测不应凭一次对话打分,而应固定模型版本、量化类型、硬件、上下文和采样参数,再记录正确率、延迟、内存占用与人工评价标准。
例如,比较两个模型的代码解释能力时,可以准备 20 个包含边界条件的函数,让模型输出“功能、复杂度、潜在错误”三项结果,再由同一套评分规则检查。这样得到的结论才比主观印象更可复现。
场景四:边缘设备和小型服务器
Ollama 提供 Linux ARM64 支持,因此可以部署在部分 ARM 设备、小型服务器和家庭实验环境中,作为局域网内的推理后端。

边缘设备更适合小参数量、低并发任务。能否运行与是否实用是两个问题:模型即使能在 CPU 上加载,也可能生成很慢;树莓派等设备还要考虑内存、散热、存储速度和电源稳定性。
Ollama、本地手动部署和云端 API 怎么选?
Ollama 适合优先考虑本地控制与快速启动的开发者;手动部署适合需要深度定制推理栈的团队;云端 API 适合追求模型能力、弹性并发和低运维投入的应用。
| 维度 | Ollama 本地运行 | 手动搭建本地推理 | 云端模型 API |
|---|---|---|---|
| 上手门槛 | 低,命令和 API 统一 | 高,需要配置模型、依赖与服务 | 低,申请密钥后调用 |
| 数据路径 | 可只在本机处理 | 可完全自控 | 请求通常发送到服务商 |
| 硬件要求 | 使用本机 CPU/GPU 和内存 | 自备并自行优化硬件 | 客户端几乎无推理硬件要求 |
| 模型与参数控制 | 覆盖常用选项,控制粒度适中 | 控制最细,可更换后端和编译参数 | 取决于服务商开放范围 |
| 并发扩展 | 受单机资源限制 | 可自建多卡和集群,但维护复杂 | 通常更容易弹性扩展 |
| 成本结构 | 硬件、电力、磁盘和维护 | 硬件与较高工程维护成本 | 按 Token、请求或订阅计费 |
| 适合场景 | 个人使用、原型、离线与私有数据 | 性能优化、专用部署、平台建设 | 大模型能力、线上高并发、快速上线 |
三种方案可以组合。例如,开发阶段使用 Ollama 快速验证流程,生产环境根据并发、合规和模型质量要求,再选择自建 GPU 服务或云端 API。
选择本地模型时要看哪些硬件条件?
选择模型时,最重要的不是追求最大的参数量,而是让模型、上下文和运行时缓存适配可用内存或显存。模型下载文件的大小也不等于运行时的全部占用。
可以用下面的经验范围做第一次选择:
| 设备资源 | 建议起点 | 说明 |
|---|---|---|
| 8 GB 内存 | 1B~4B 的量化模型 | 关闭高占用程序,使用较短上下文;速度取决于 CPU/GPU |
| 16 GB 内存 | 3B~8B 的量化模型 | 适合聊天、摘要和局部代码任务,是常见入门配置 |
| 32 GB 及以上 | 8B~14B 或更大模型 | 仍要为系统、上下文缓存和并发请求预留空间 |
| 独立 GPU | 优先选择能放入显存的模型 | 完整放入 GPU 通常更快,超出显存后可能部分转到系统内存 |
这些范围不是硬性保证。量化类型、上下文长度、模型架构、操作系统、并发数和推理后端都会改变实际占用。最可靠的办法是从小模型开始,用 ollama ps 和系统监控观察真实资源,再逐步升级。
Ollama 有哪些限制和常见误区?
Ollama 降低了本地推理门槛,但不能自动保证模型质量、安全性或生产可用性。
| 限制或误区 | 实际问题 | 建议 |
|---|---|---|
| 本地一定完全私密 | 云模型、Web 搜索、远程 Embedding 或第三方插件仍可能传输数据 | 核对整条调用链;需要时设置 OLLAMA_NO_CLOUD=1 |
| 模型越大越好 | 大模型可能无法装入内存,速度也可能无法接受 | 先按任务和硬件选择小模型,再用评测决定是否升级 |
| 量化没有损失 | 更低位量化通常会以一定精度换取更小体积 | 对真实任务做准确率与稳定性测试 |
| OpenAI API 完全兼容 | Ollama 只兼容部分接口与参数 | 对流式、工具调用和结构化输出做集成测试 |
| 本地 API 可以直接暴露公网 | 默认本机接口不是完整的公网鉴权网关 | 保持本机监听;远程访问时增加认证、TLS 和访问控制 |
| 本地模型回答就可信 | 模型仍会产生事实错误、过时代码和虚构内容 | 对关键结论检索来源,并保留人工复核 |
| 安装后就能跑任意模型 | 磁盘、内存、显存和模型许可证仍有限制 | 下载前查看模型大小、标签、许可和硬件需求 |
Ollama 官方说明,本地运行时不会把提示词和答案发送回 Ollama;但如果选择其云模型,内容会由云端处理。需要严格离线或隔离环境时,应关闭云功能,并实际测试断网后的完整工作流。
常见问题
Ollama 是免费的吗?
Ollama 项目本身采用 MIT 许可证,可以免费安装和使用。通过 Ollama 下载的模型有各自的许可证和使用限制,商业使用前需要分别检查模型条款;本地运行产生的硬件、电力和维护成本也仍然存在。
Ollama 必须使用 GPU 吗?
不必须。Ollama 可以使用 CPU 推理,也能在受支持的 Apple、NVIDIA、AMD 等硬件上使用 GPU 加速。CPU 通常可以运行小模型,但生成速度往往低于合适的 GPU。
Ollama 可以完全离线使用吗?
可以,但要先安装 Ollama 并下载本地模型。完成下载后,本地聊天和本地 API 可以断网运行;云模型、Web 搜索和依赖在线服务的插件不能离线使用。
Ollama 和 llama.cpp 有什么区别?
llama.cpp 是底层推理项目,重点是高效运行模型并提供细粒度参数;Ollama 使用包括 llama.cpp 在内的后端,在其上增加模型下载、版本管理、跨平台应用、调度和统一 API。需要快速使用时选 Ollama,需要深度控制编译与推理细节时可以直接使用 llama.cpp。
Ollama 和 ChatGPT 有什么区别?
Ollama 是模型运行与管理工具,ChatGPT 是由 OpenAI 提供的云端 AI 产品。Ollama 可以运行多种本地或云模型,实际能力取决于所选模型和硬件;ChatGPT 的模型、工具、账号和基础设施由 OpenAI 统一提供。
Ollama 下载的模型存在哪里?
默认情况下,macOS 模型位于 ~/.ollama/models,Linux 标准安装位于 /usr/share/ollama/.ollama/models,Windows 位于 C:\Users\%username%\.ollama\models。可以通过 OLLAMA_MODELS 环境变量更改存储位置。
总结:Ollama 是本地大模型的统一运行入口
Ollama 把模型获取、推理、硬件调度、命令行对话和本地 API 封装为一套统一体验。安装完成后,一条 ollama run llama3.2 就可以下载缺失模型并开始对话,这正是它降低本地大模型门槛的关键。

它最适合个人知识库、辅助编程、模型学习、离线工具和小规模本地应用。它不替代模型本身,也不自动解决硬件限制、输出准确性、许可证、权限和生产扩展问题。
理解 Ollama 的关键,是把它看成“大模型运行时”,而不是又一个聊天机器人。当模型名称、运行命令和 API 地址成为稳定接口时,开发者就能把注意力从环境配置转回模型选择与应用设计。