什么是正则表达式
正则表达式(Regular Expression,常缩写为 regex)是一门用来描述“文本长什么样”的小语言:用一串符号写出一条规则,再让程序拿这条规则去文本里找符合的部分。
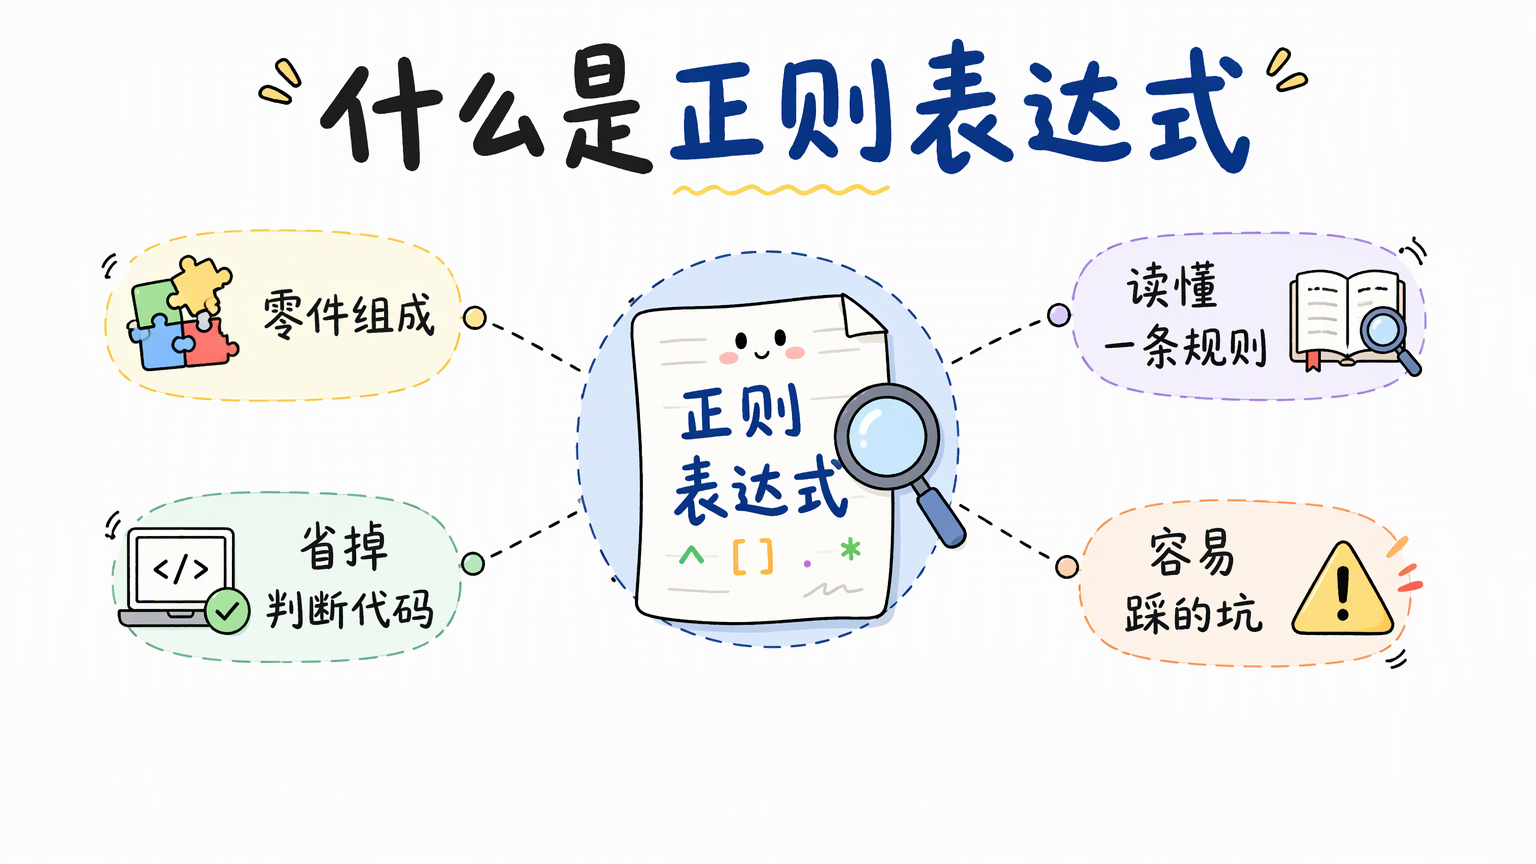
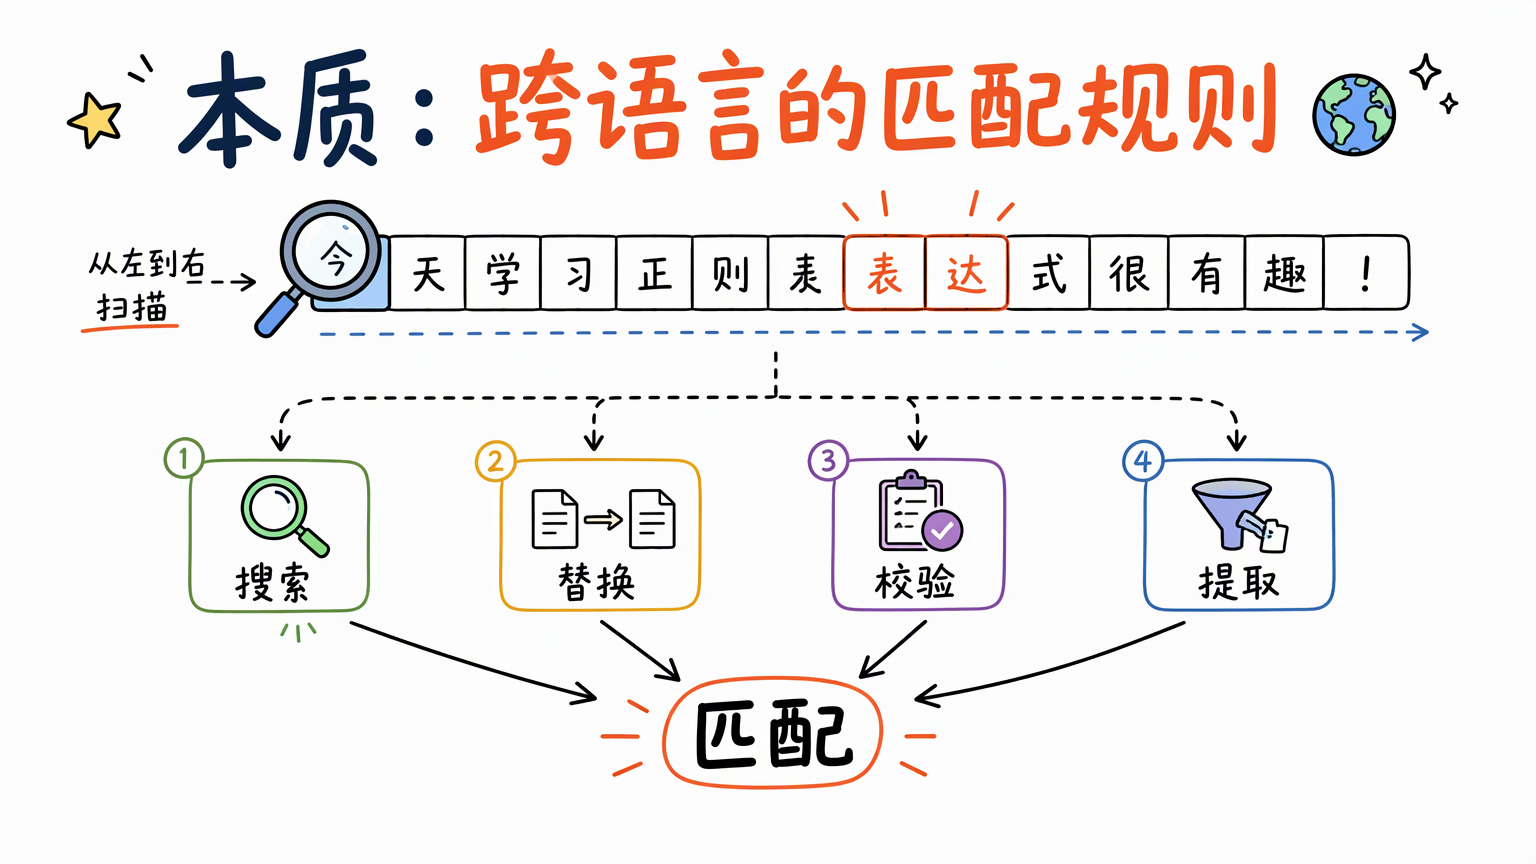
它不是某个软件或某门语言的专利,而是一套跨语言的文本匹配规则。你给它一段模式,它就在字符串里从左到右扫描,找到匹配的位置。
所以它的核心动作只有一个,就是匹配。搜索、替换、校验、提取,全都是围绕匹配衍生出来的用法。
为什么需要它:一条规则替代一堆判断
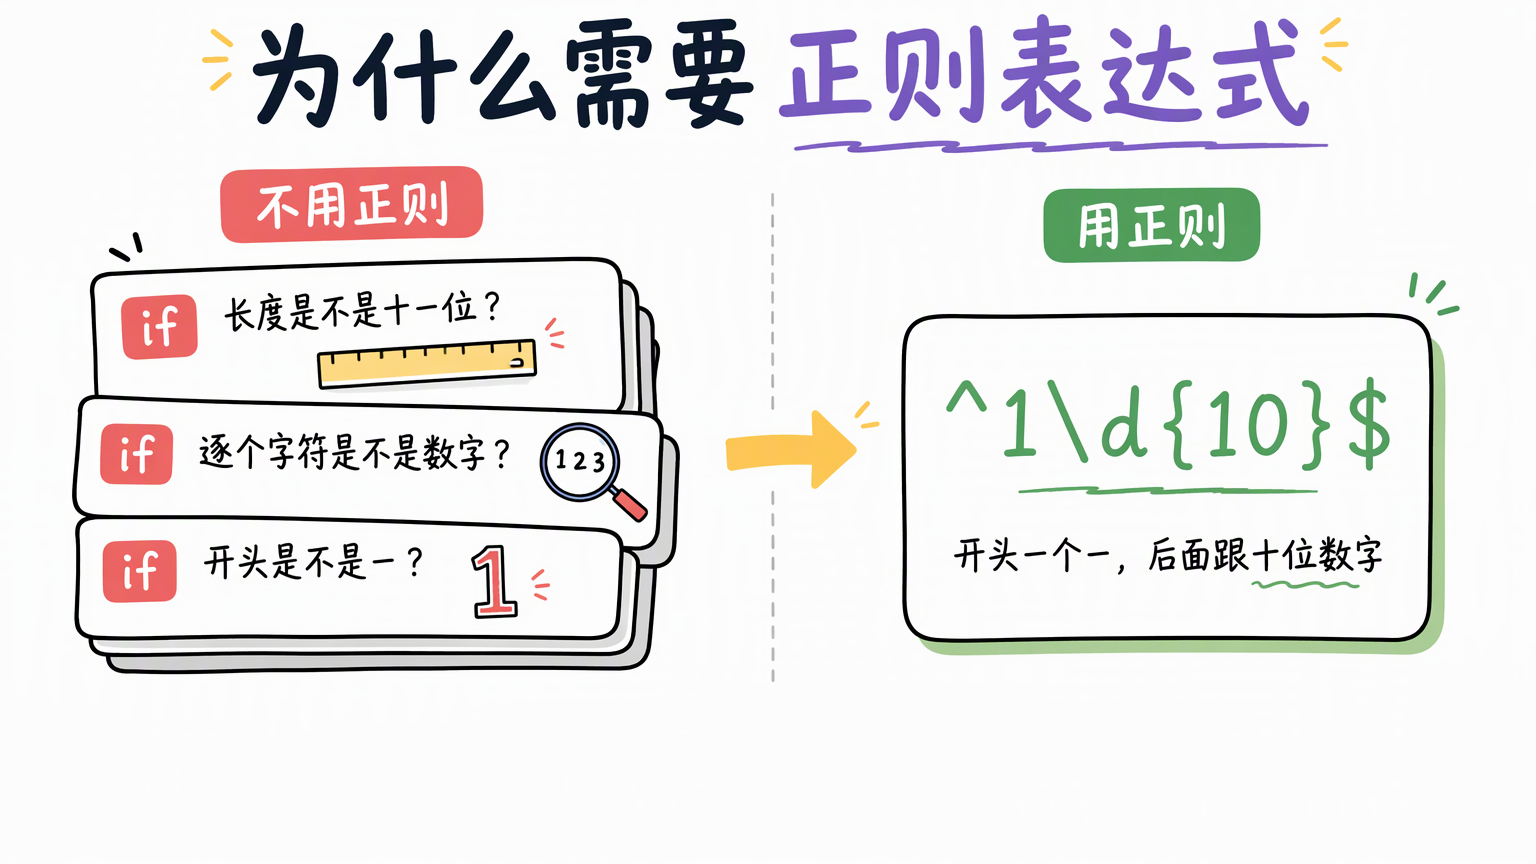
要检查用户输入的是不是手机号,不用正则,得先判断长度是不是十一位,再逐个字符判断是不是数字,再判断开头是不是一。写成代码就是一堆 if 判断。
用正则,一条规则就写完了:开头一个一,后面跟十位数字。规则本身就接近人能读懂的描述,改起来也只要改这一处。
核心机制:四类零件拼出一条规则
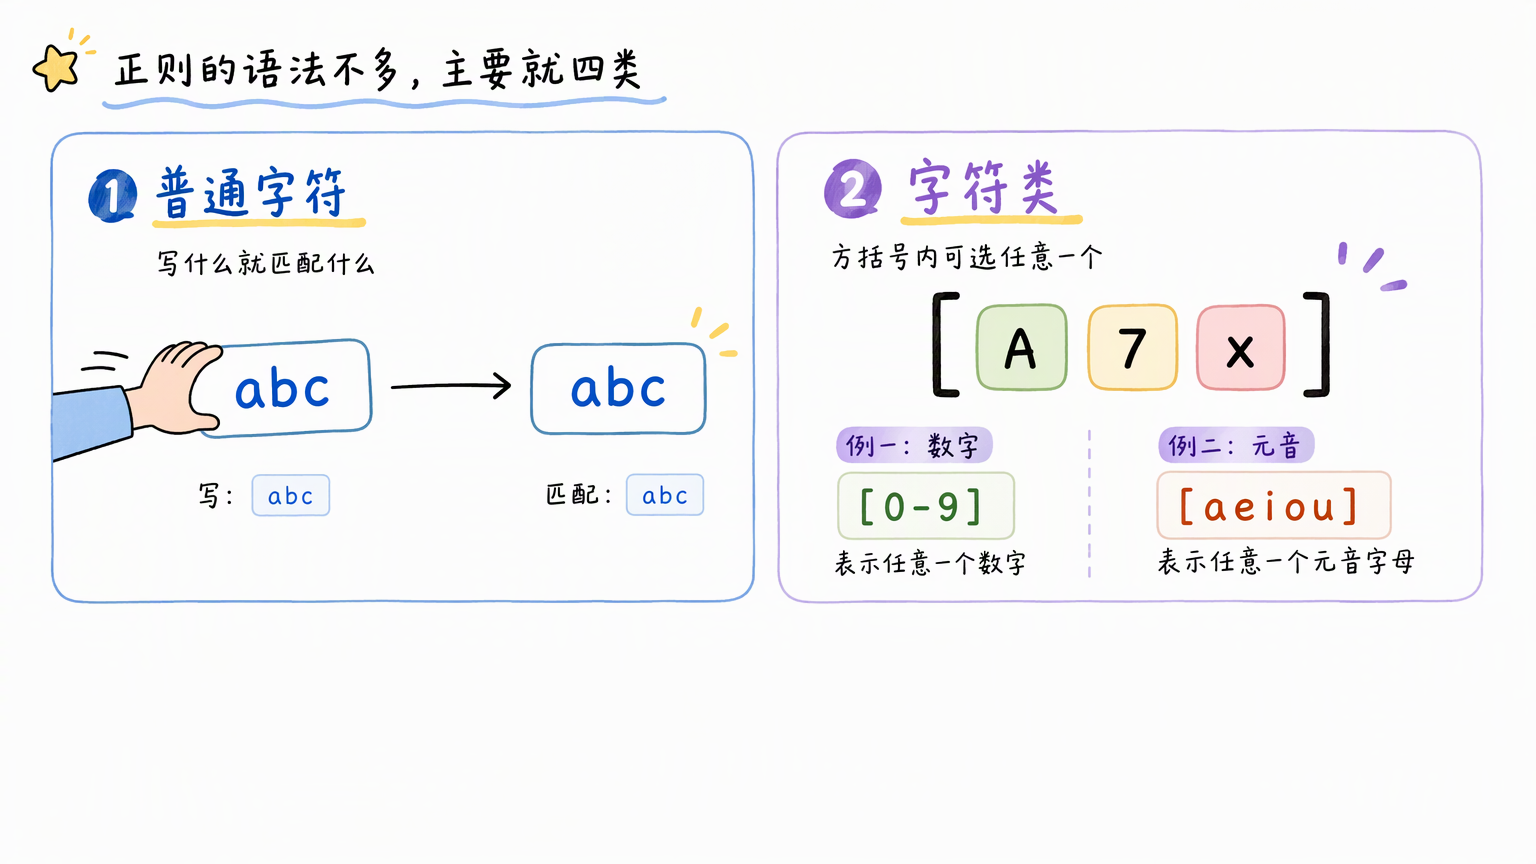
正则的语法不多,主要就四类零件。
- 普通字符:写什么就匹配什么,比如写 abc 就去找 abc。
- 字符类:用方括号表示“这一位可以是其中任意一个”。方括号里写 0 到 9,表示任意一个数字;方括号里写几个元音字母,表示任意一个元音。
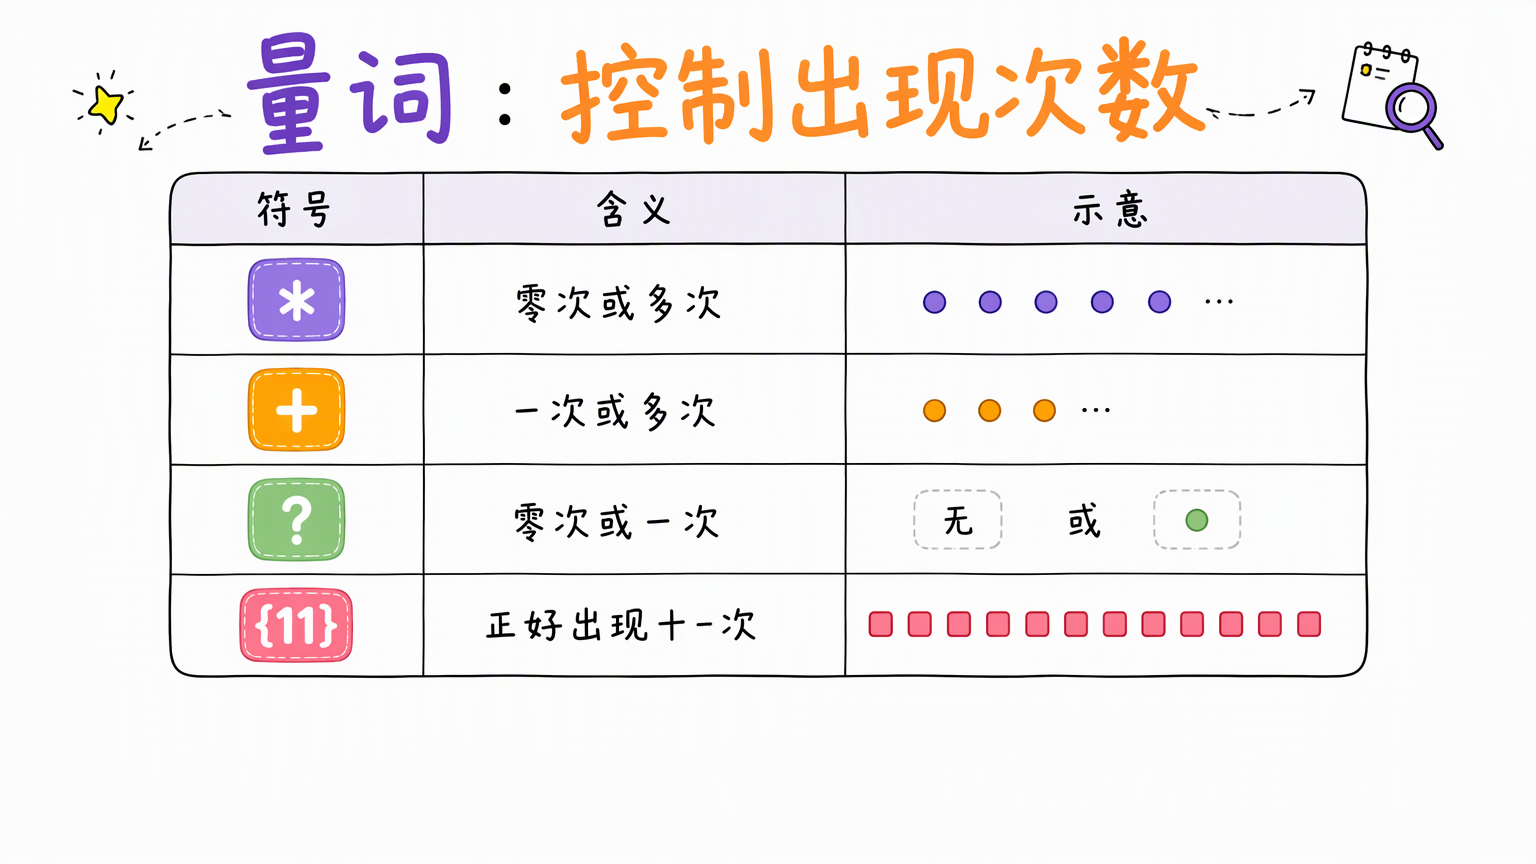
量词控制前一个东西出现几次。
- 星号:零次或多次。
- 加号:一次或多次。
- 问号:零次或一次。
- 花括号里写数字:精确次数,比如写十一,就是正好出现十一次。
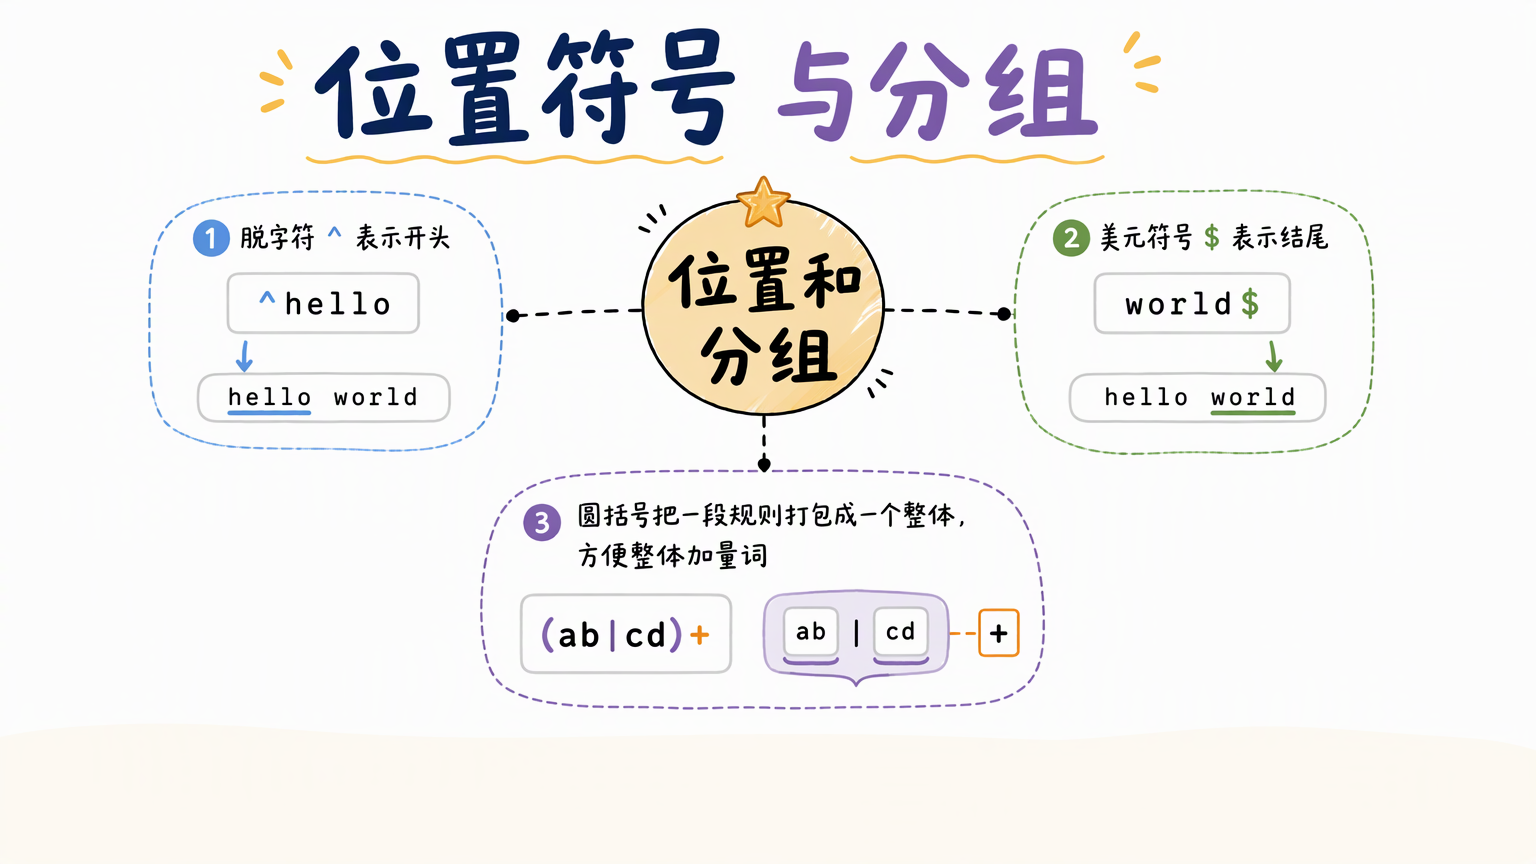
位置和分组负责定位与打包。
- 脱字符表示开头。
- 美元符号表示结尾。
- 圆括号把一段规则打包成一个整体,方便整体加量词。
另外两个必须知道的符号:
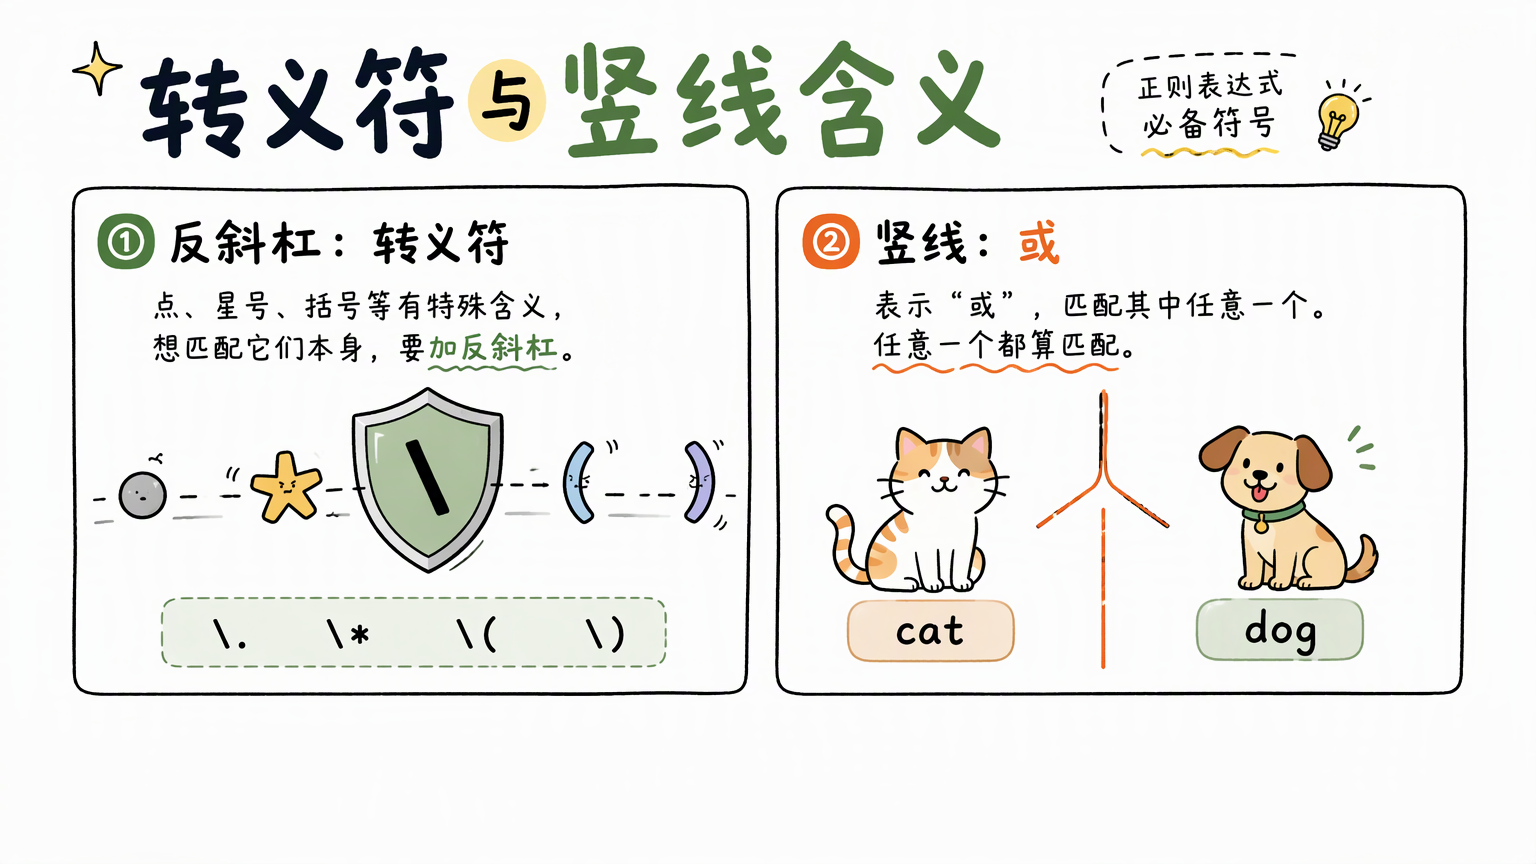
- 反斜杠是转义符。点、星号、括号这些符号在正则里有特殊含义,想匹配它们本身,前面就要加反斜杠。
- 竖线表示“或”。写 cat 竖线 dog,就是猫或者狗,任意一个都算匹配。
怎么读懂一条规则:从邮箱写法开始
把这些拼起来,就能读懂一条真实的规则。比如简单校验邮箱的写法:一段字母数字,一个 at 符号,一段字母数字,一个点,两到四个字母,四部分依次排列。
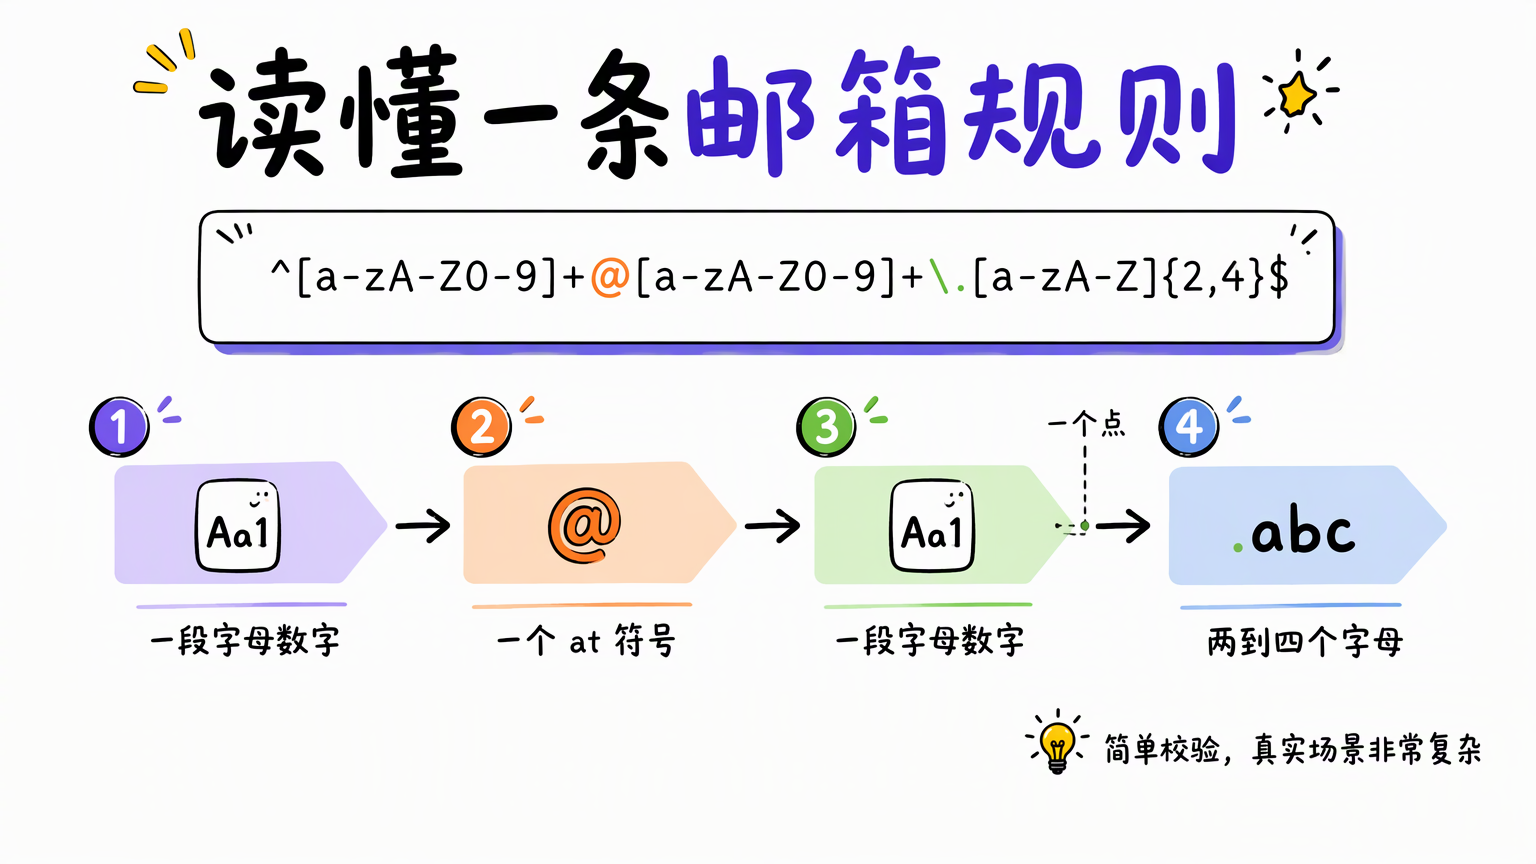
要注意这里说的是简单校验。真实场景里邮箱规则非常复杂,所以不要追求用一条正则覆盖所有情况。
常见误区与限制
贪婪匹配
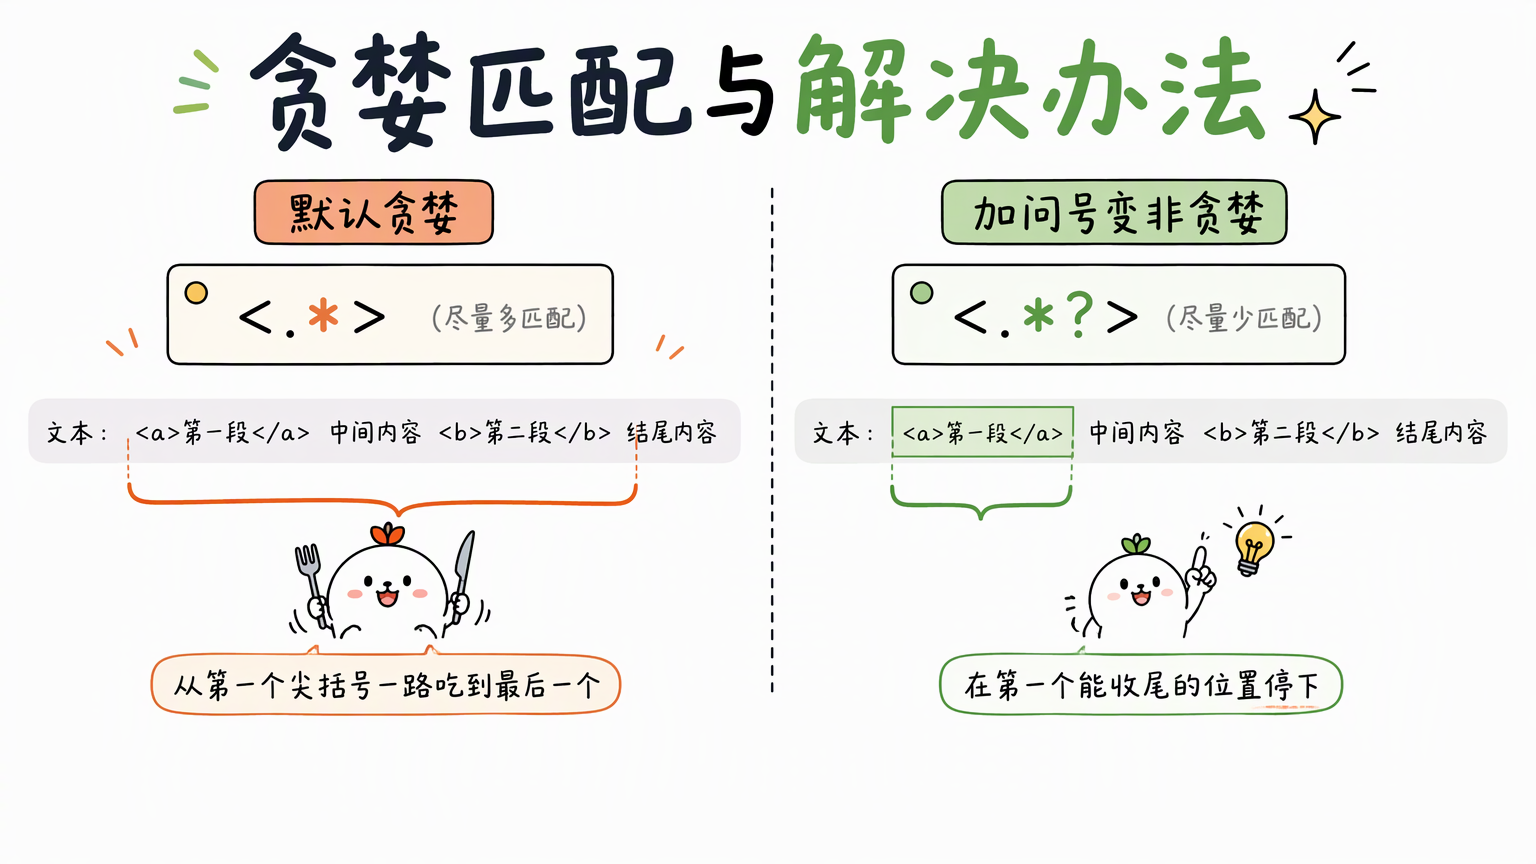
量词默认是贪婪的,也就是尽量多匹配。用星号去匹配一段带尖括号的文本,它会把整行从第一个尖括号一路吃到最后一个尖括号。
解决办法是在量词后面再加一个问号,变成非贪婪,让它在第一个能收尾的位置就停下。
回溯的成本
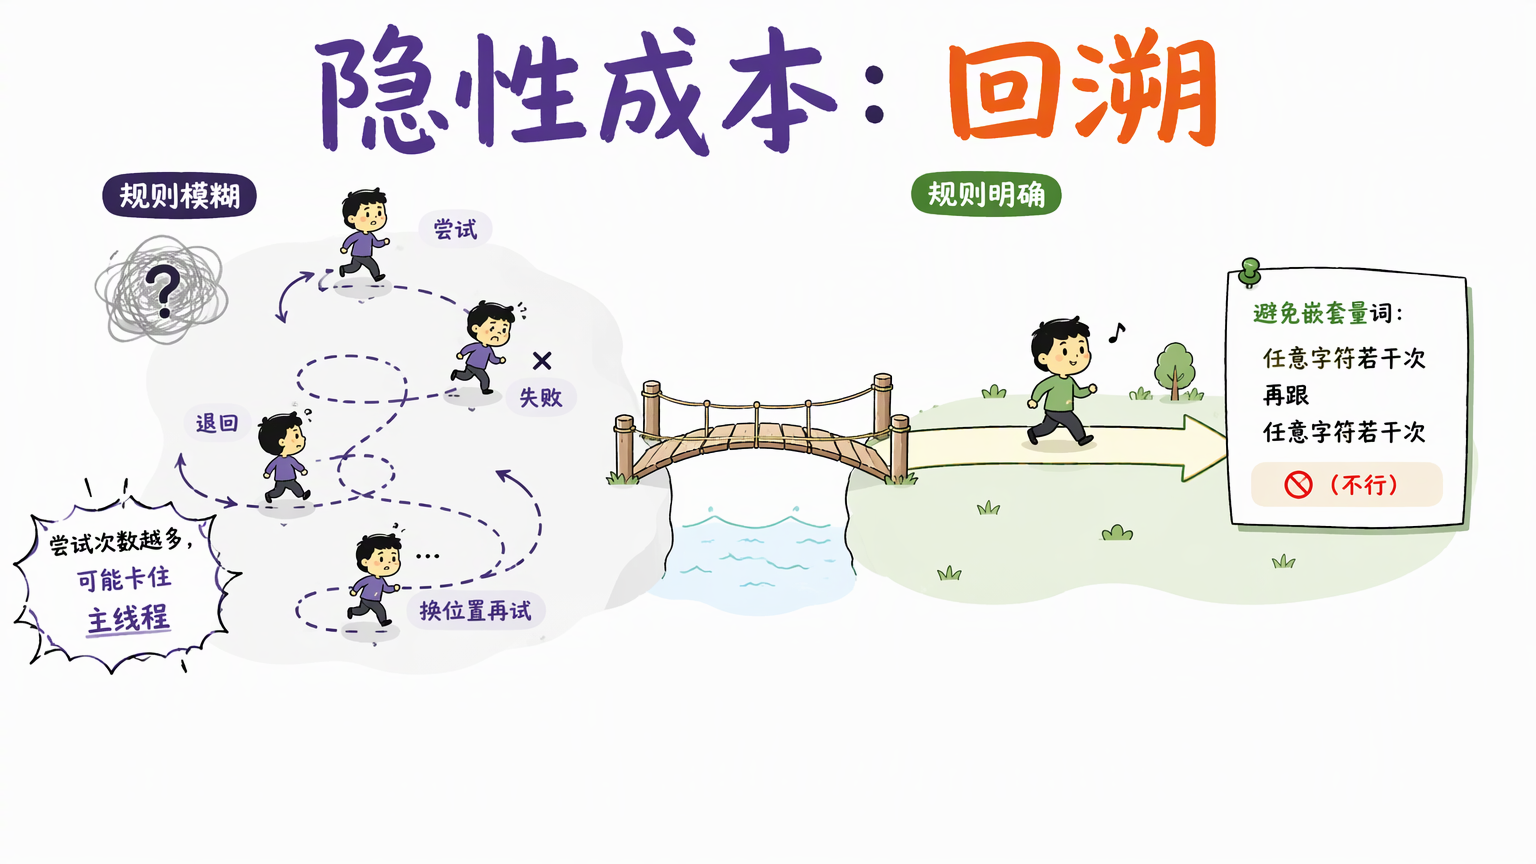
正则还有个隐性成本,叫回溯。当规则写得模糊,引擎会不断尝试、失败、退回、换个位置再试。规则越模糊,尝试次数越多,极端情况下能慢到把主线程卡住。
所以写正则时尽量让规则明确,避免嵌套量词,比如“任意字符若干次”再跟“任意字符若干次”这种写法。
能力边界
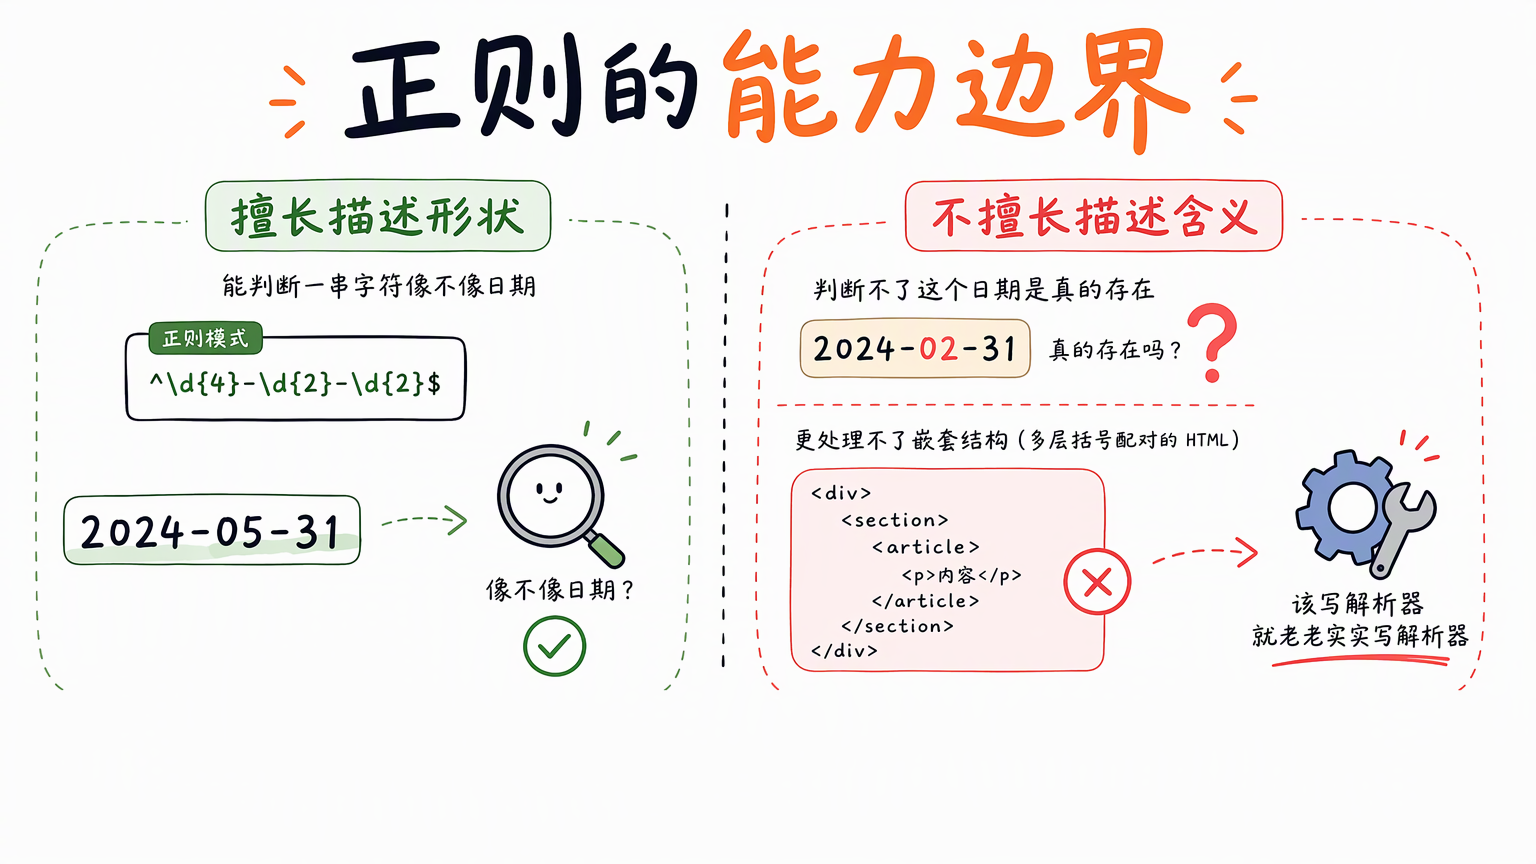
正则擅长描述形状,不擅长描述含义。它能判断一串字符像不像日期,但判断不了这个日期是不是真的存在,更处理不了嵌套结构,比如多层括号配对的 HTML。
遇到这类问题,该写解析器就老老实实写解析器。
实践场景:正则通常出现在哪里
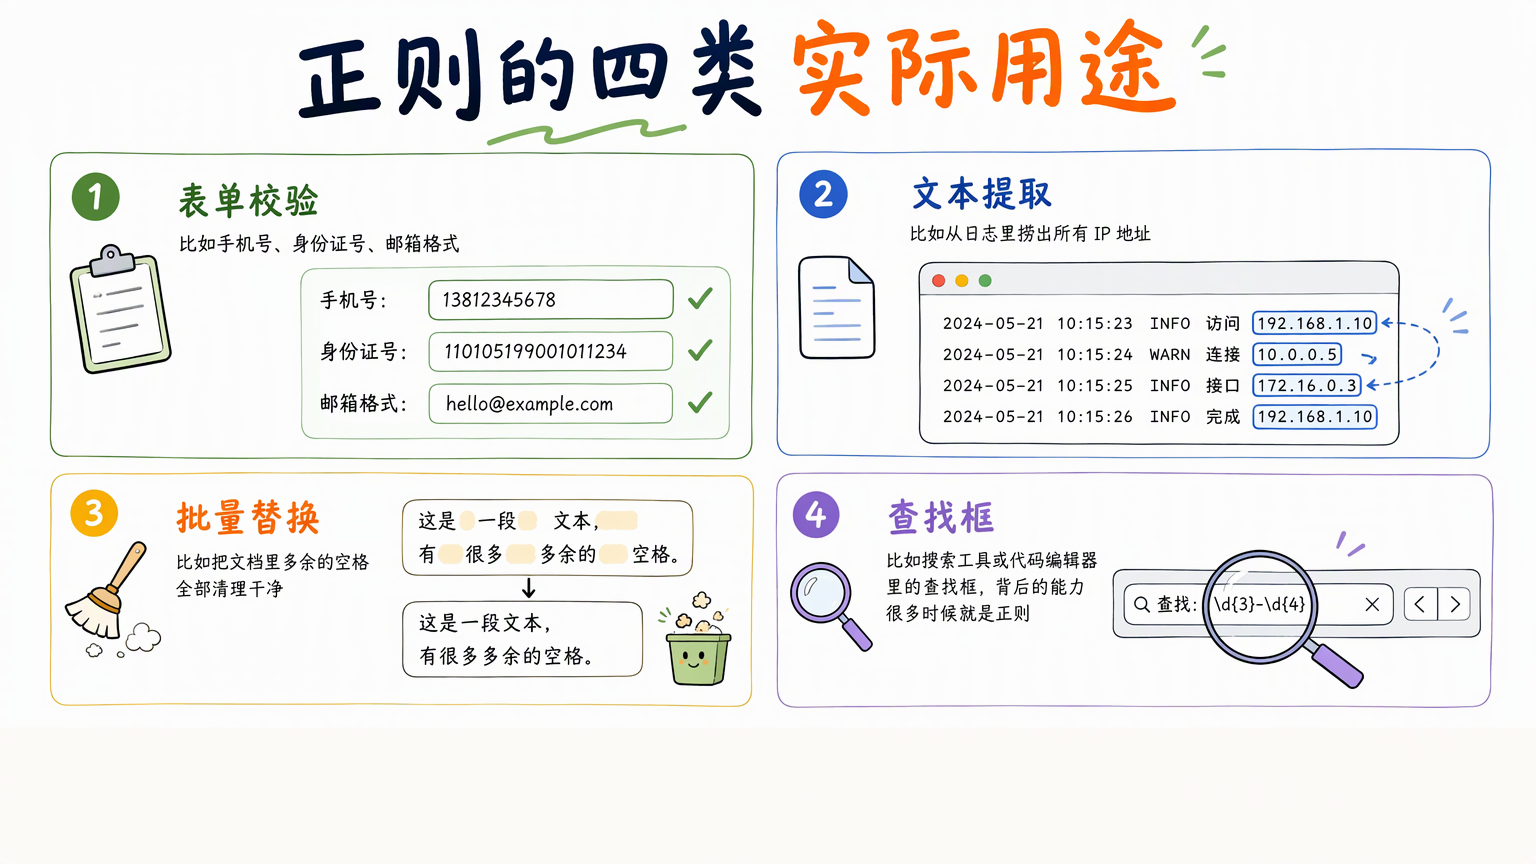
- 表单校验:手机号、身份证号、邮箱格式。
- 文本提取:从日志里捞出所有 IP 地址。
- 批量替换:把文档里多余的空格全部清理干净。
- 搜索工具和代码编辑器里的查找框:背后的能力很多时候就是正则。
常见问题
正则只属于某一种编程语言吗? 不是。它是一套跨语言的文本匹配规则,不是某个软件或某门语言的专利。
为什么一条正则就能省掉大量判断代码? 因为它把“形状”描述清楚了。开头一个一,后面跟十位数字,一条规则就写完,改起来也只要改这一处。
贪婪匹配要怎么改? 在量词后面再加一个问号,就从贪婪变成非贪婪,让它在第一个能收尾的位置就停下。
正则为什么会变慢? 多半是规则写得模糊,引擎不断尝试、失败、退回、换位置再试,尝试次数随规则模糊程度上升,极端情况下能慢到把主线程卡住。
正则能处理所有文本结构吗? 不能。它擅长描述形状,不擅长描述含义,也处理不了嵌套结构,比如多层括号配对的 HTML;这类问题该写解析器就老老实实写解析器。
总结
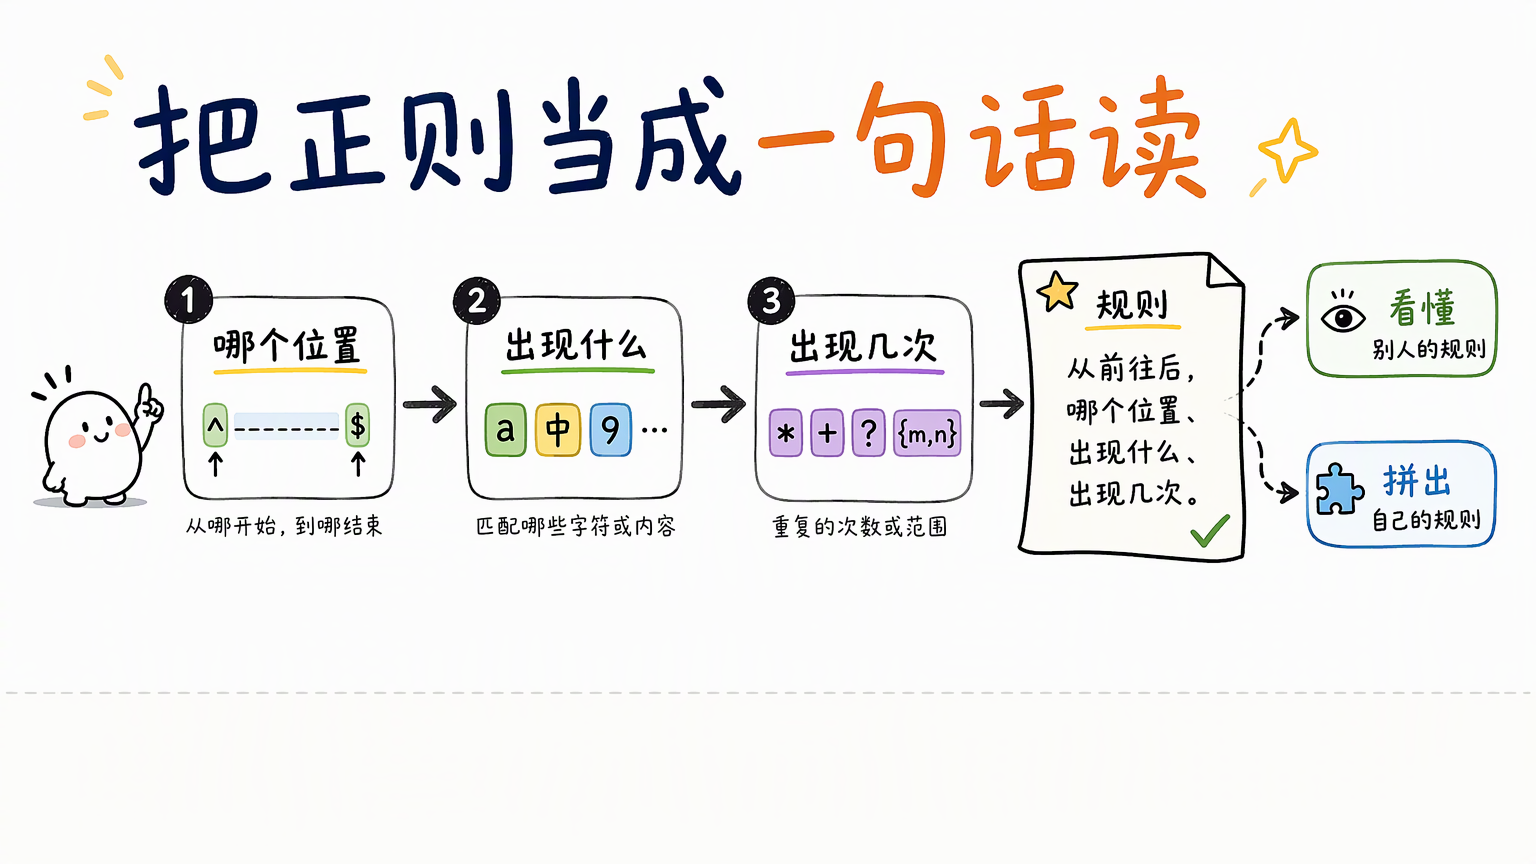
理解正则的关键,不是死背语法符号,而是学会把它当成一句话来读:从前往后,哪个位置、出现什么、出现几次。
掌握这个读法,你既能看懂别人写的规则,也能自己拼出一条可用的规则。