什么是序列化与反序列化
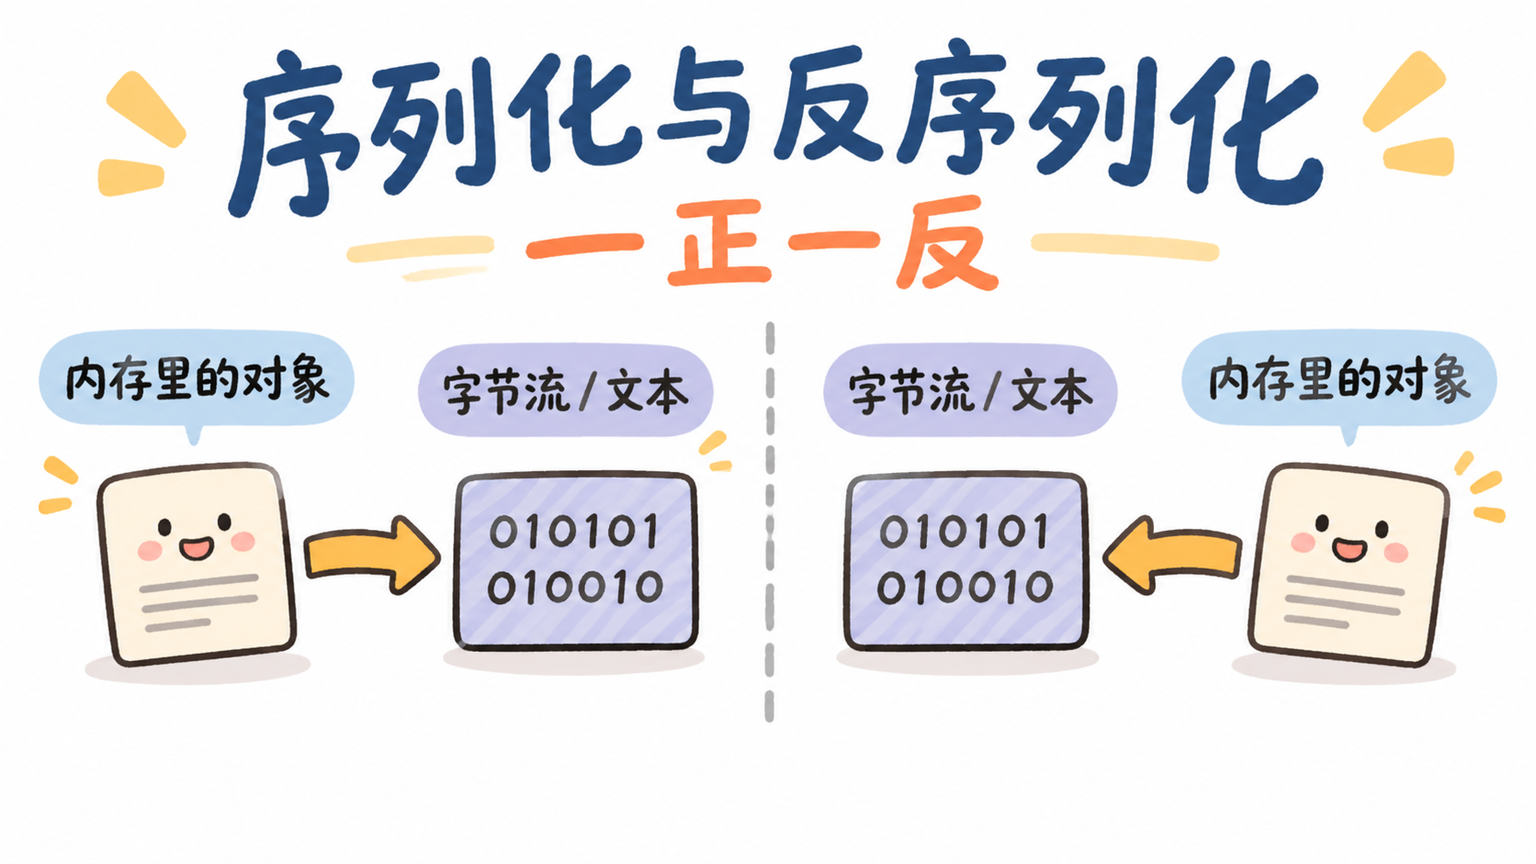
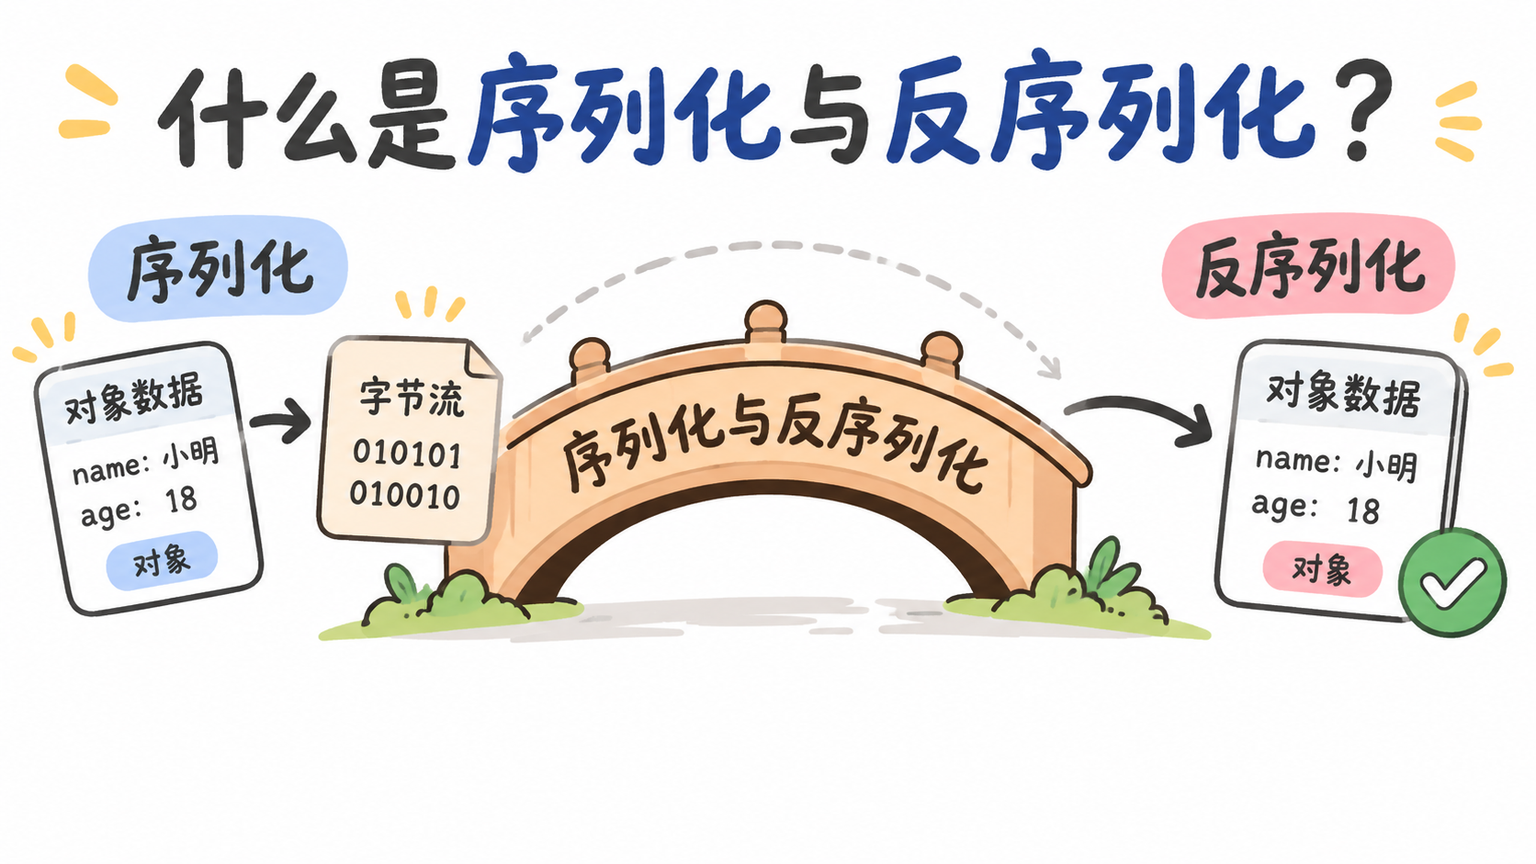
序列化是把程序内存里的对象,变成一段可以存起来、也可以传出去的字节流或文本;反序列化就是反过来,把这段数据重新还原成程序能直接使用的对象。
核心机制:序列化到底在做什么
程序运行时,一个对象是散落在内存里的,它带着自己的类型、字段值,还有指向其他对象的引用。
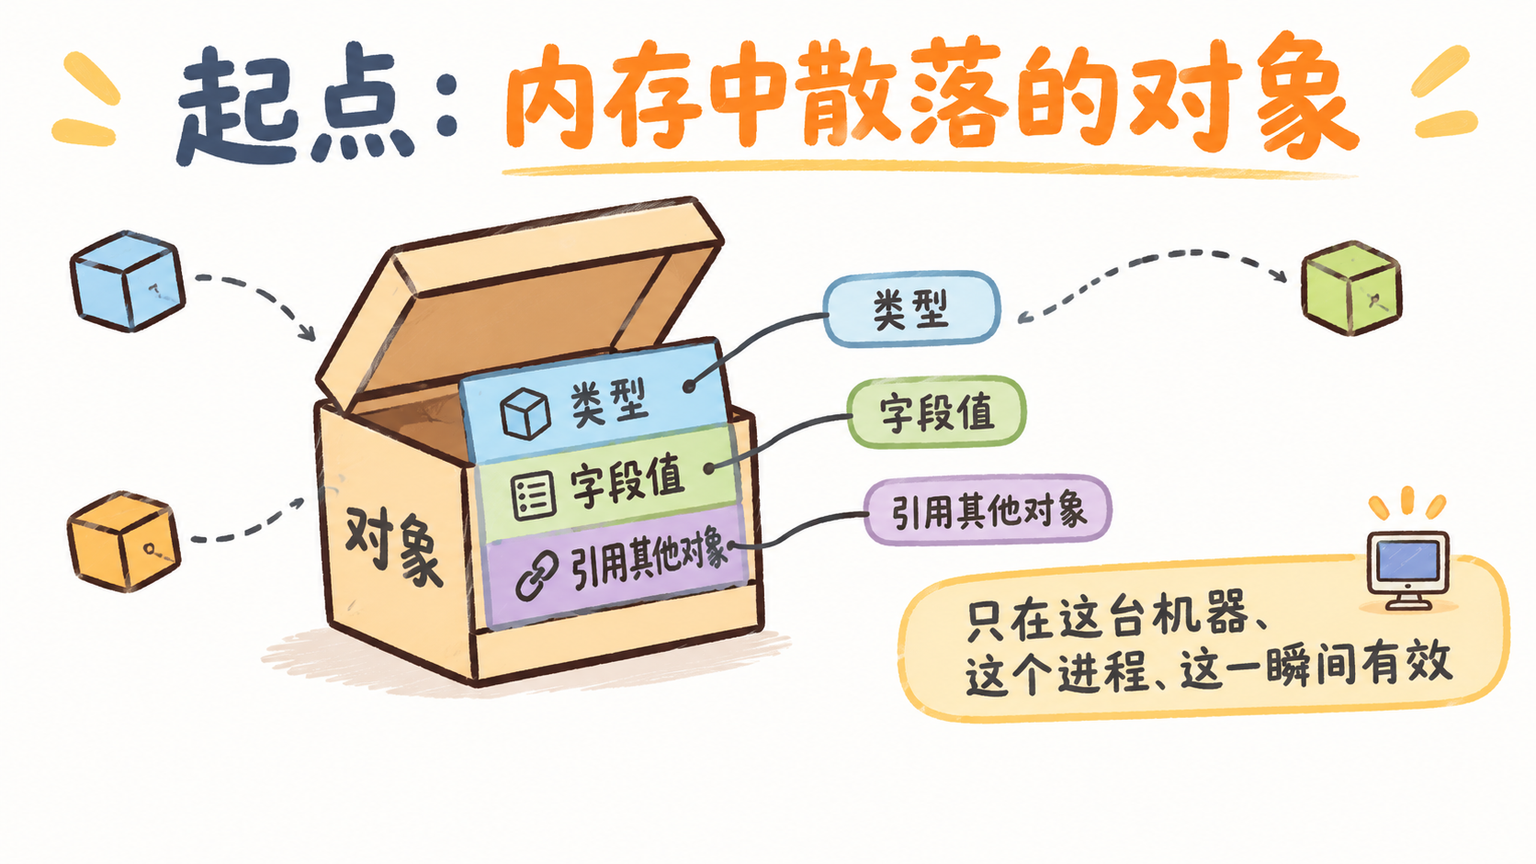
这些东西只在这台机器、这个进程、这一瞬间有效。
序列化要做的,就是按约定的规则,把对象的类型和每个字段的值,按顺序写成一串连续的字节或字符。
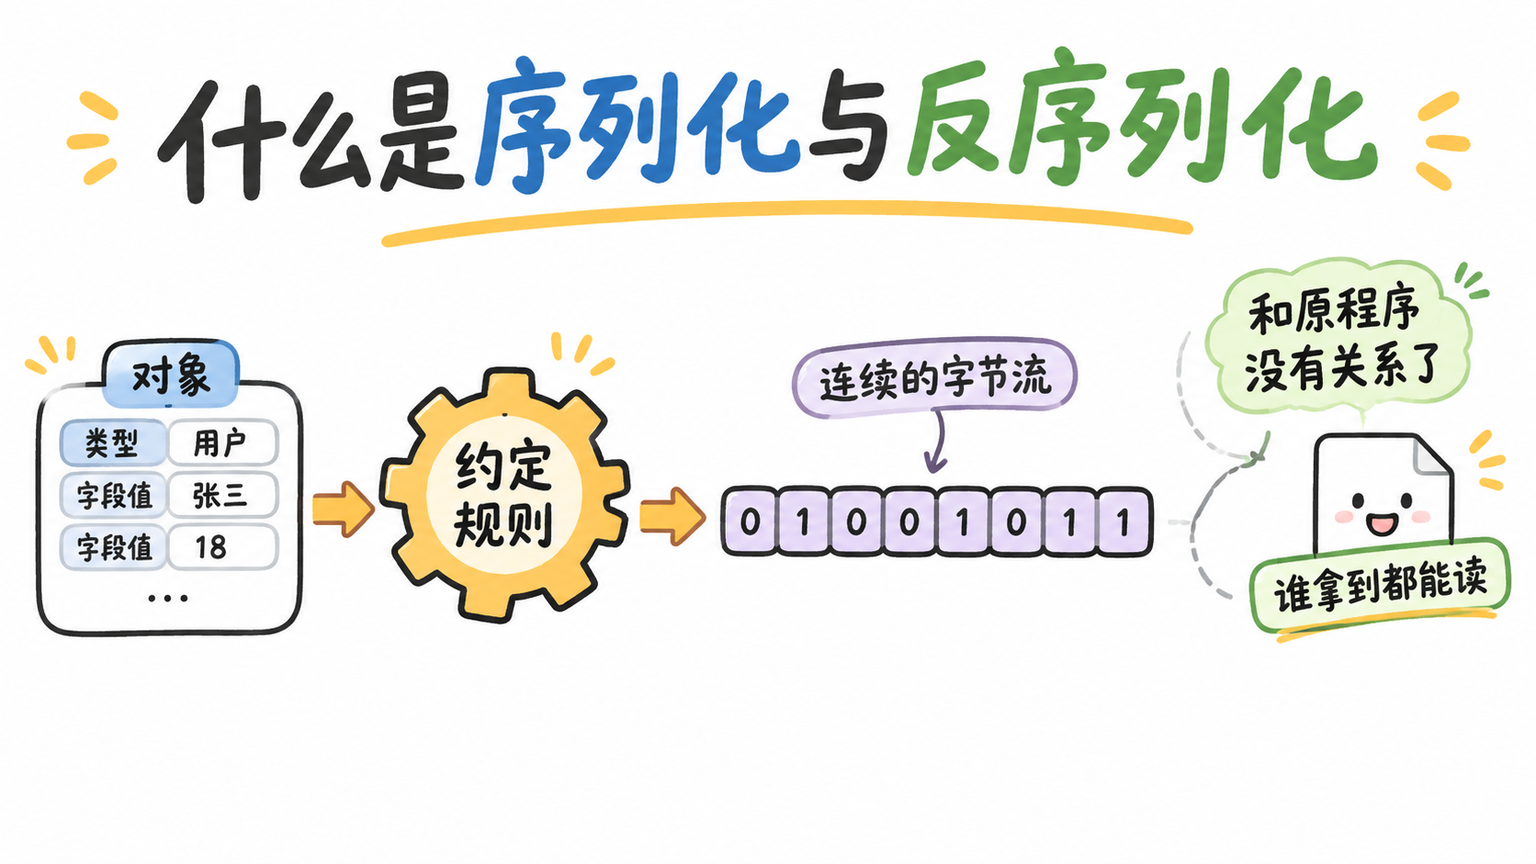
写完之后,它就跟原来的程序没有关系了,谁拿到都能读。
核心机制:反序列化是这条路的另一半
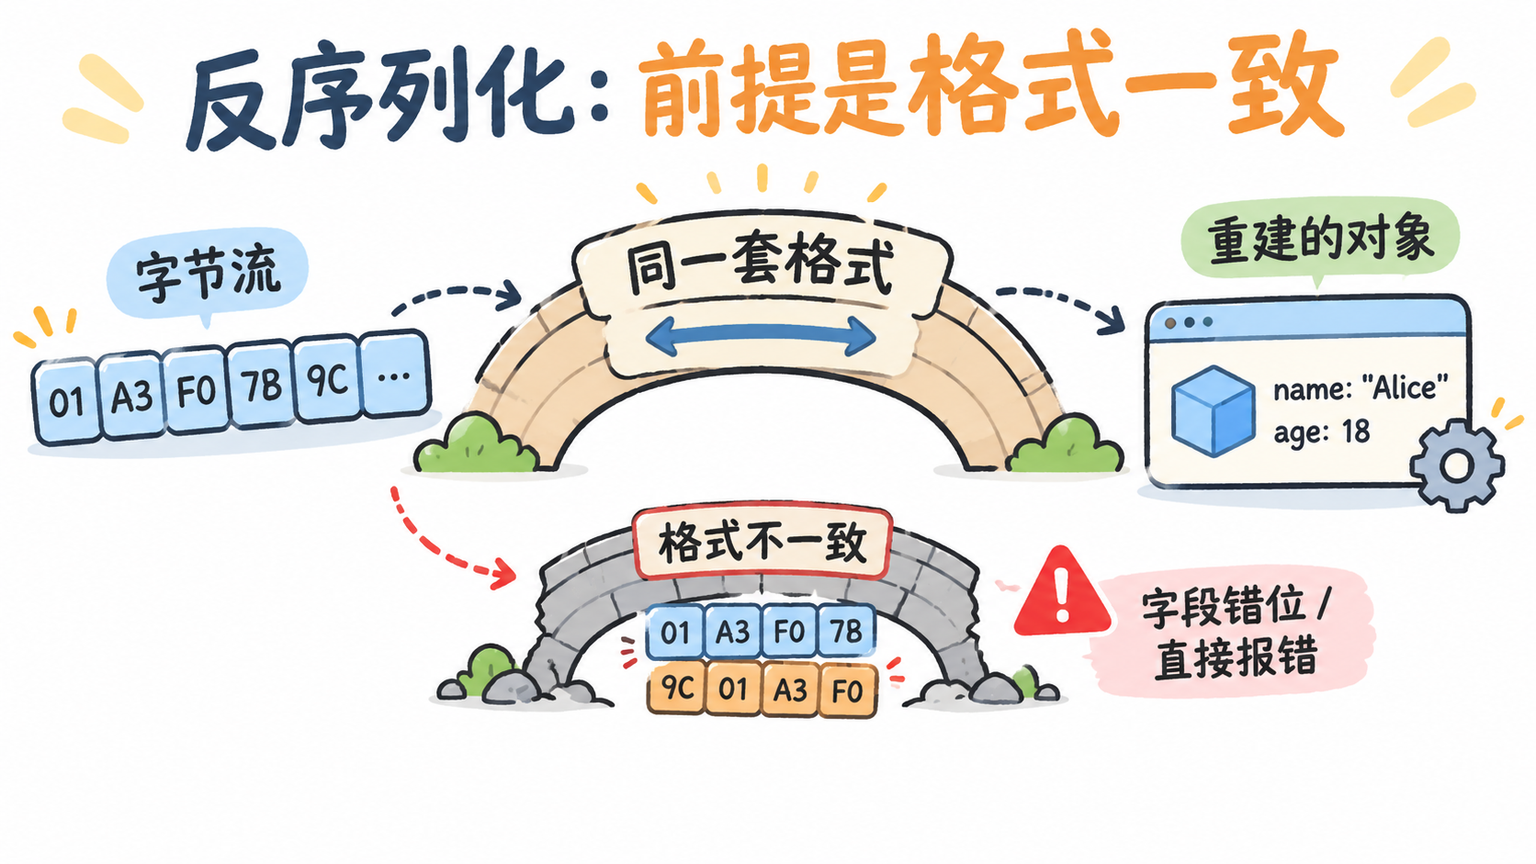
接收方按同一套规则把字节读出来,重新在内存里造出一个对象,字段值对得上,程序就能直接调用它。
这里有个关键前提:双方必须认可同一套格式。格式一旦不一致,字段就会错位,轻则数据读错,重则直接报错。
为什么非做不可:对象出不了进程
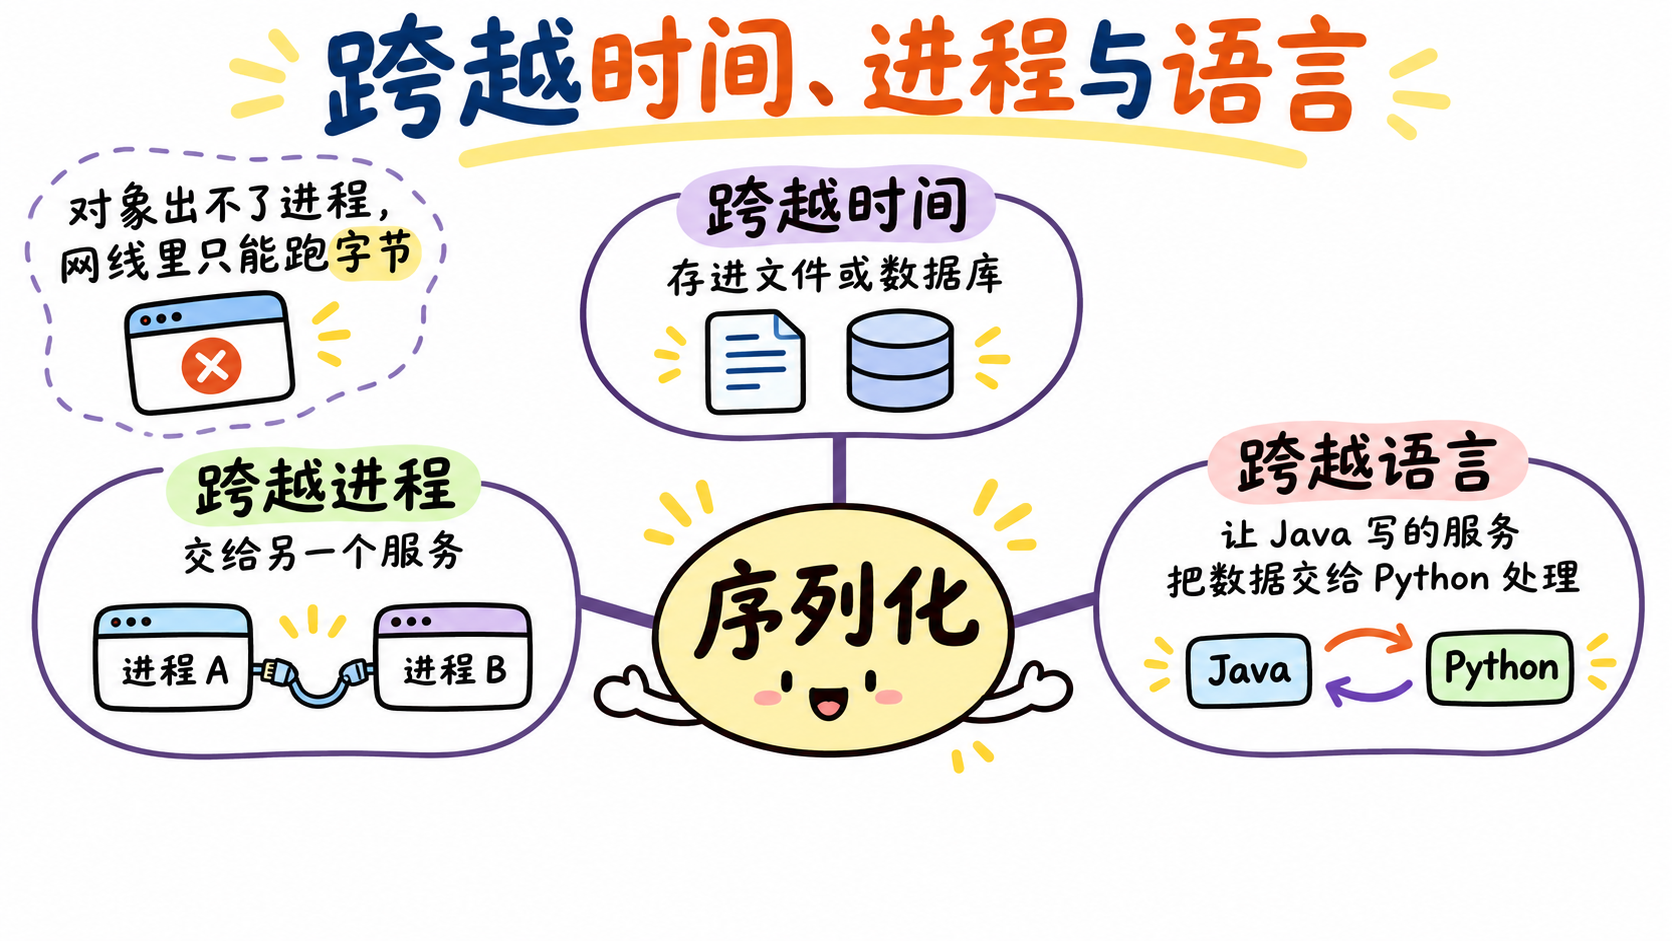
你的程序一关,内存里的对象就没了;两台机器之间更不可能直接传对象,网线里只能跑字节。
序列化解决的正是这件事,它让数据能跨越三个边界。
- 跨越时间:把数据存进文件或数据库。
- 跨越进程:把数据交给另一个服务。
- 跨越语言:让 Java 写的服务把数据交给 Python 写的脚本处理。
一个类比:打包与拆箱
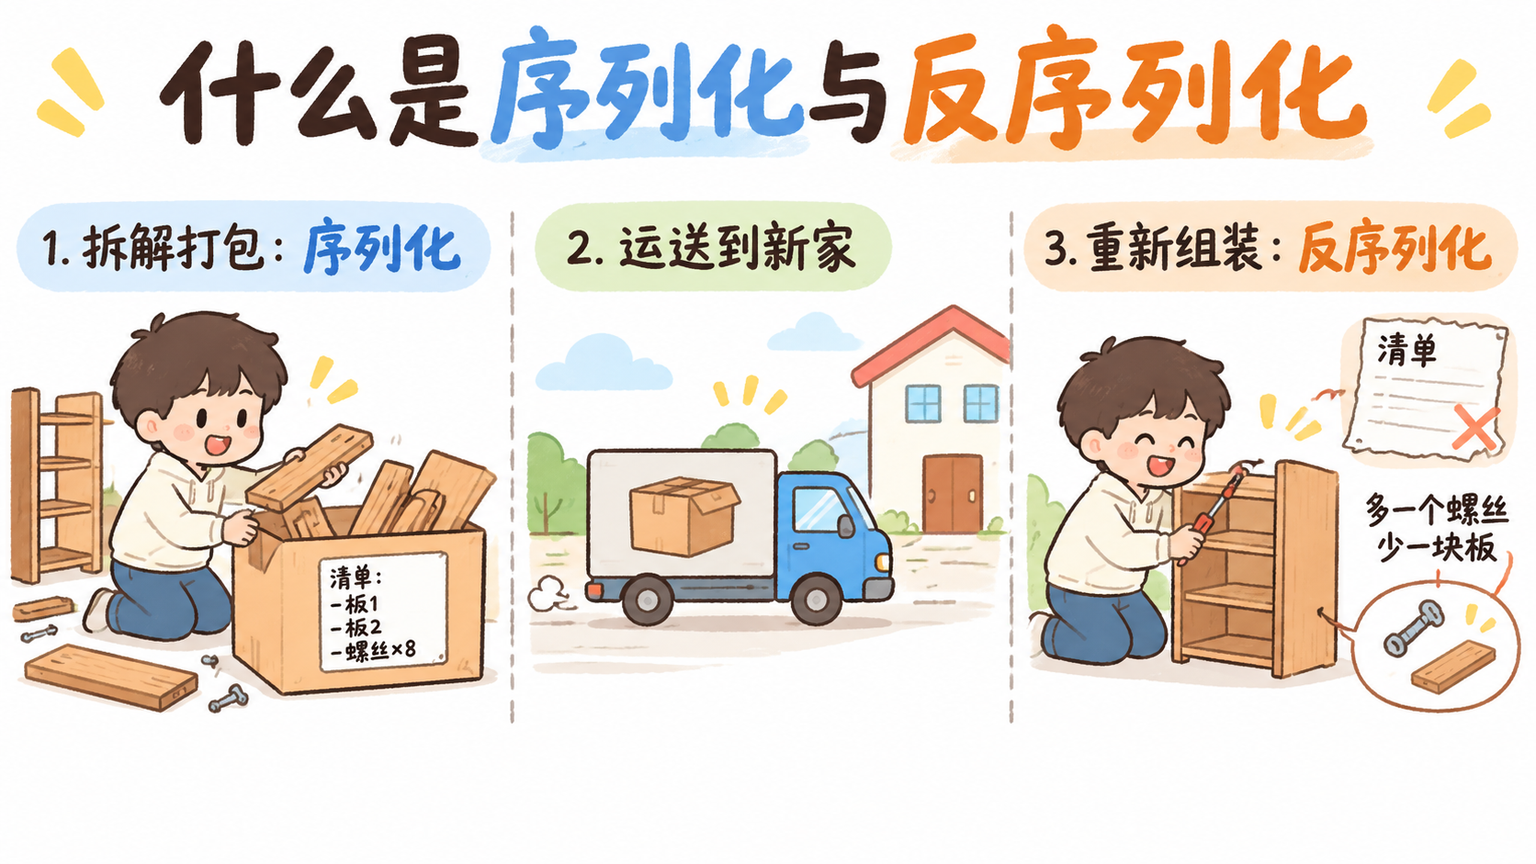
这很像搬家:你家里一整套家具就是内存里的对象,直接搬是搬不动的,得先拆开、打包、装进箱子,这就是序列化。
到了新家拆箱、组装、摆回原位,这就是反序列化。
箱子上贴的清单就是格式说明,清单丢了或者对不上,装回去就会多一个螺丝少一块板。
常见格式:文本格式与二进制格式
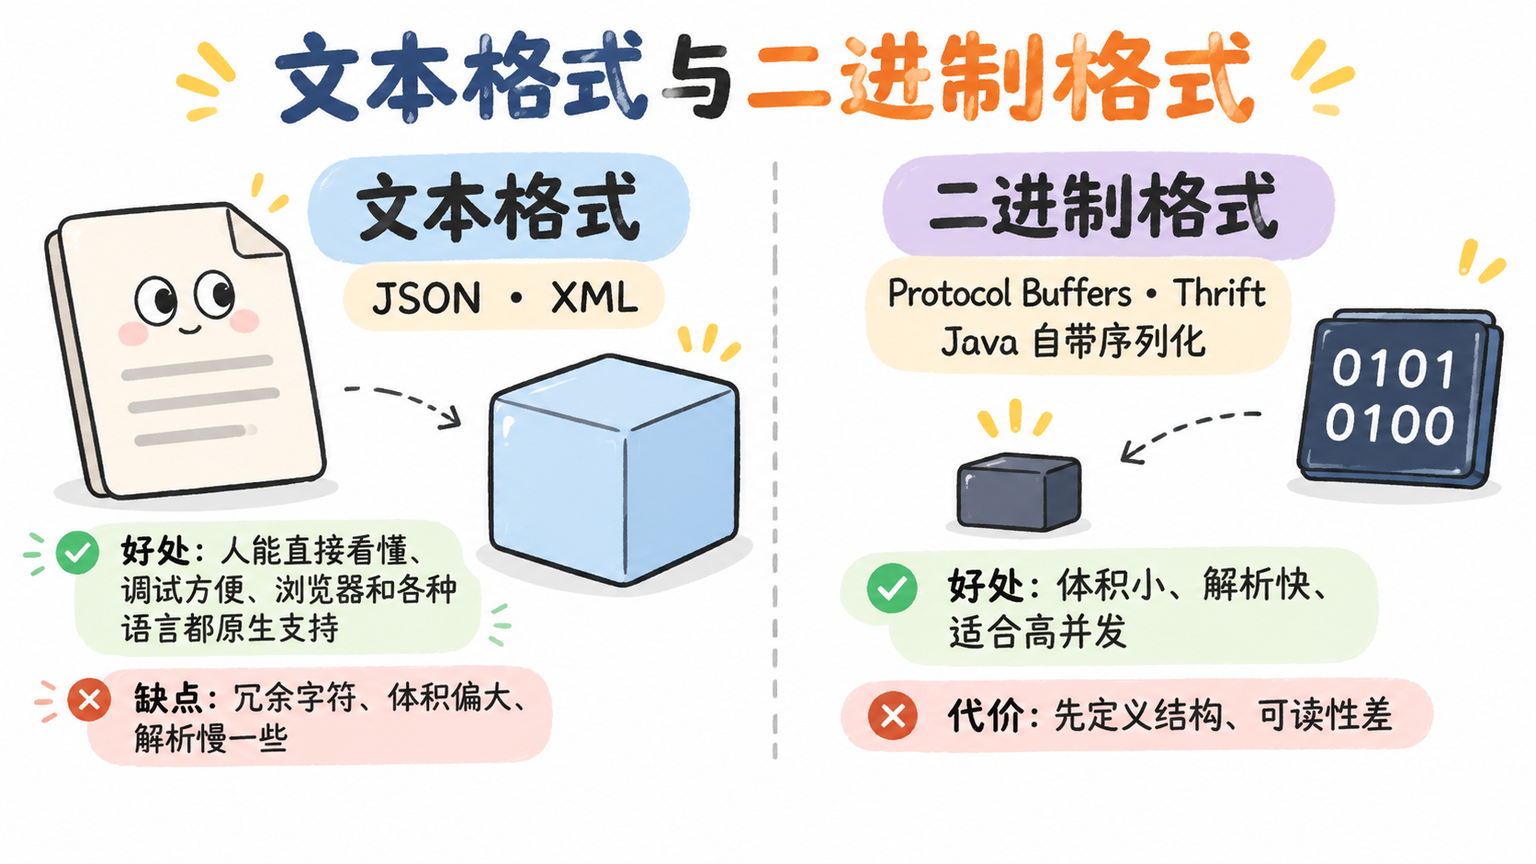
第一类是文本格式,最典型的是 JSON,还有 XML。
它们的好处是人能直接看懂,调试方便,浏览器和各种语言都原生支持;缺点是有冗余字符,体积偏大,解析也慢一些。
第二类是二进制格式,比如 Protocol Buffers、Thrift,以及 Java 自带的序列化。
它们体积小、解析快、适合高并发场景,代价是需要先定义结构,可读性差。
怎么选:看两个判断条件
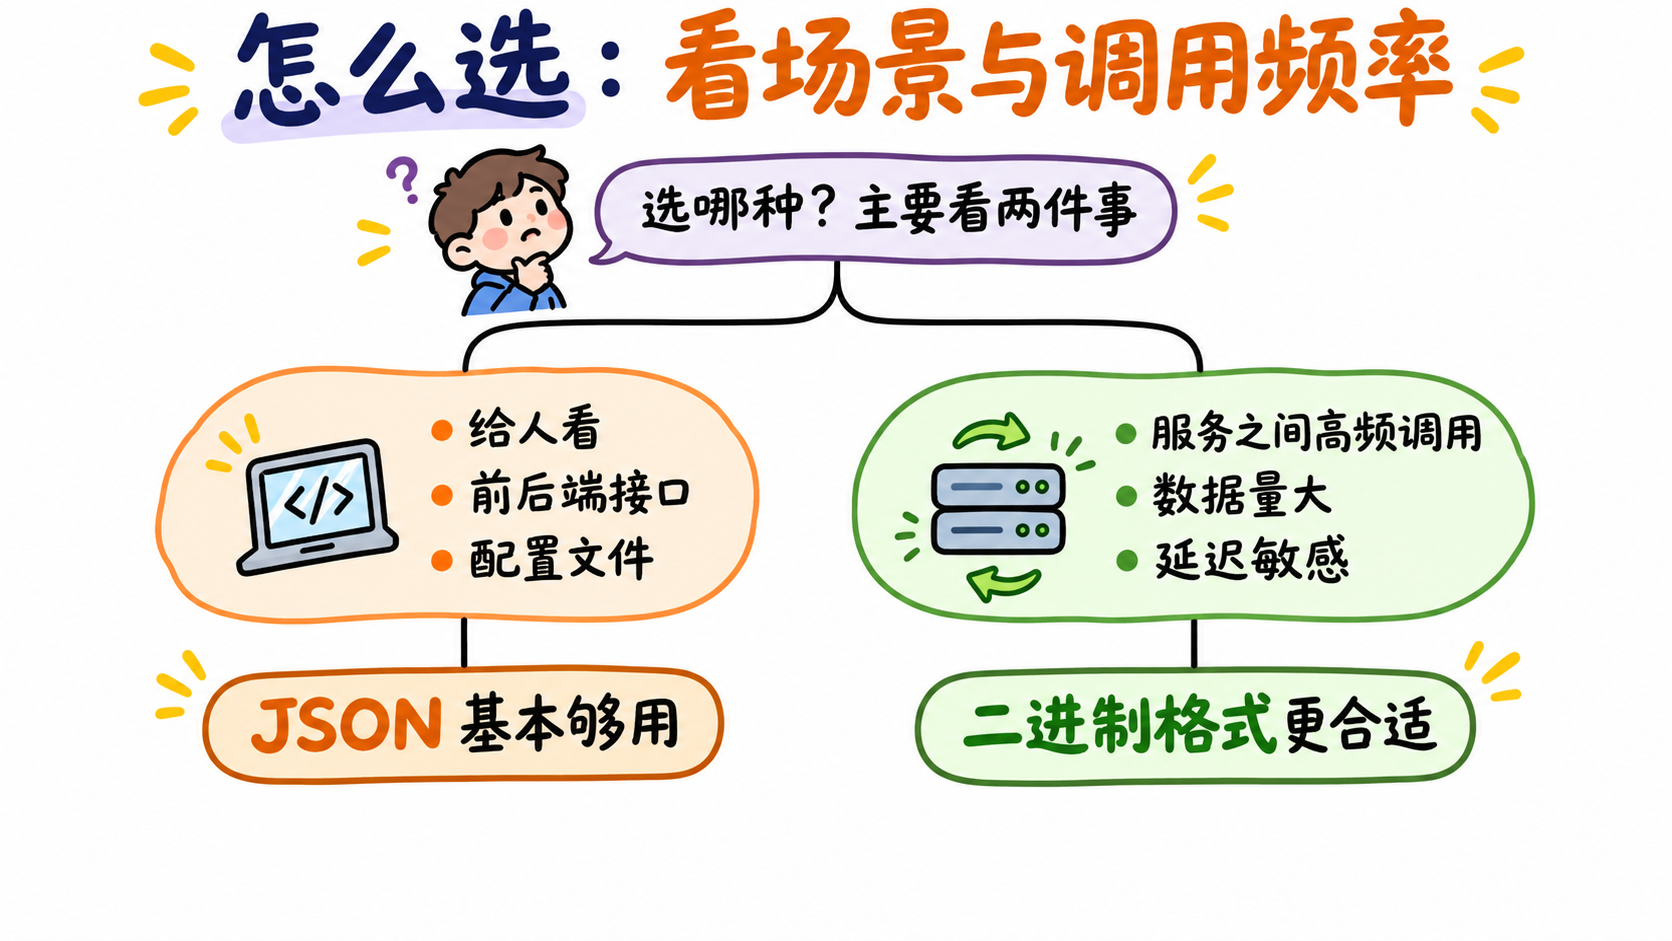
如果这份数据要给人看,或者是前后端接口、配置文件,JSON 基本够用。
如果是服务之间高频调用,数据量大、对延迟敏感,二进制格式更合适。
实践场景:它出现在哪里
实际使用中的场景非常密集。
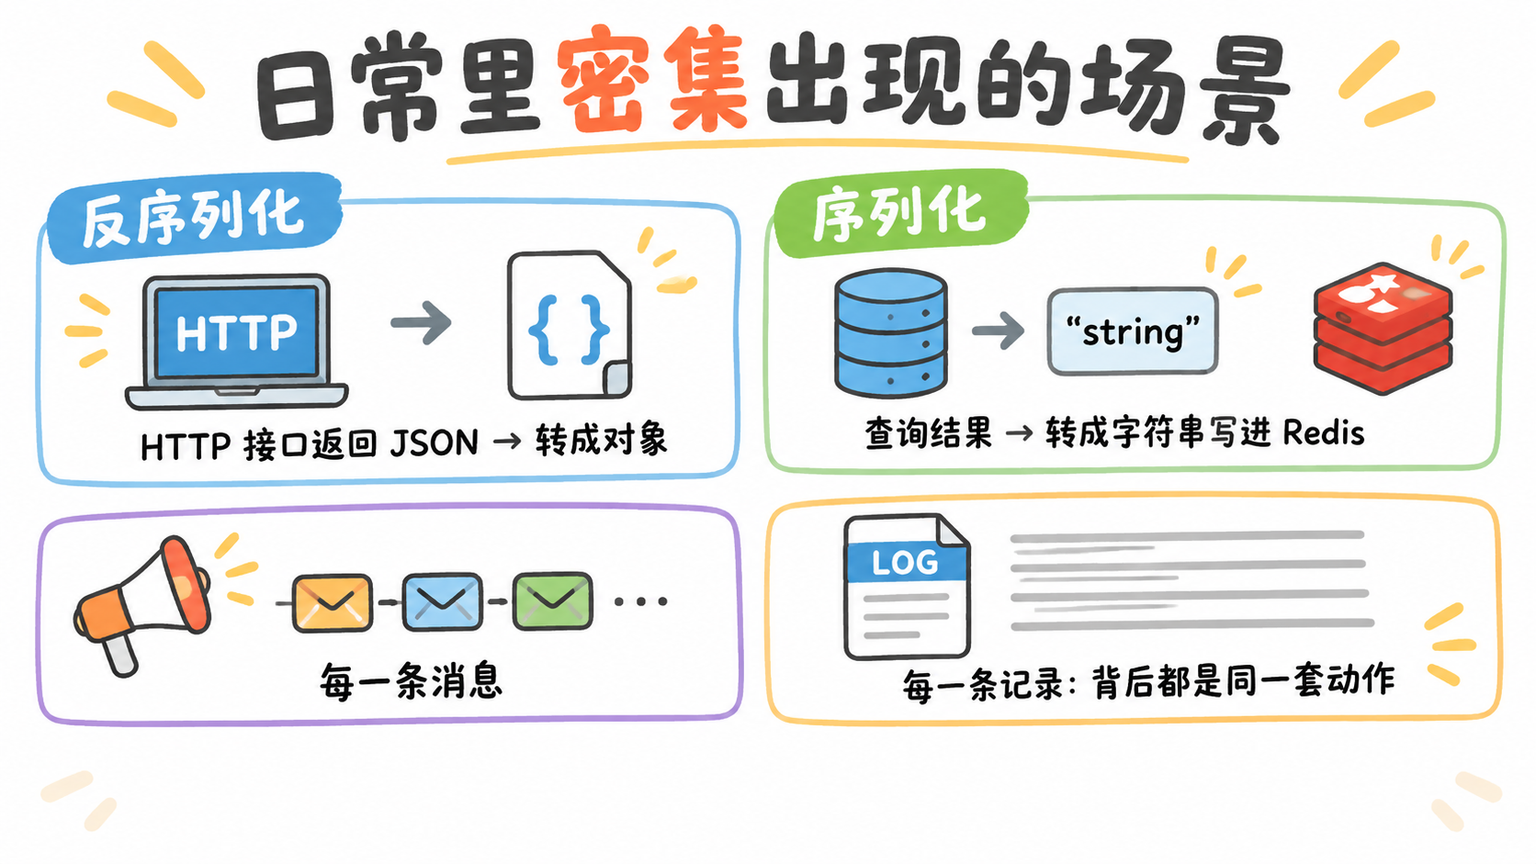
调用一个 HTTP 接口,返回的 JSON 被转成对象,这是反序列化。
把查询结果写进 Redis,得先转成字符串,这是序列化。
消息队列里传递的每一条消息,日志系统落盘的每一条记录,背后都是同一套动作。
限制与常见误区:三个坑
坑一:版本兼容
你今天给对象加了字段,老版本的接收方可能不认识它,也可能把默认值覆盖掉。
稳妥的做法是把新增字段设为可选,并且不要随意重命名或删除已有字段。
坑二:安全
反序列化会把数据还原成对象,甚至可能触发构造函数和回调逻辑。
如果数据来自不可信来源,攻击者就能构造恶意内容,让它在本机执行意料之外的操作。
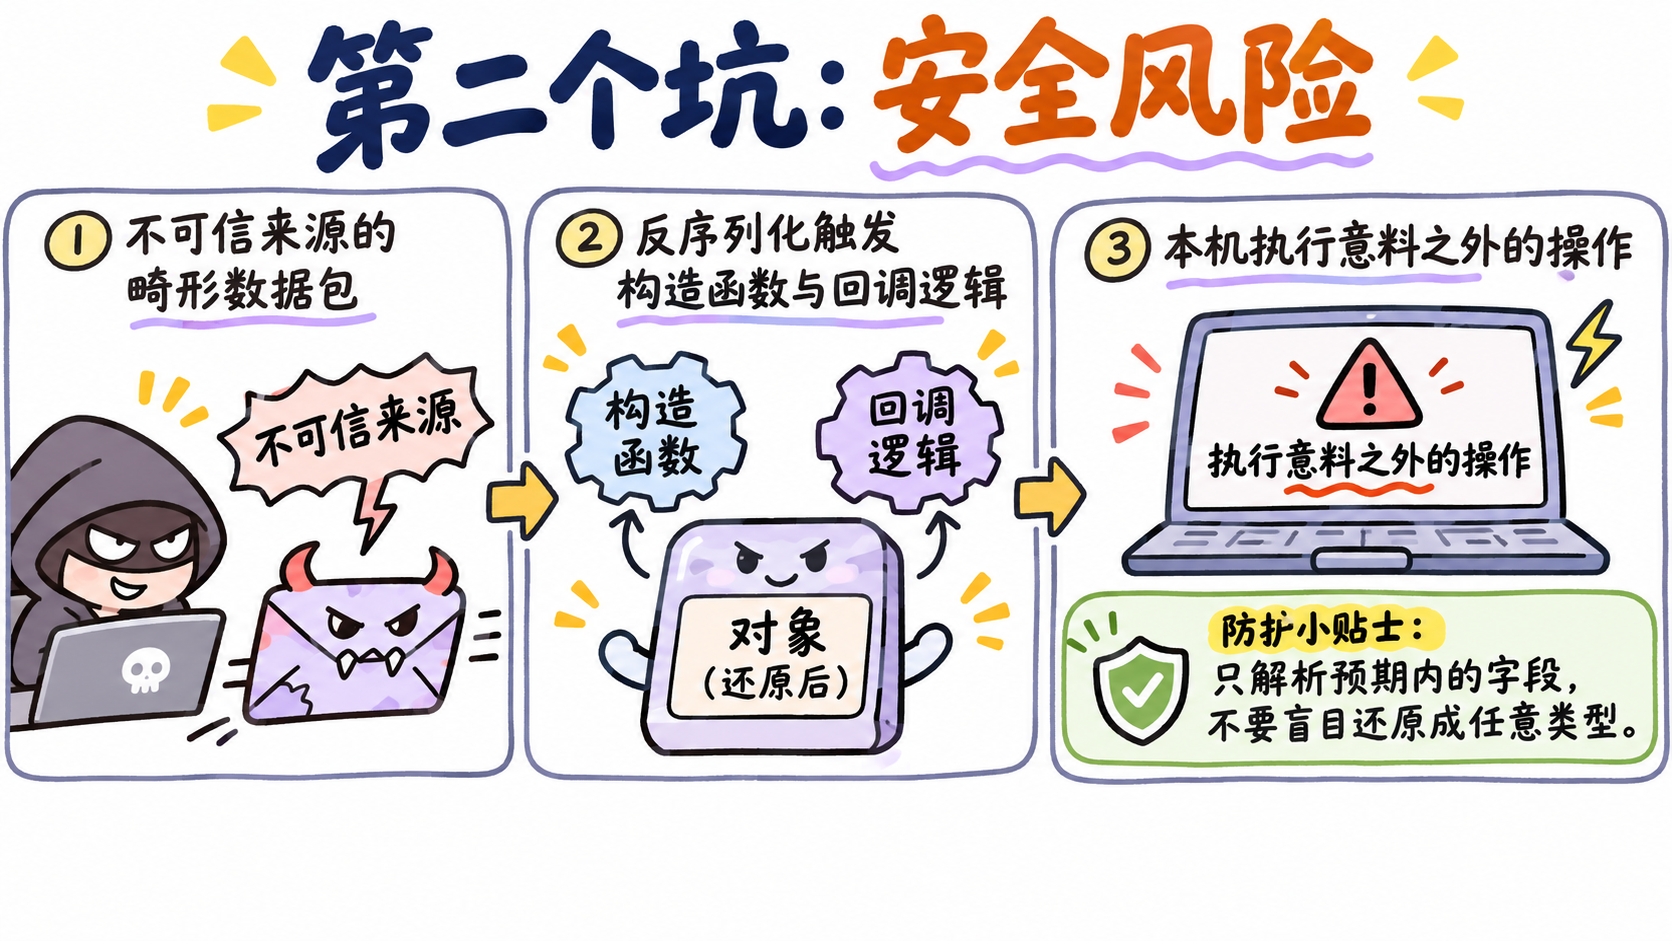
所以对外部输入,永远只解析预期内的字段,不要盲目还原成任意类型。
坑三:性能
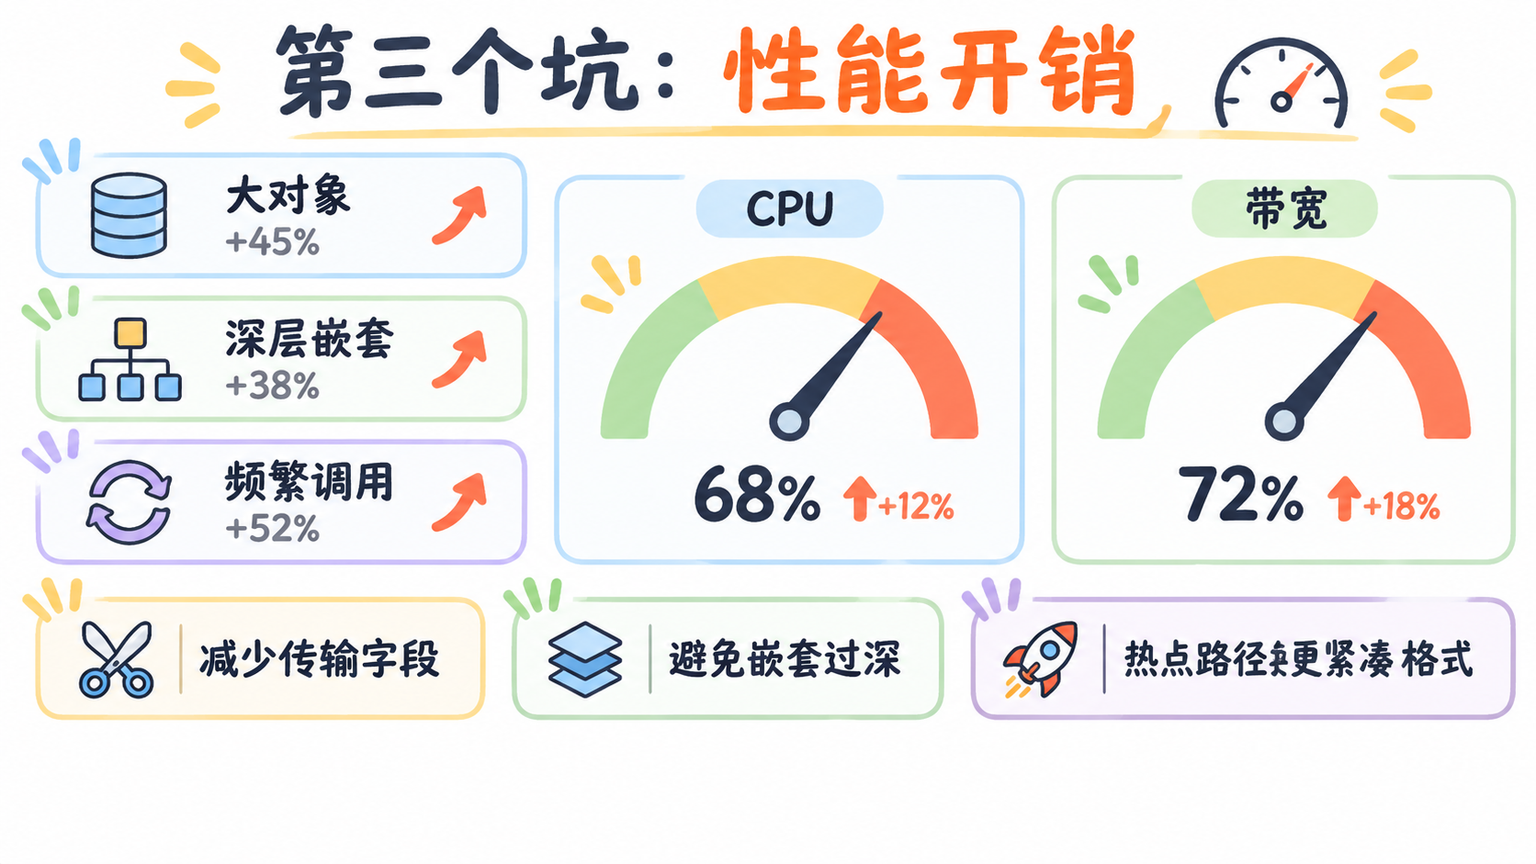
序列化和反序列化都不是免费的,大对象、深层嵌套、频繁调用,都会变成实实在在的 CPU 和带宽开销。
优化思路很直接:减少传输字段,避免嵌套过深,在热点路径上换用更紧凑的格式。
常见问题
序列化和反序列化分别是什么?
序列化是把程序内存里的对象,变成一段可以存起来、也可以传出去的字节流或文本;反序列化是把这段数据重新还原成程序能直接使用的对象。
反序列化最关键的前提是什么?
双方必须认可同一套格式。格式不一致时,字段会错位,轻则数据读错,重则直接报错。
文本格式和二进制格式怎么选?
如果数据要给人看,或者是前后端接口、配置文件,JSON 基本够用;如果是服务之间高频调用、数据量大、对延迟敏感,二进制格式更合适。
实际使用中最需要注意的是哪几件事?
三个坑:版本兼容、安全、性能。
总结
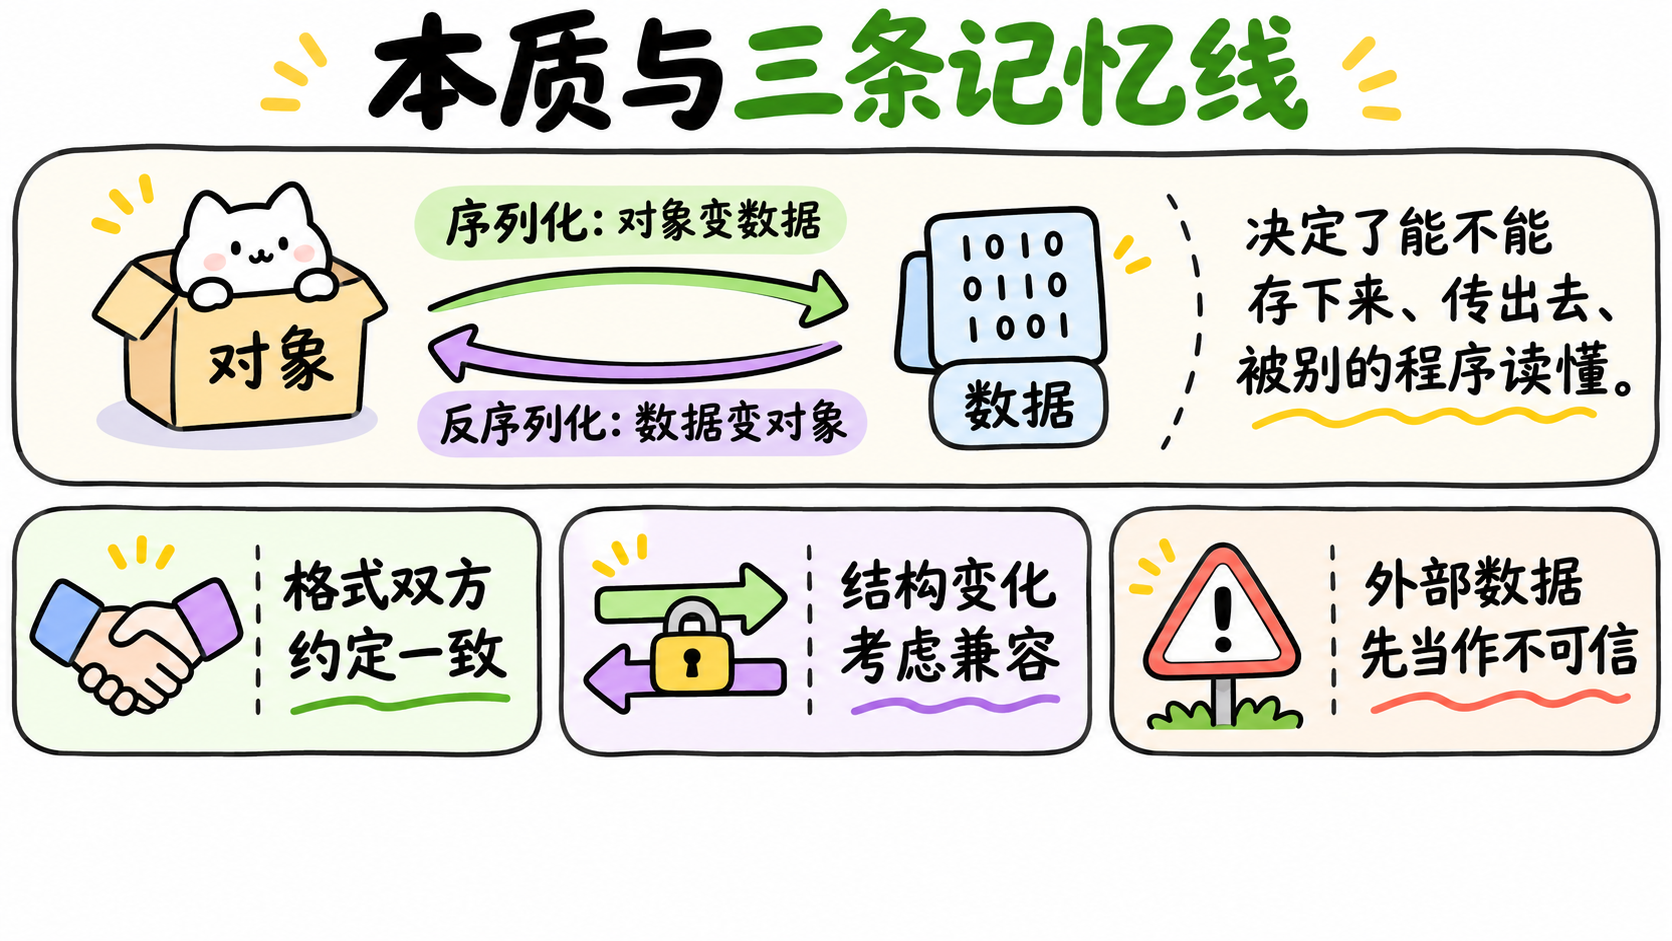
回到最本质的一句话:序列化负责把对象变成数据,反序列化负责把数据变回对象。
它看起来只是一个转换步骤,却决定了数据能不能被存下来、传出去、被别的程序读懂。
使用时记住三件事:
- 格式必须双方约定一致。
- 结构变化要考虑兼容。
- 外部数据要先当作不可信处理。