什么是缓存
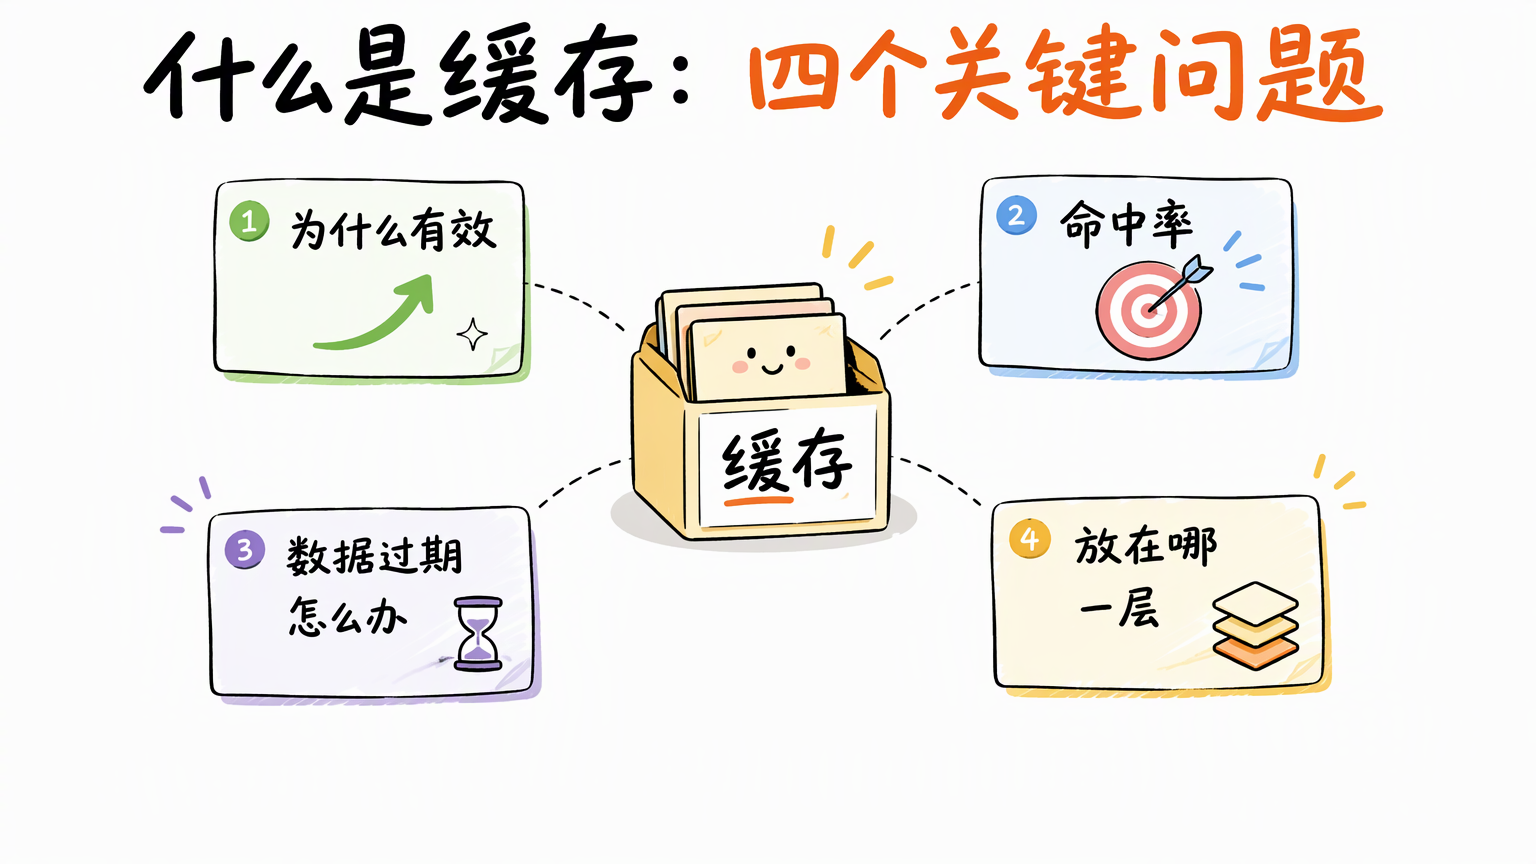
缓存就是把取一次很费劲的结果先存起来,下次直接拿。本文讲清缓存为什么有效、命中率意味着什么、数据过期了怎么办,以及真实系统里它到底放在哪一层。把这几点想明白,就能判断一处缓存该不该加、加在哪、什么时候会出问题。
缓存为什么有效:存一份,拿一份
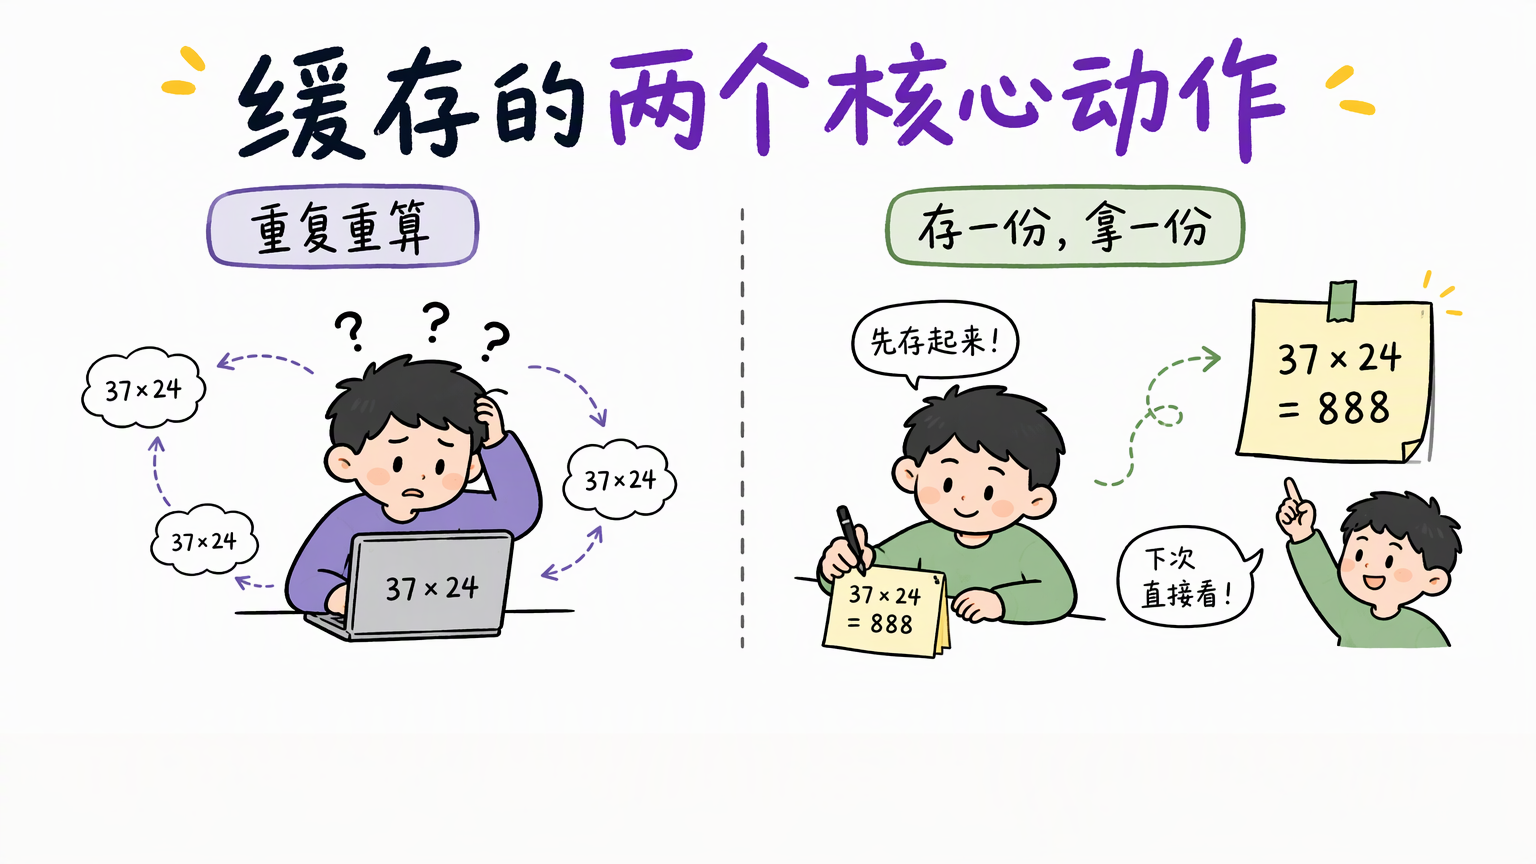
缓存的核心动作只有两个:存一份,拿一份。比如你算 37 乘 24,算十次还是同一个结果,与其每次都重算,不如写在便签上,下次直接看这张便签。
程序里也是同一回事。
读一次数据库可能要几十毫秒,读一次内存只要一百纳秒左右,中间差了好几个数量级。缓存干的事,就是把数据从远的、慢的地方,搬到近的、快的地方。所以它本质上是拿空间换时间,用一份额外存储,换更短的响应。
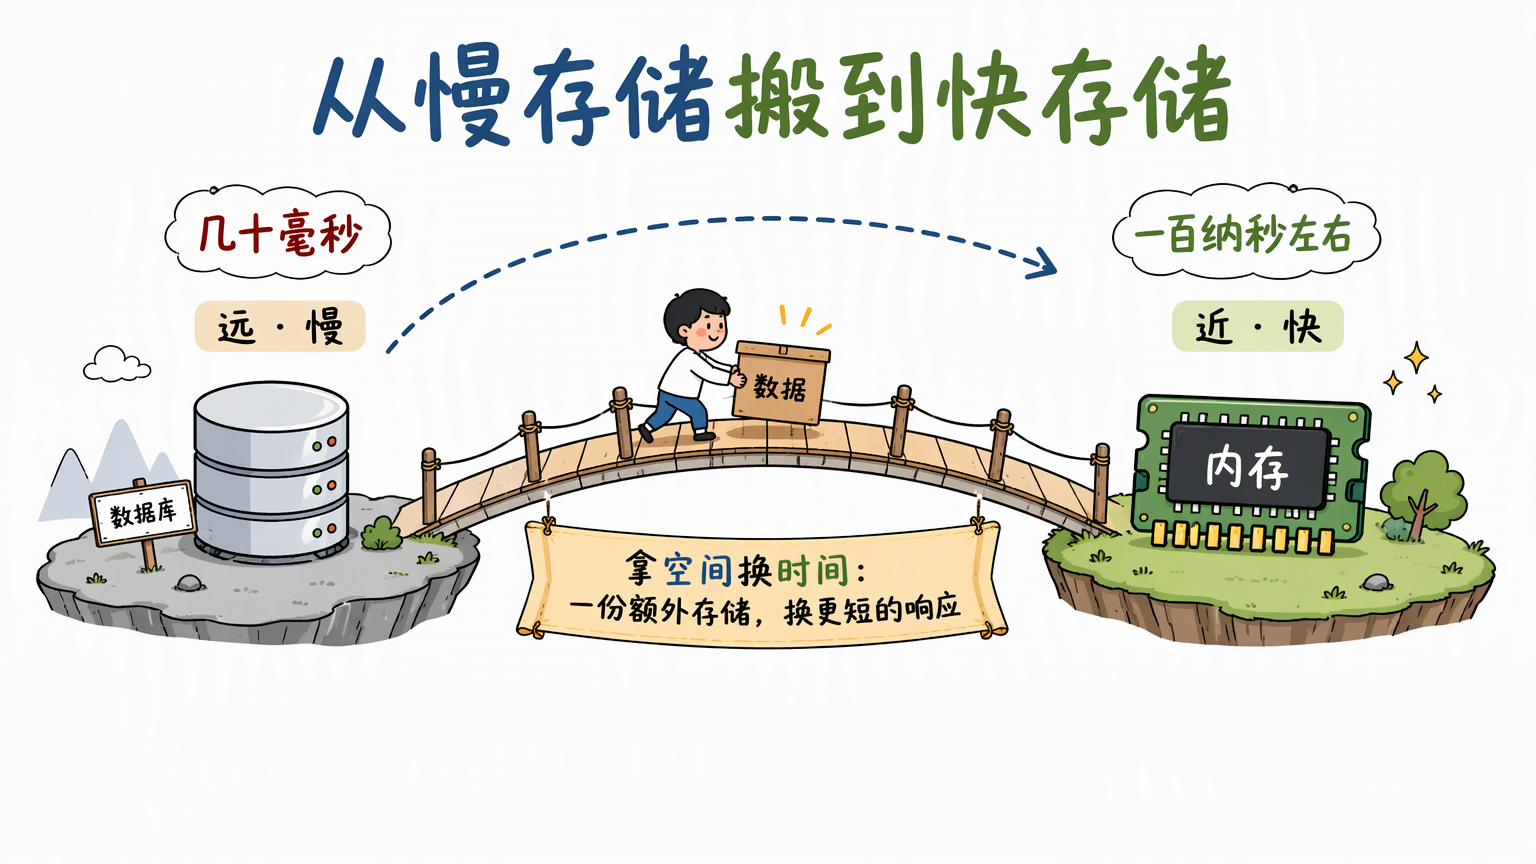
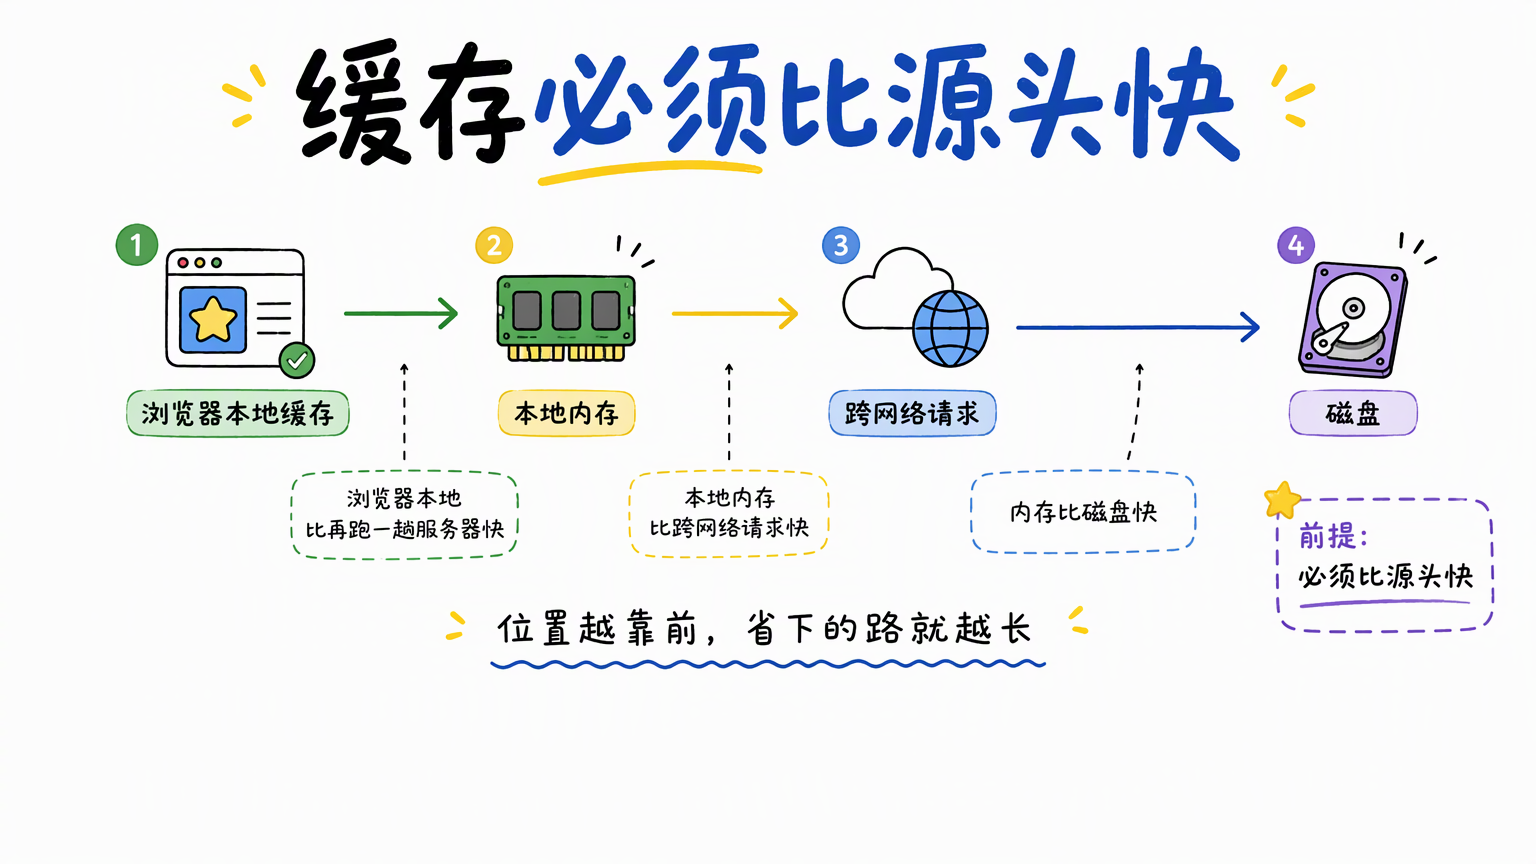
这里有个前提判断:缓存必须比源头快,否则加它没有意义。
内存比磁盘快,本地内存比跨网络请求快,浏览器本地比再跑一趟服务器快。缓存的位置越靠前,省下的路就越长。
命中率:衡量缓存好不好用的指标
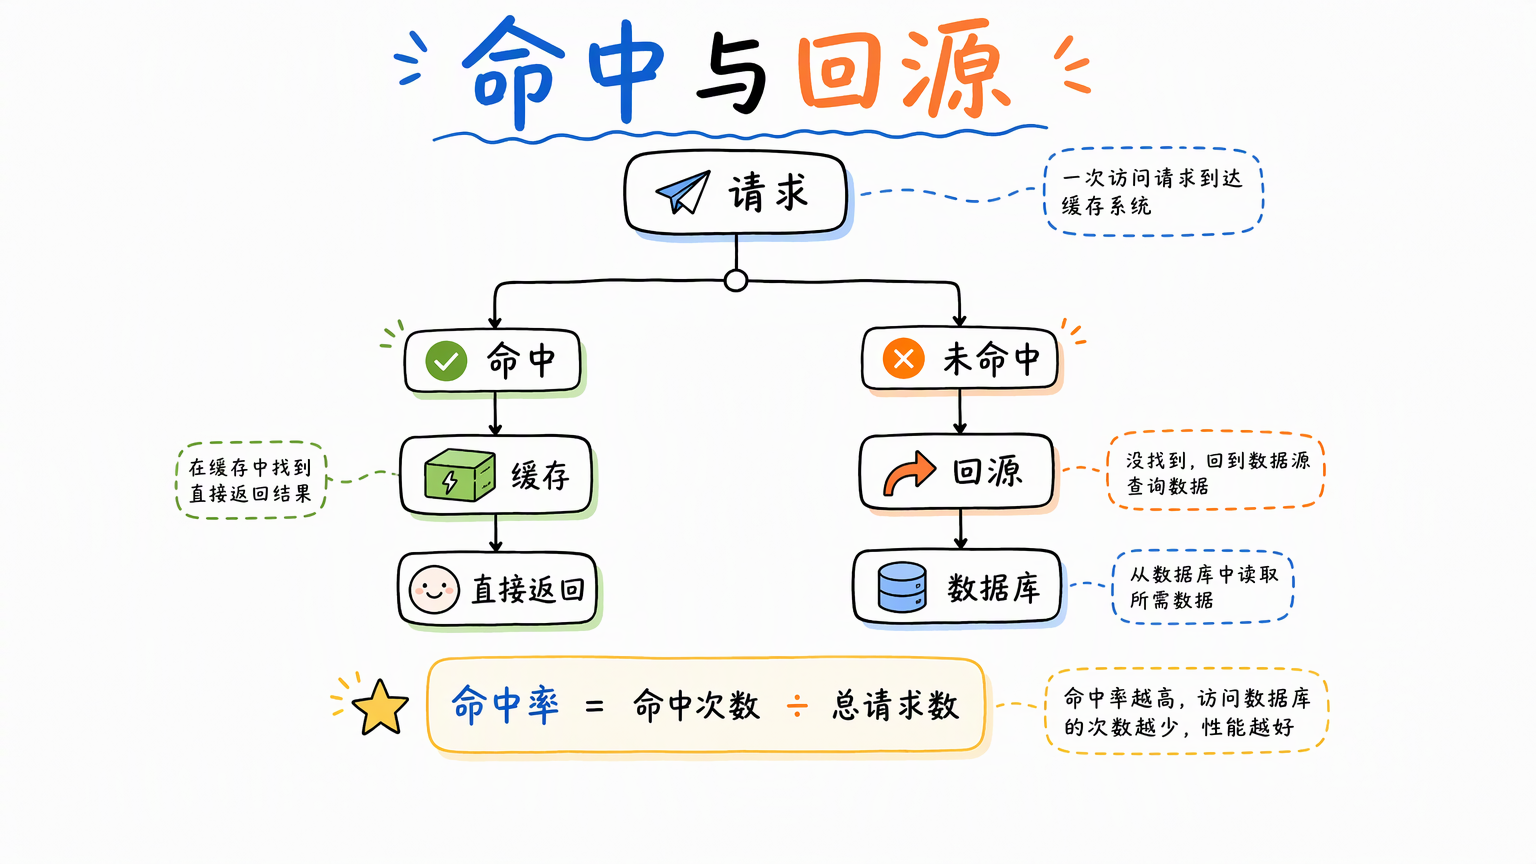
缓存好不好用,看一个指标:命中率。请求来了,在缓存里找到了,叫命中,直接返回;没找到,叫未命中,只能回源头去查,这一步通常叫回源。命中率就是命中次数占总请求数的比例。
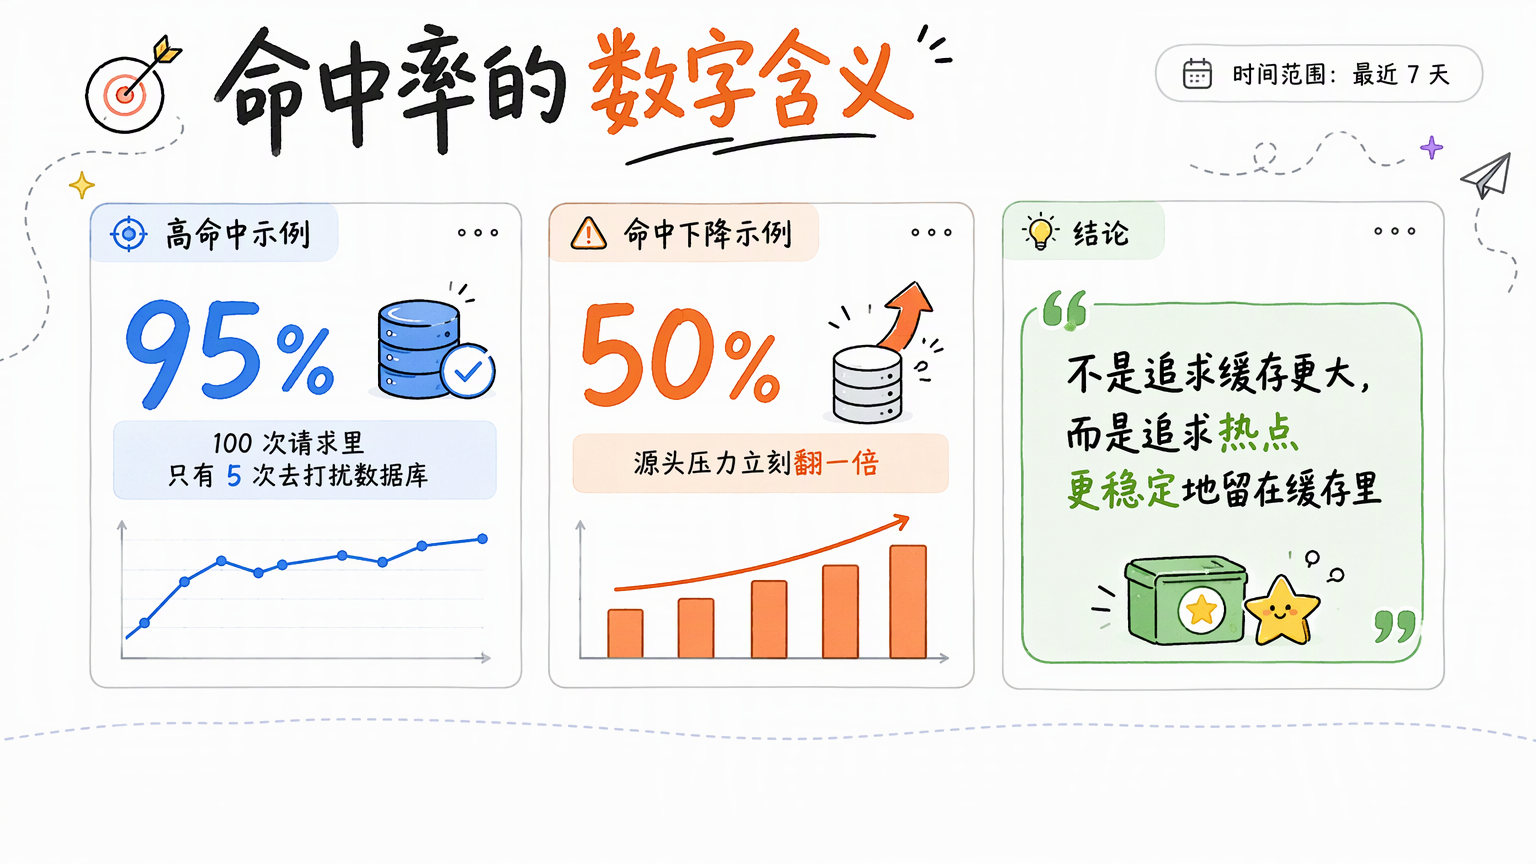
这个数字很直观。命中率百分之九十五,意味着一百次请求里只有五次真的去打扰数据库。
命中率掉到百分之五十,源头的压力立刻翻一倍。所以优化缓存,往往不是追求缓存更大,而是追求热点更稳定地留在缓存里。
代价:内存要花钱,数据会旧
但缓存不是免费的。一个代价是内存要花钱,另一个代价更要紧:数据会旧。
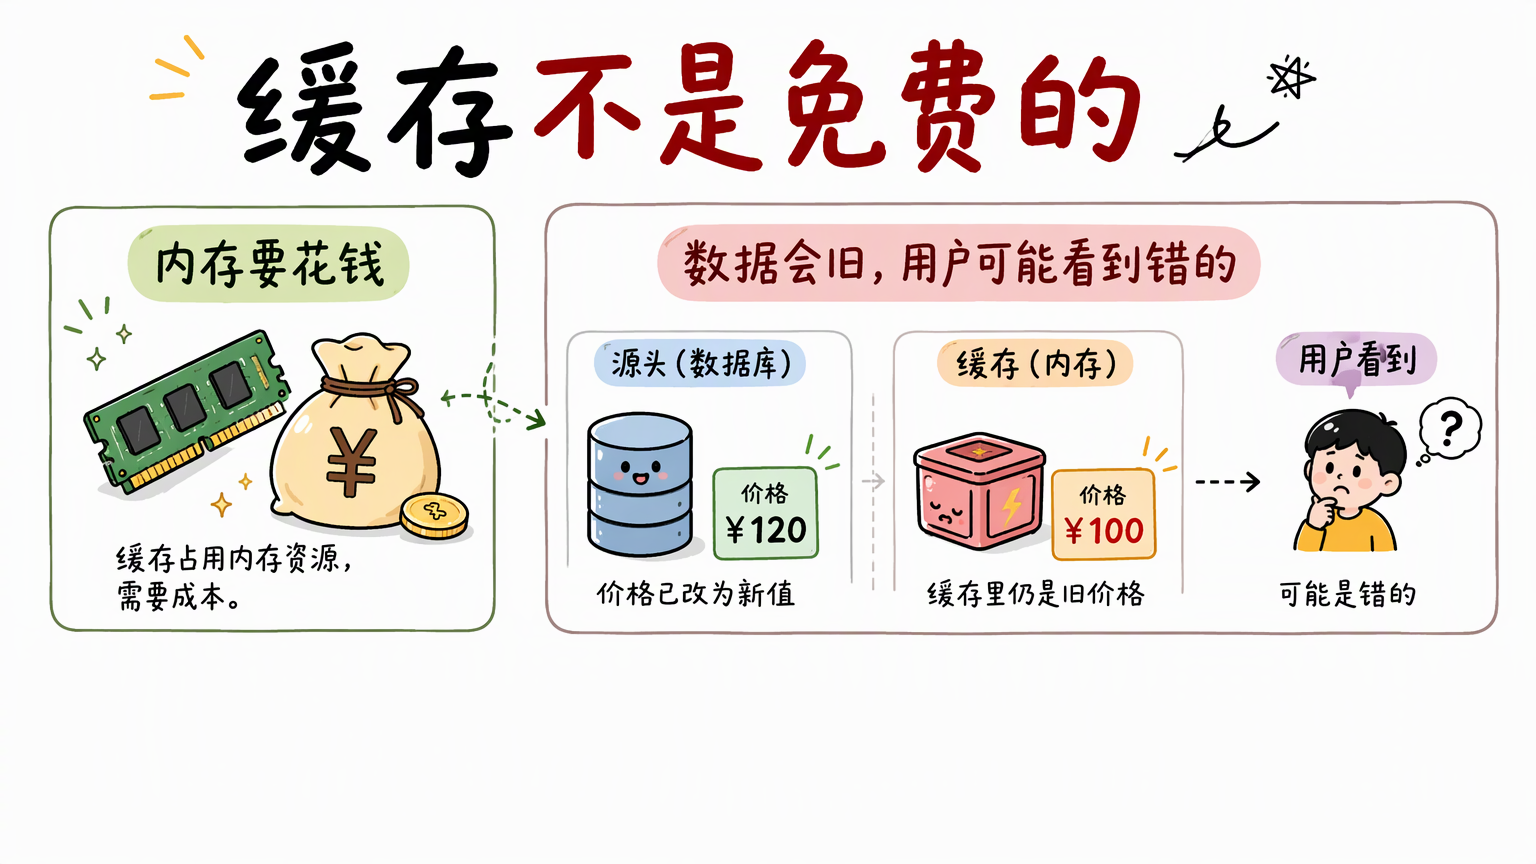
源头把价格改了,缓存里还是旧价格,用户看到的就可能是错的。
过期与淘汰:两个绕不开的问题
这就引出两个绕不开的问题:数据什么时候作废,内存满了先扔谁。
前者靠过期时间,比如设六十秒,到点就重新取;如果没到点源头就变了,就要主动删除或通知更新,这就是一致性维护。
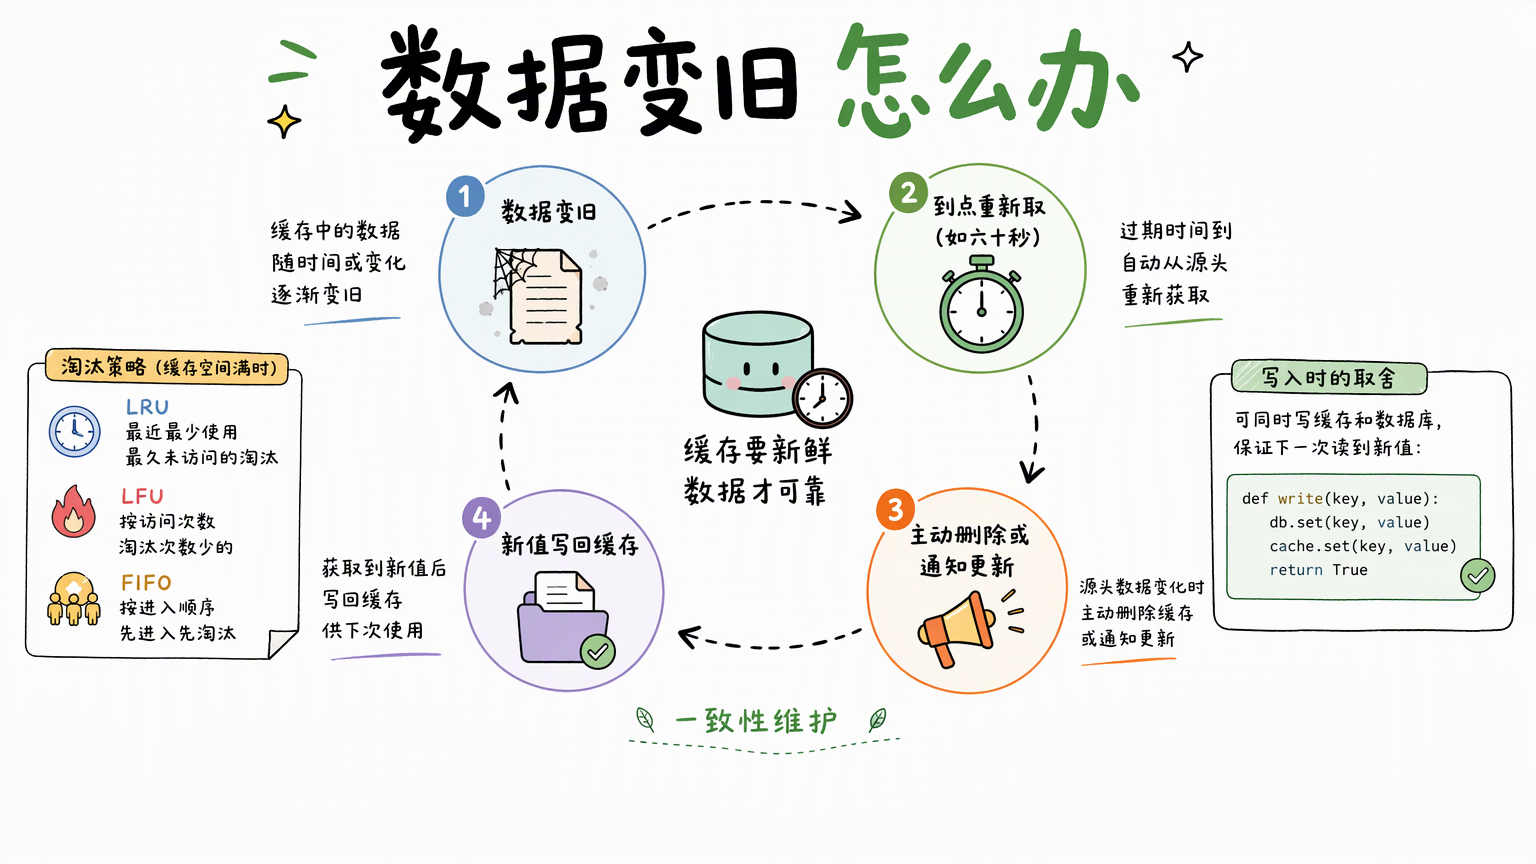
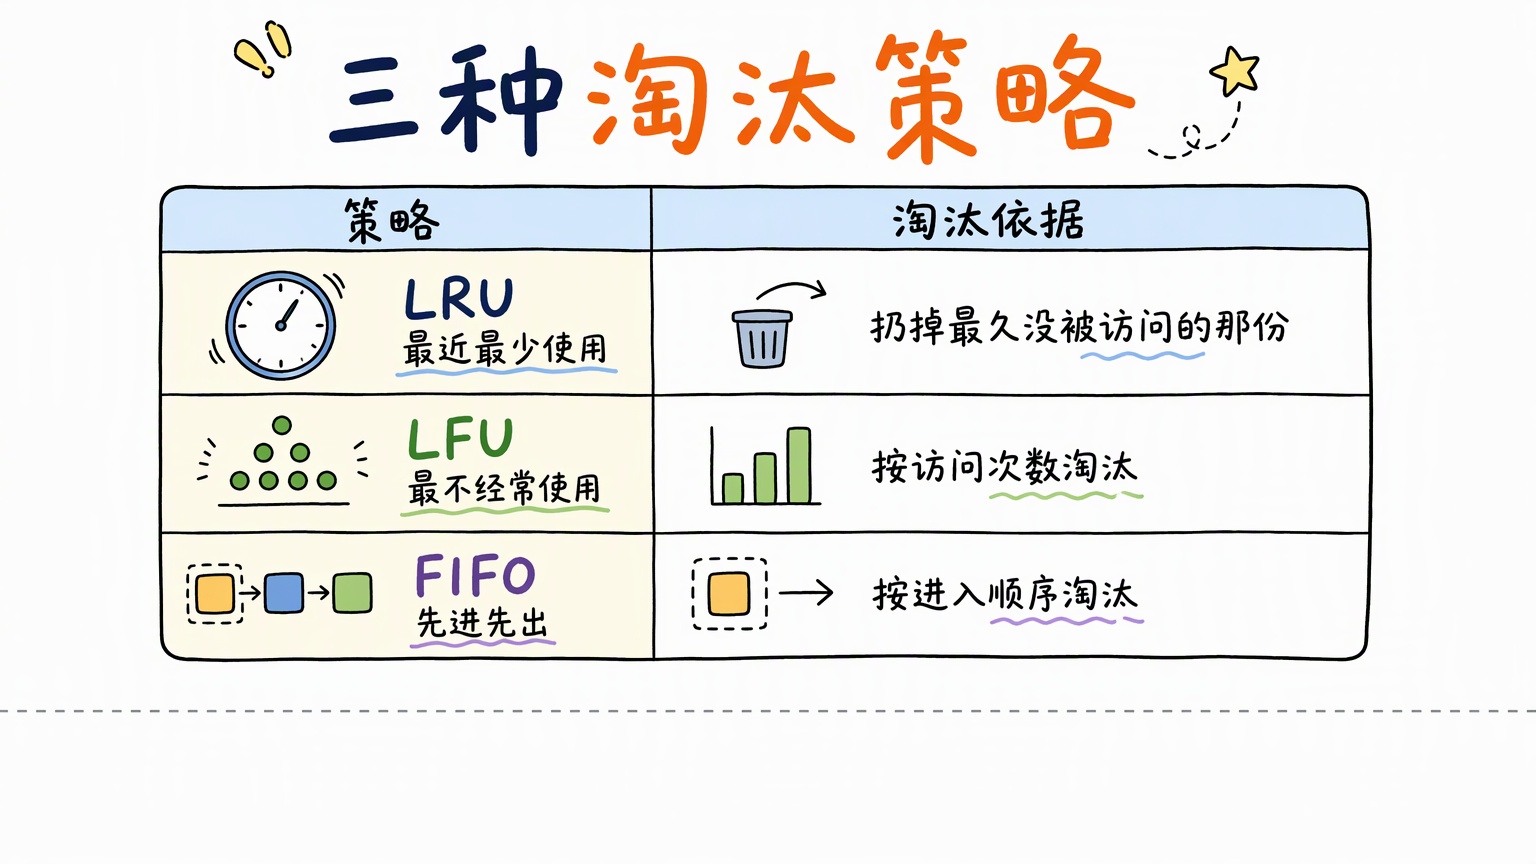
后者靠淘汰策略,最常用的是 LRU,最近最少使用,把最久没被访问的那份扔掉,因为它大概已经不热门了。还有按访问次数淘汰的 LFU,和按进入顺序淘汰的 FIFO。
写入时的取舍
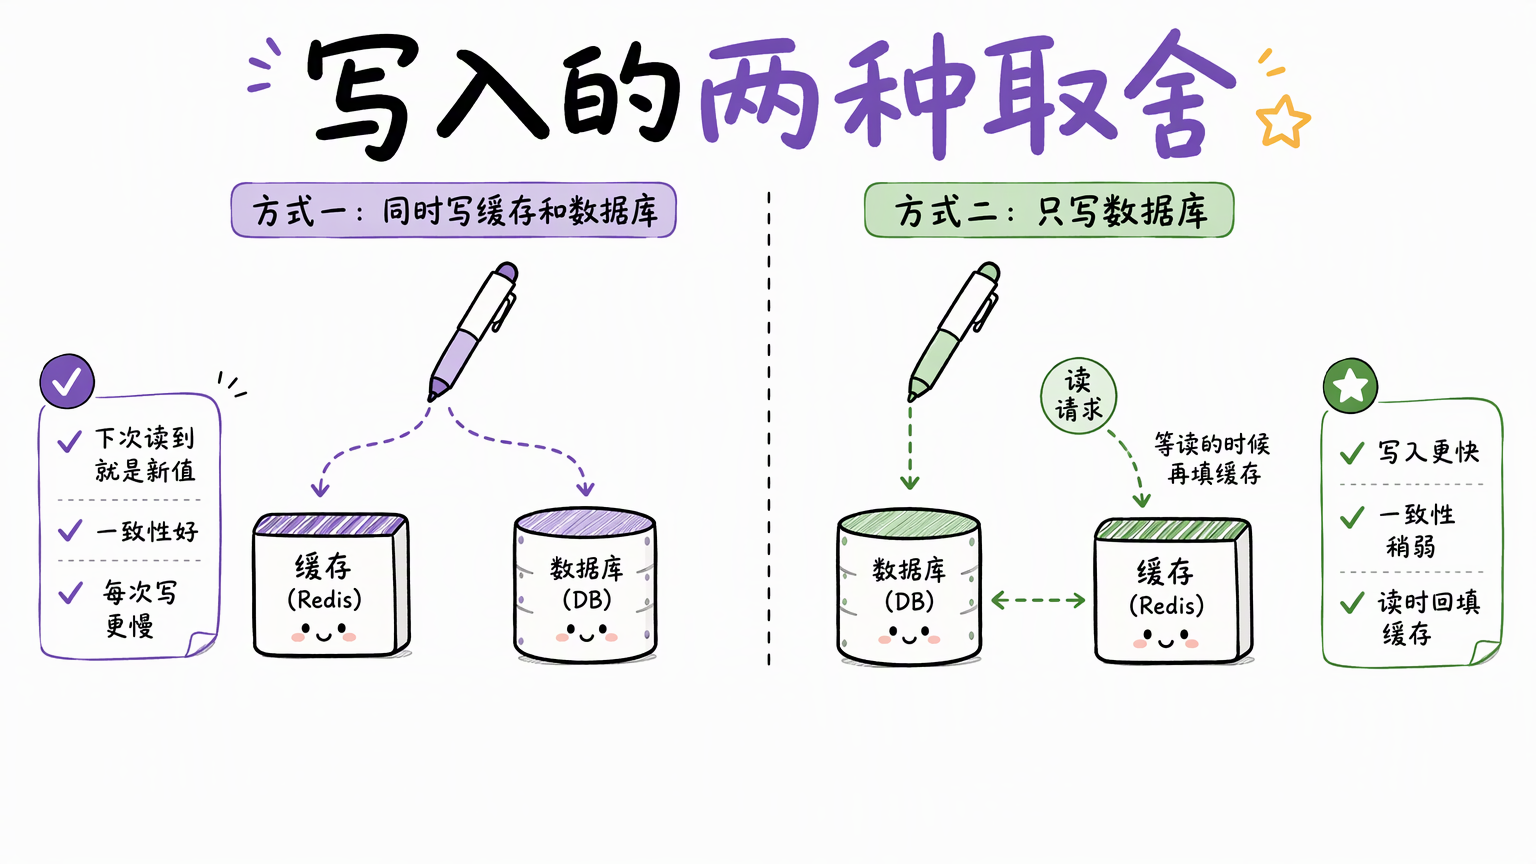
写入的时候也有取舍。可以同时写缓存和数据库,保证下一次读到的就是新值;也可以只写数据库,等读的时候再把缓存填上。前者一致性好,代价是每次写都更慢。
真实系统里,缓存是一串而不是一层
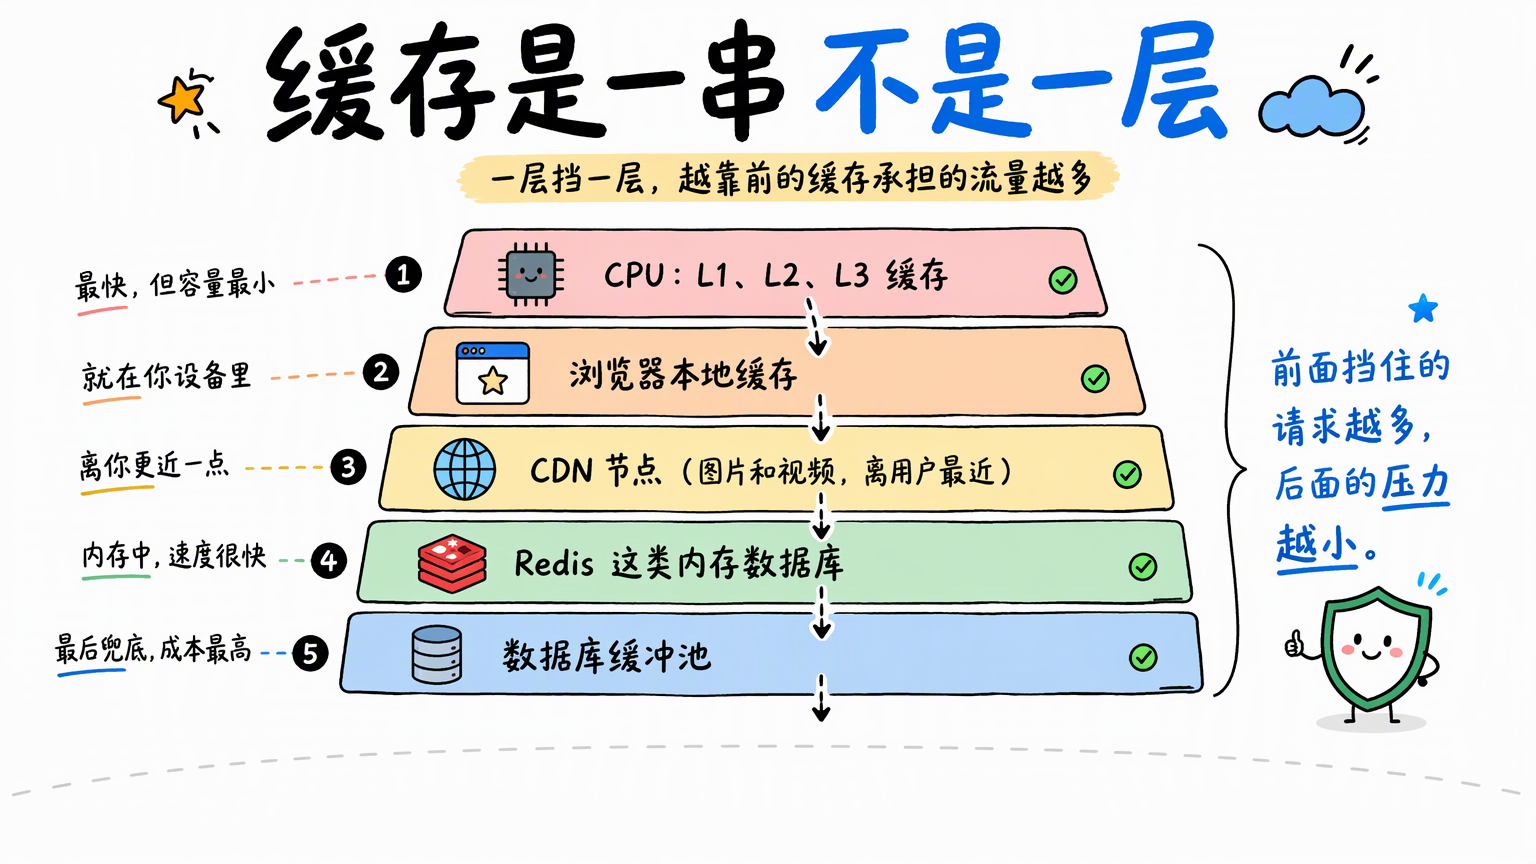
实际系统里,缓存不是一层,而是一串。CPU 里有 L1、L2、L3 缓存,浏览器里有本地缓存,图片和视频放在离用户最近的 CDN 节点,应用层常用 Redis 这类内存数据库,数据库自己还有缓冲池。一层挡一层,前面挡住的请求越多,后面的压力越小。
一个常见场景:商品详情页
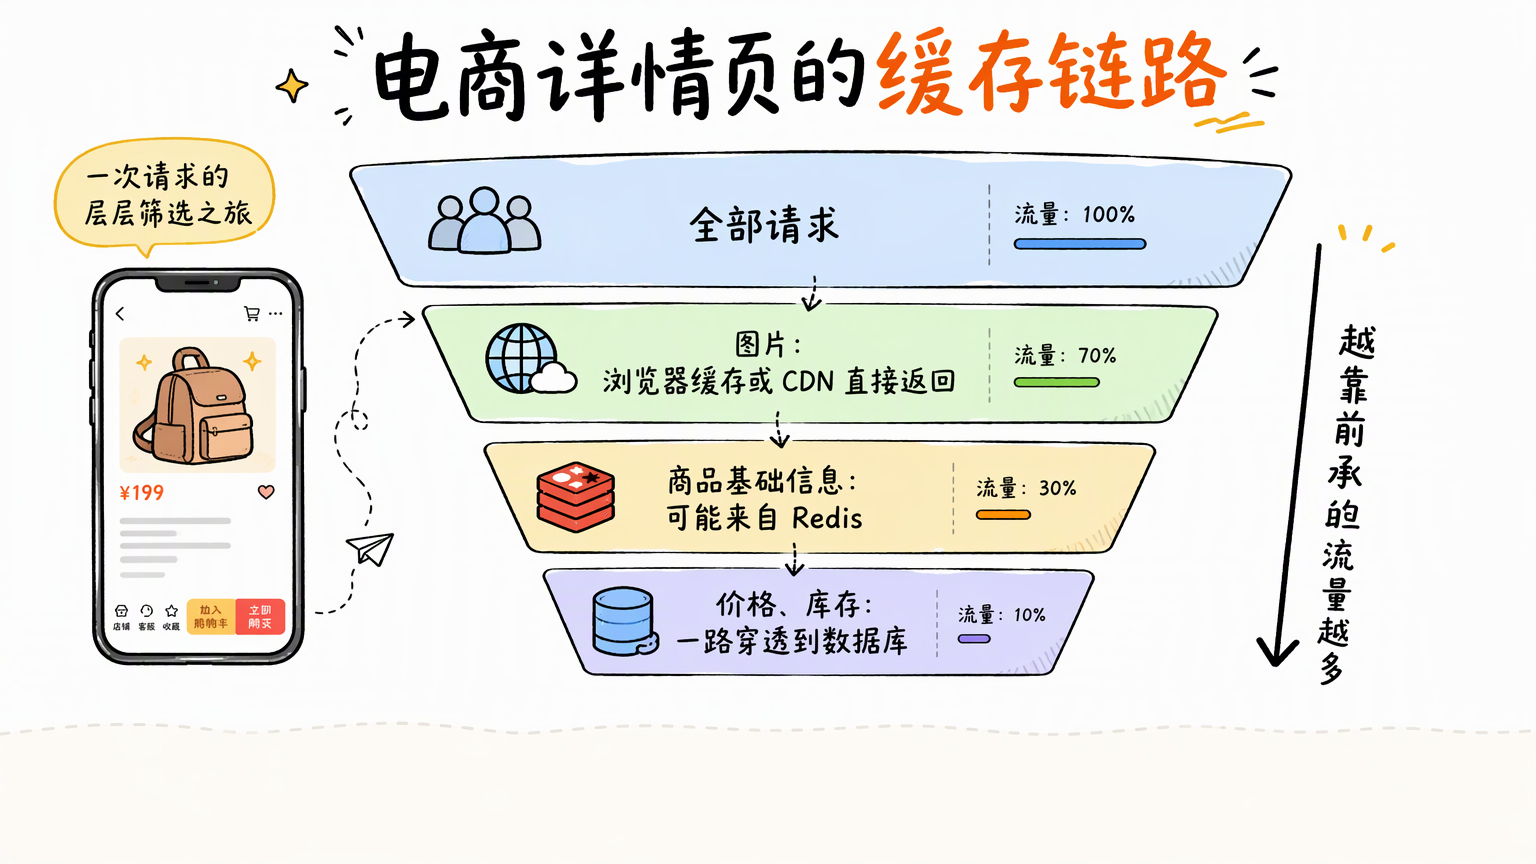
看一个常见场景。你打开电商的商品详情页,图片大概率直接由浏览器缓存或 CDN 返回,商品基础信息可能来自 Redis,只有价格、库存这种必须最新的数据才一路穿透到数据库。整条链路上,越靠前的缓存承担的流量越多。
常见误区:缓存穿透、击穿与雪崩
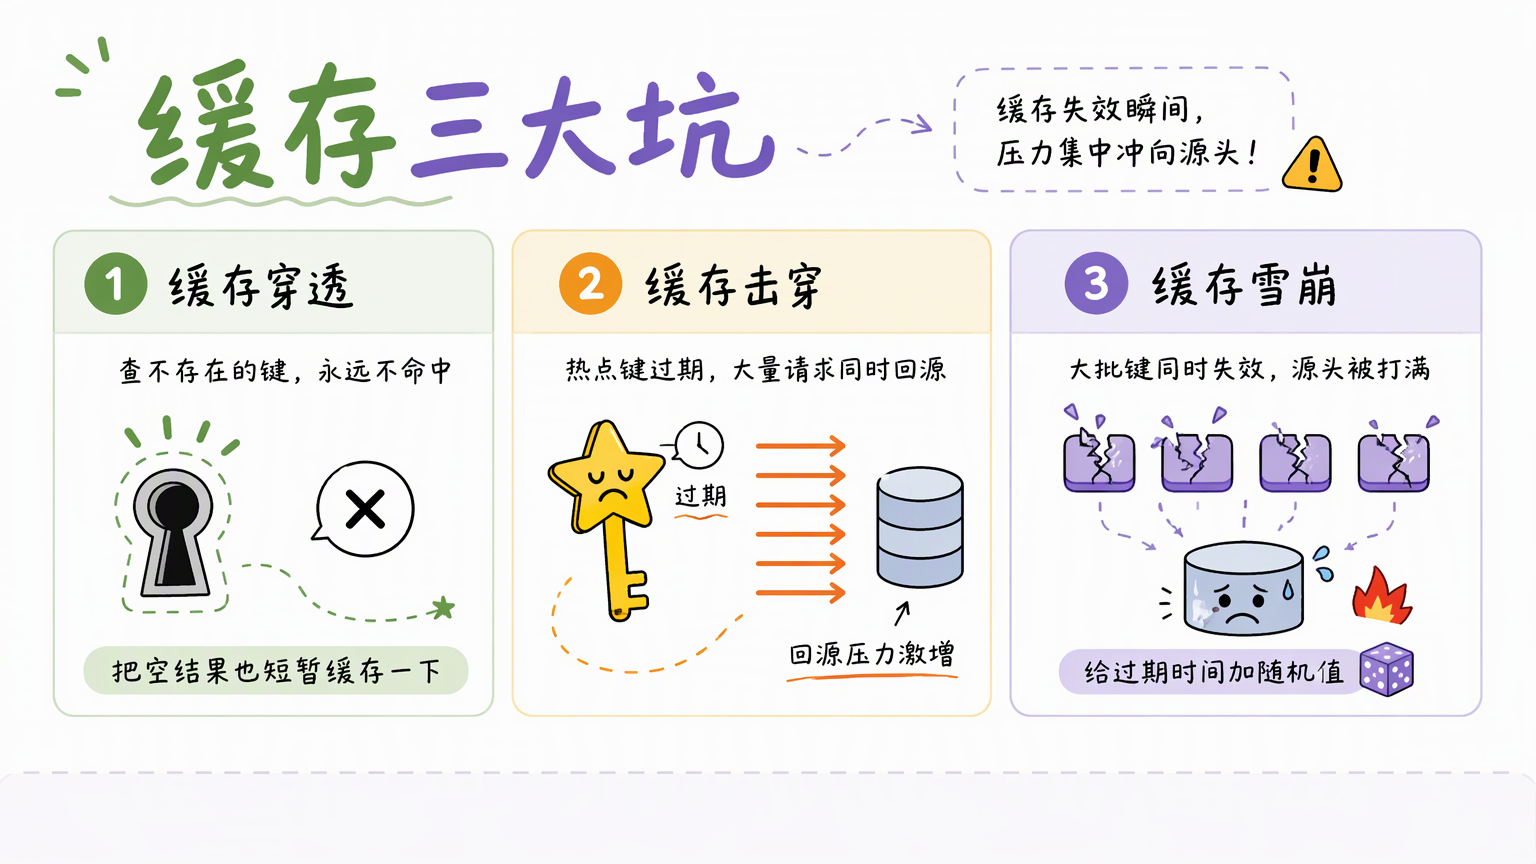
用缓存也有踩坑的地方。查一个数据库里根本不存在的键,缓存永远命中不了,请求每次都打到数据库,这叫缓存穿透,常见办法是把空结果也短暂缓存一下。
某个热点键刚好过期,大量请求同时回源,这叫缓存击穿。
一大批键在同一时刻失效,源头瞬间被打满,这叫缓存雪崩,通常给过期时间加随机值来打散。
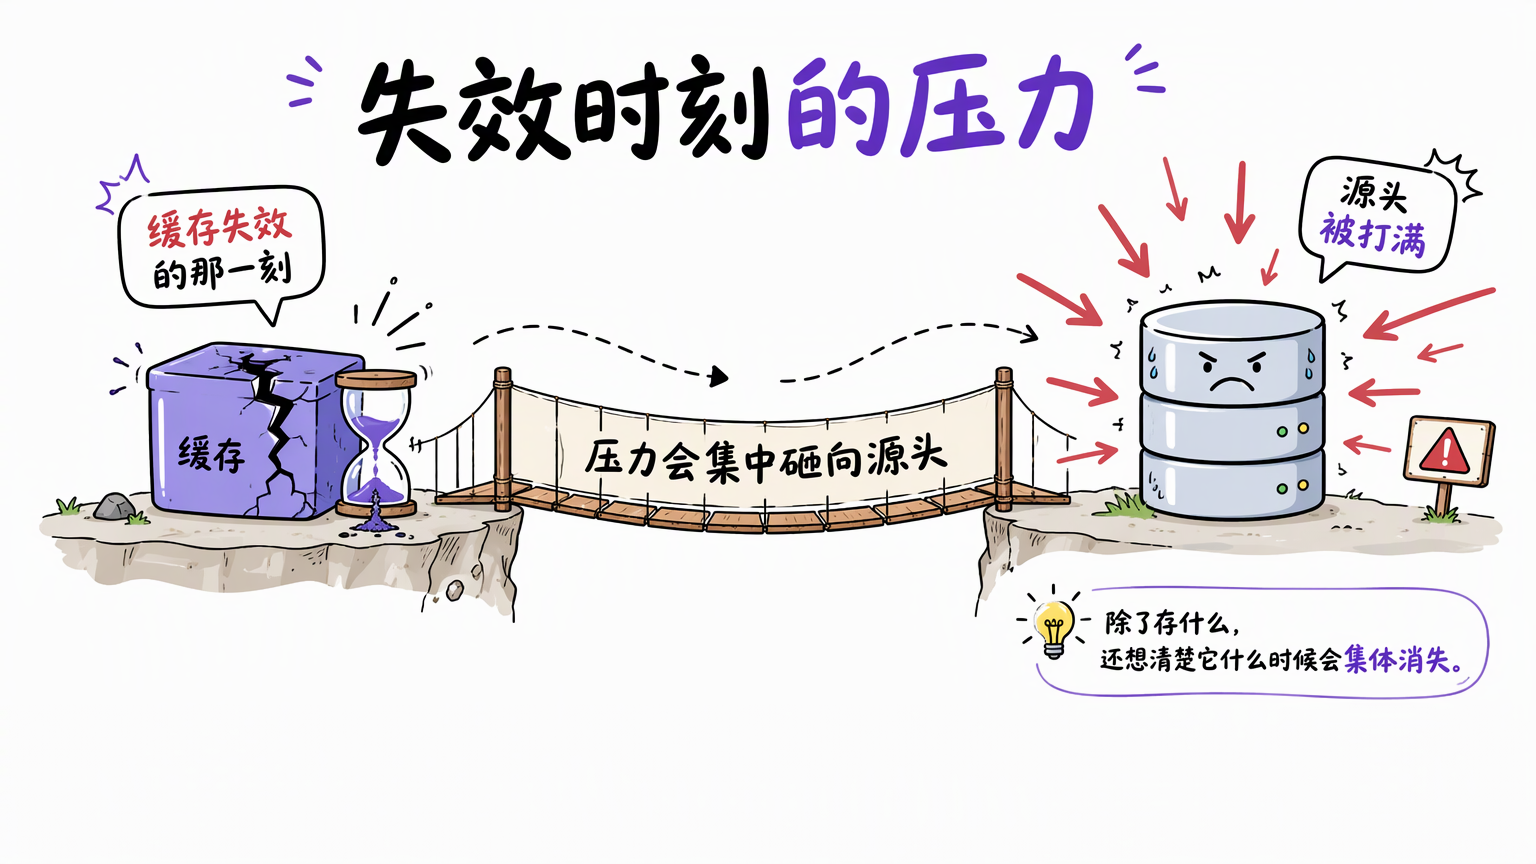
这些问题的共同点是,缓存失效的那一刻,压力会集中砸向源头。所以设计缓存时,除了想清楚存什么,还得想清楚它什么时候会集体消失。
什么数据值得缓存
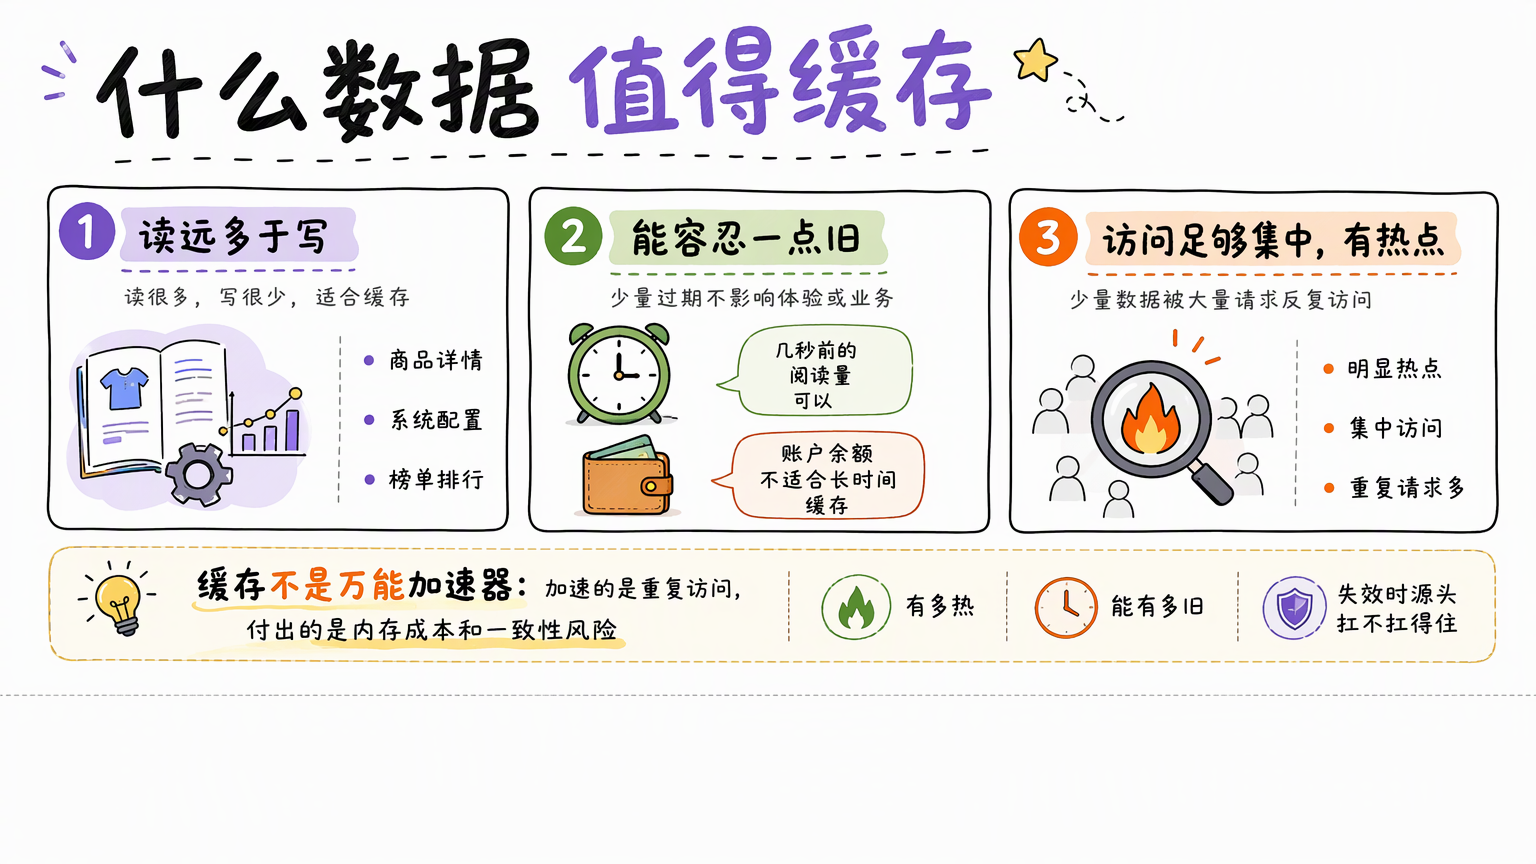
回到最实际的问题:什么数据值得缓存。
第一条,读远多于写,比如商品详情、系统配置、榜单排行。
第二条,能容忍一点旧,几秒前的阅读量可以接受,账户余额就不适合长时间缓存。
第三条,访问足够集中,有明显热点,缓存才有收益。
常见问题
缓存一定要比源头快吗? 是。缓存必须比源头快,否则加它没有意义;内存比磁盘快,本地内存比跨网络请求快,浏览器本地比再跑一趟服务器快。
命中率低就该把缓存做得更大吗? 不一定。优化缓存往往不是追求缓存更大,而是追求热点更稳定地留在缓存里。
缓存里的数据和源头不一致怎么办? 用过期时间控制作废,比如设六十秒、到点重新取;如果没到点源头就变了,就要主动删除或通知更新,这就是一致性维护。
内存满了先扔谁? 靠淘汰策略。最常用的是 LRU,扔掉最久没被访问的那份;还有按访问次数淘汰的 LFU,和按进入顺序淘汰的 FIFO。
写入时怎么处理缓存? 可以同时写缓存和数据库,下一次读到的就是新值,一致性好但每次写更慢;也可以只写数据库,等读的时候再把缓存填上。
总结
所以缓存不是万能加速器。它加速的是重复访问,付出的是内存成本和一致性风险。想清楚数据有多热、能有多旧、失效时源头扛不扛得住,这三点决定一处缓存该不该加。