什么是让模型直接调用工具
让模型直接调用工具,是指模型输出结构化的工具名和参数,由 Agent 运行框架按名称找到处理函数并执行,而不是让模型先拼出一条 shell 命令,再由 shell 间接完成读写操作。
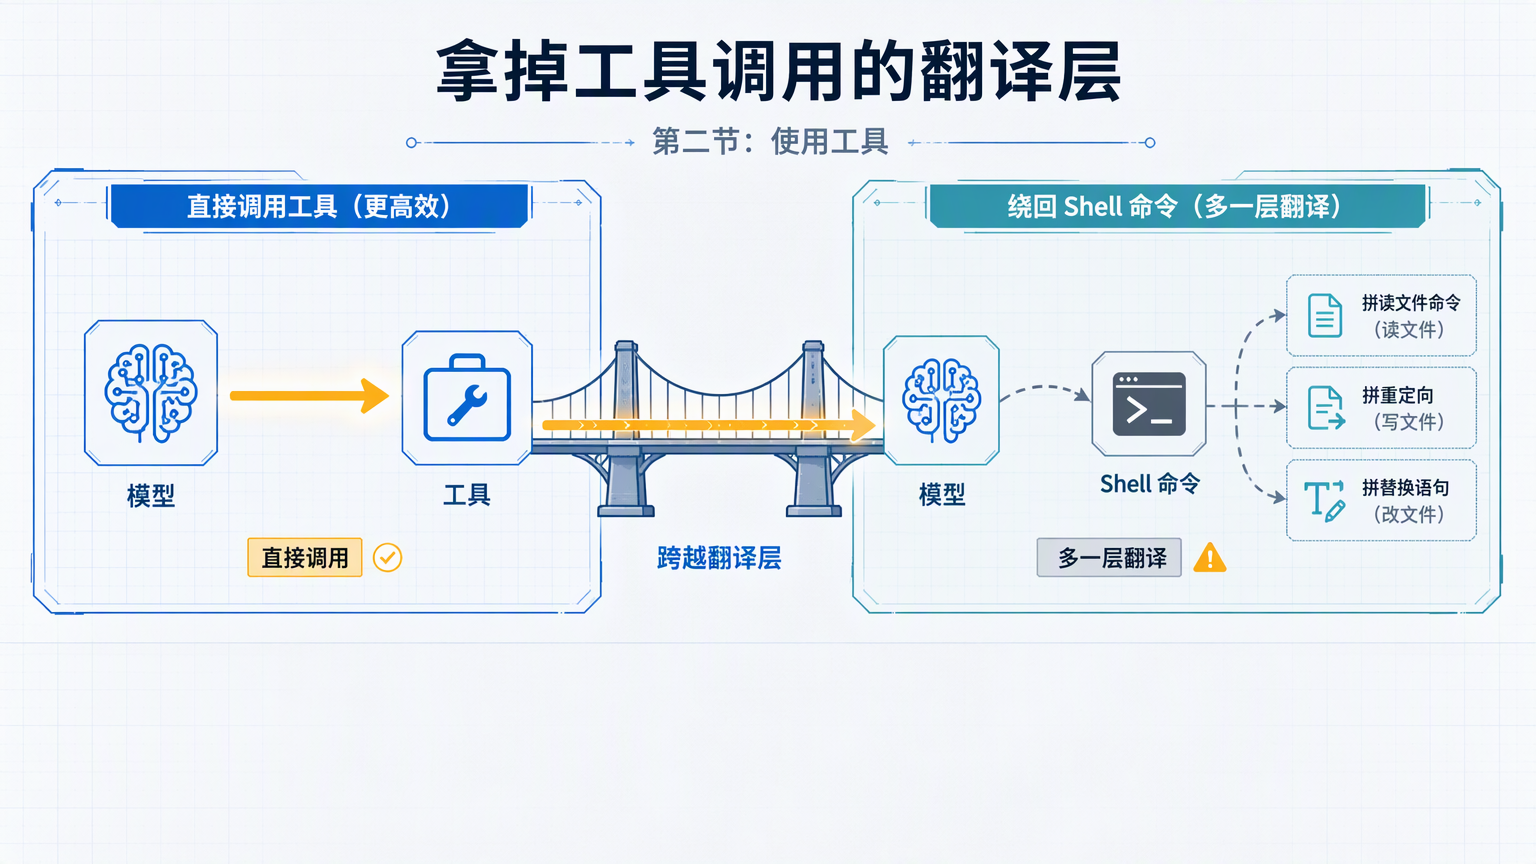
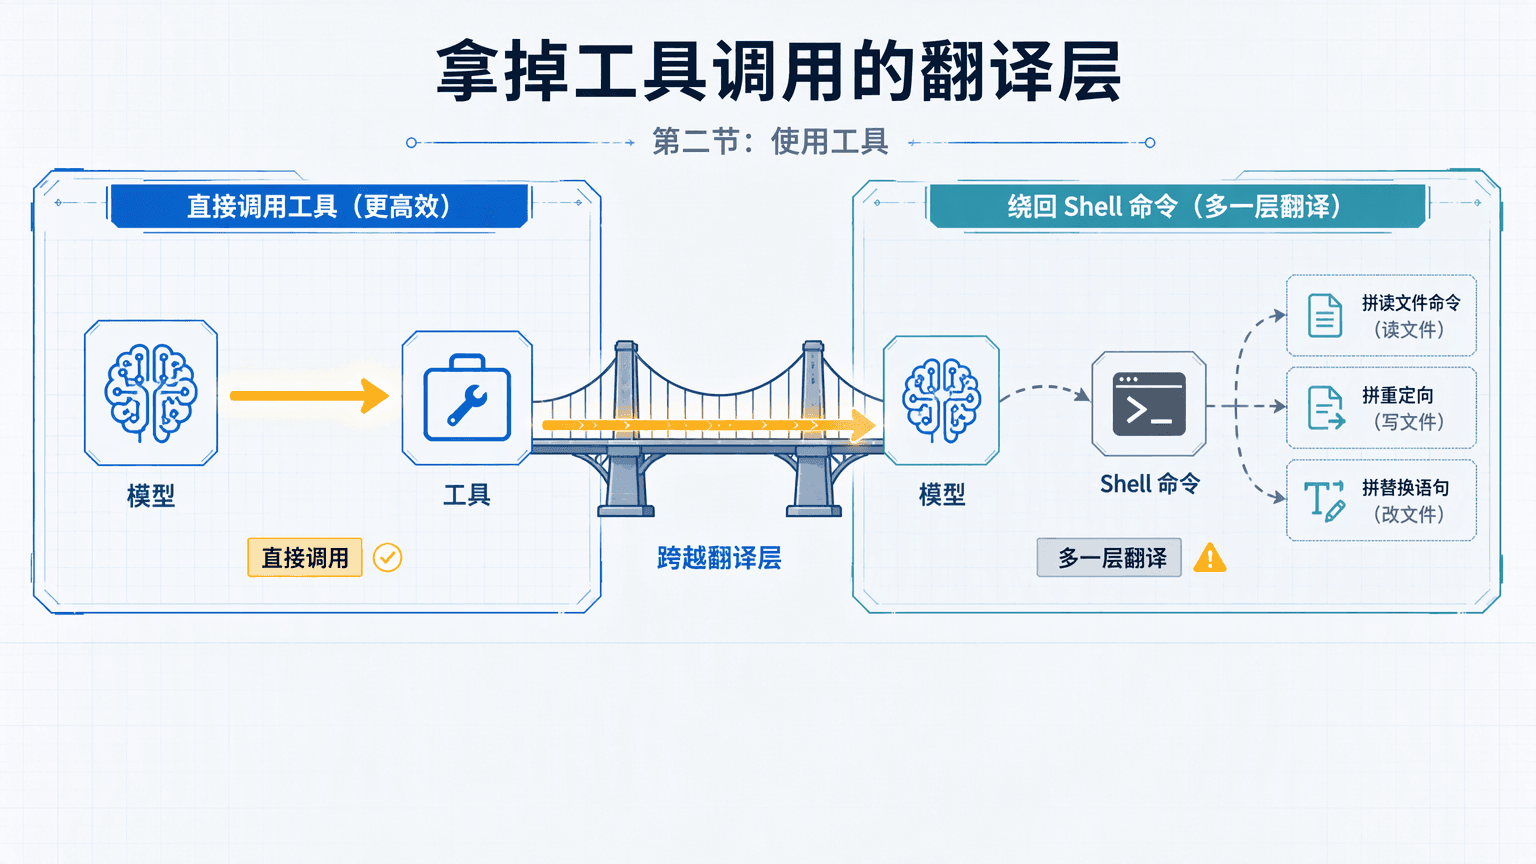
上一版里的 Agent 只有一个 bash 工具。模型明明只想“读这个文件”,却必须生成 cat 命令;写文件要拼重定向,改文件要拼替换语句。每一步都多了一层翻译,既增加 token 消耗,也增加转义、路径和命令语法出错的机会。
这一版把能力拆成五个明确工具:运行 shell、读文件、写文件、改文件和按模式找文件。模型可以直接请求 read_file,运行框架负责传入路径并返回内容。工具调用的核心变化可以概括为:模型表达操作意图,程序负责执行具体实现。
为什么要拿掉 bash 这层翻译
只有 bash 时,模型需要把一个高层目标翻译成低层命令。这个翻译会带来三类成本:
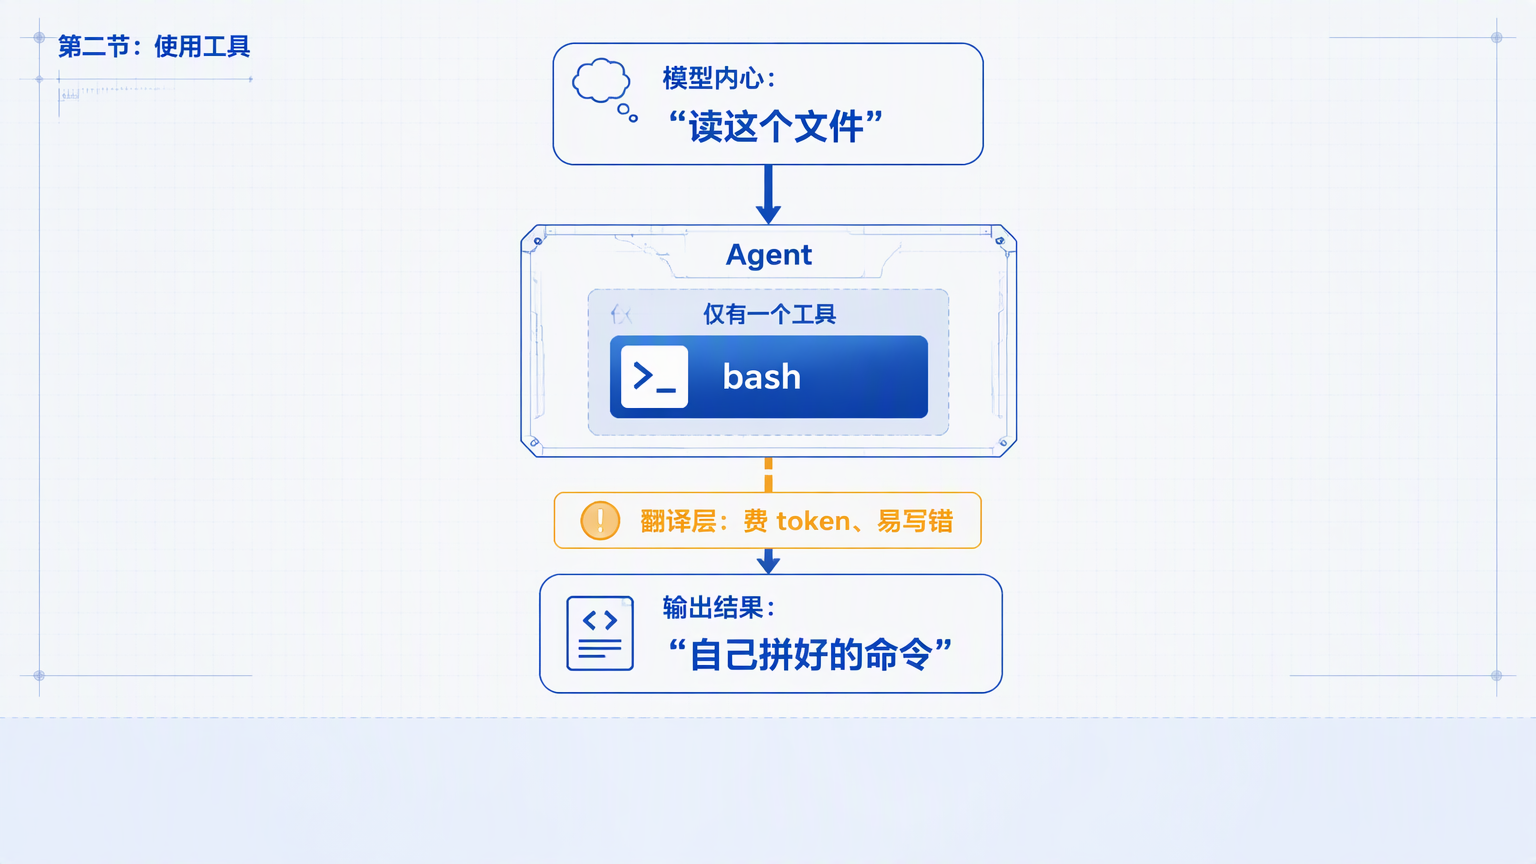
- Token 成本:命令、引号、转义和错误处理都要进入上下文。
- 执行风险:同一个目标可能被拼成不同命令,路径和重定向稍有错误就会产生意外结果。
- 控制成本:系统很难只允许“读一个文件”,却禁止命令顺手删除或覆盖其他文件。
直接工具调用把意图固定成参数边界。例如,read_file 只接受文件路径和可选行数;edit_file 只做一次指定文本替换。参数可以单独校验、记录和授权,执行逻辑也不再依赖模型是否正确掌握 shell 语法。
| 用户目标 | 只有 bash 时 | 直接工具调用后 | 主要收益 |
|---|---|---|---|
| 读取文件 | cat README.md | read_file(path="README.md") | 参数明确,容易限制输出范围 |
| 写入文件 | echo ... > file.txt | write_file(path, content) | 不需要处理 shell 转义 |
| 修改文件 | sed 或拼接替换命令 | edit_file(path, old, new) | 替换次数和失败条件可控 |
| 查找文件 | find 或 ls 组合命令 | glob(pattern="**/*.py") | 搜索意图与执行实现分离 |
因此,直接调用工具的价值不是把函数名换个写法,而是把模型需要承担的命令翻译工作移出上下文,让每项能力拥有可验证的接口。
这一版改了什么,循环为什么不用改
这一版的 agent loop 一行都没有动。调用模型、判断停止原因、把 assistant 消息追加回上下文、把 tool_result 放回消息列表,全部沿用上一版。唯一的变化发生在工具执行阶段:原来这里硬编码调用 run_bash,现在改成按工具名查表分发。
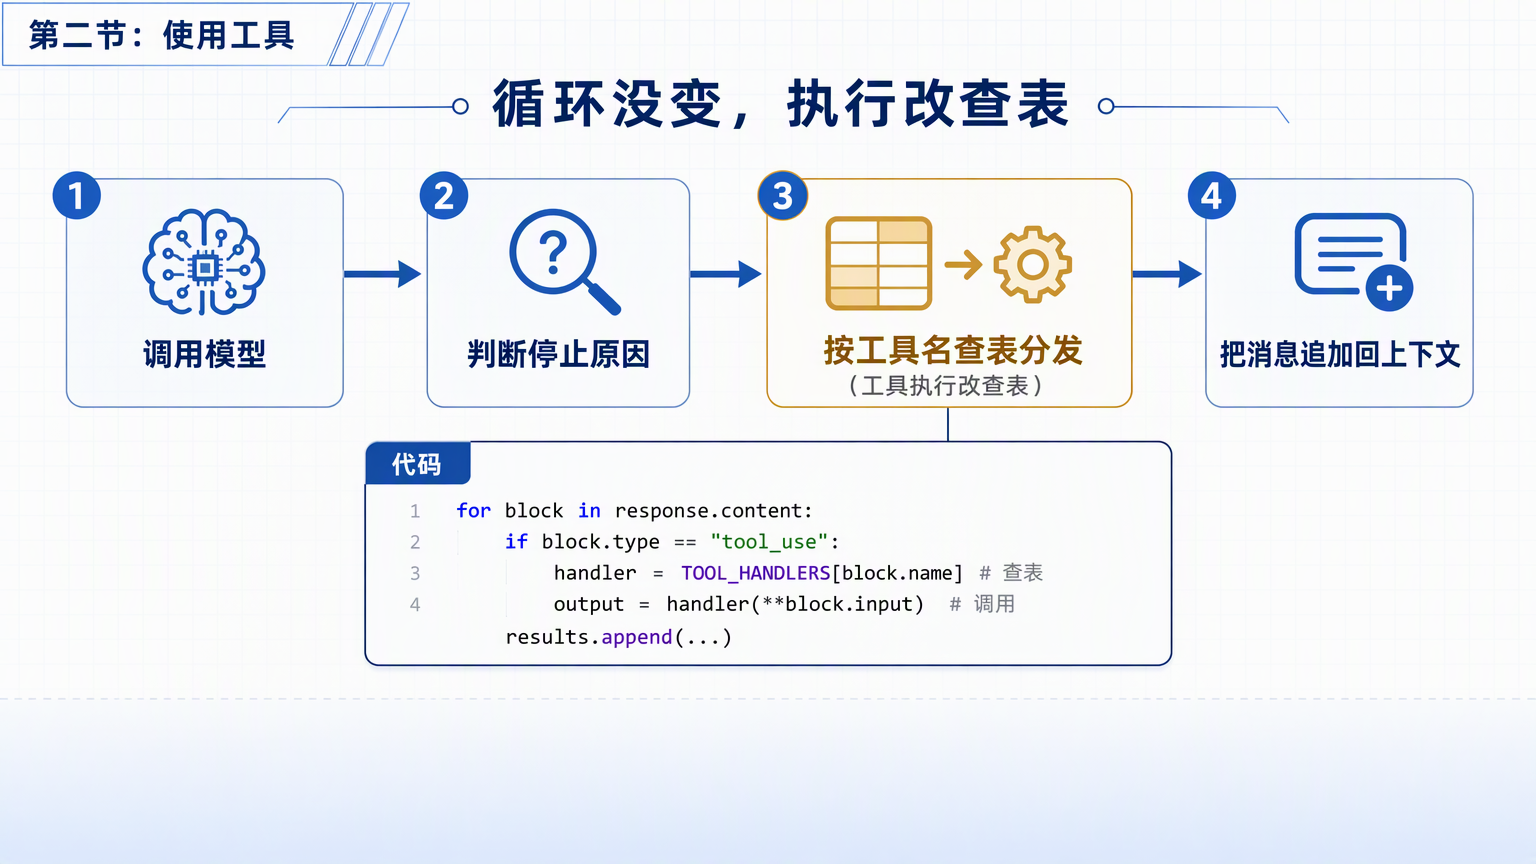
执行逻辑可以压缩成四步:
- 遍历模型响应中的内容块。
- 找出类型为
tool_use的块。 - 用
block.name查找处理函数。 - 把
block.input作为参数传入,并包装成tool_result。
for block in response.content:
    if block.type == "tool_use":
        handler = TOOL_HANDLERS[block.name]  # 查表
        output = handler(**block.input)      # 调用
        results.append({
            "type": "tool_result",
            "tool_use_id": block.id,
            "content": output,
        })
这里的关键是 block.name。模型返回 read_file 时,框架就找到 run_read;返回 glob 时,就找到 run_glob。循环只关心“收到一个工具调用并执行它”,不需要知道每个工具的具体业务逻辑。
五个工具分别负责什么
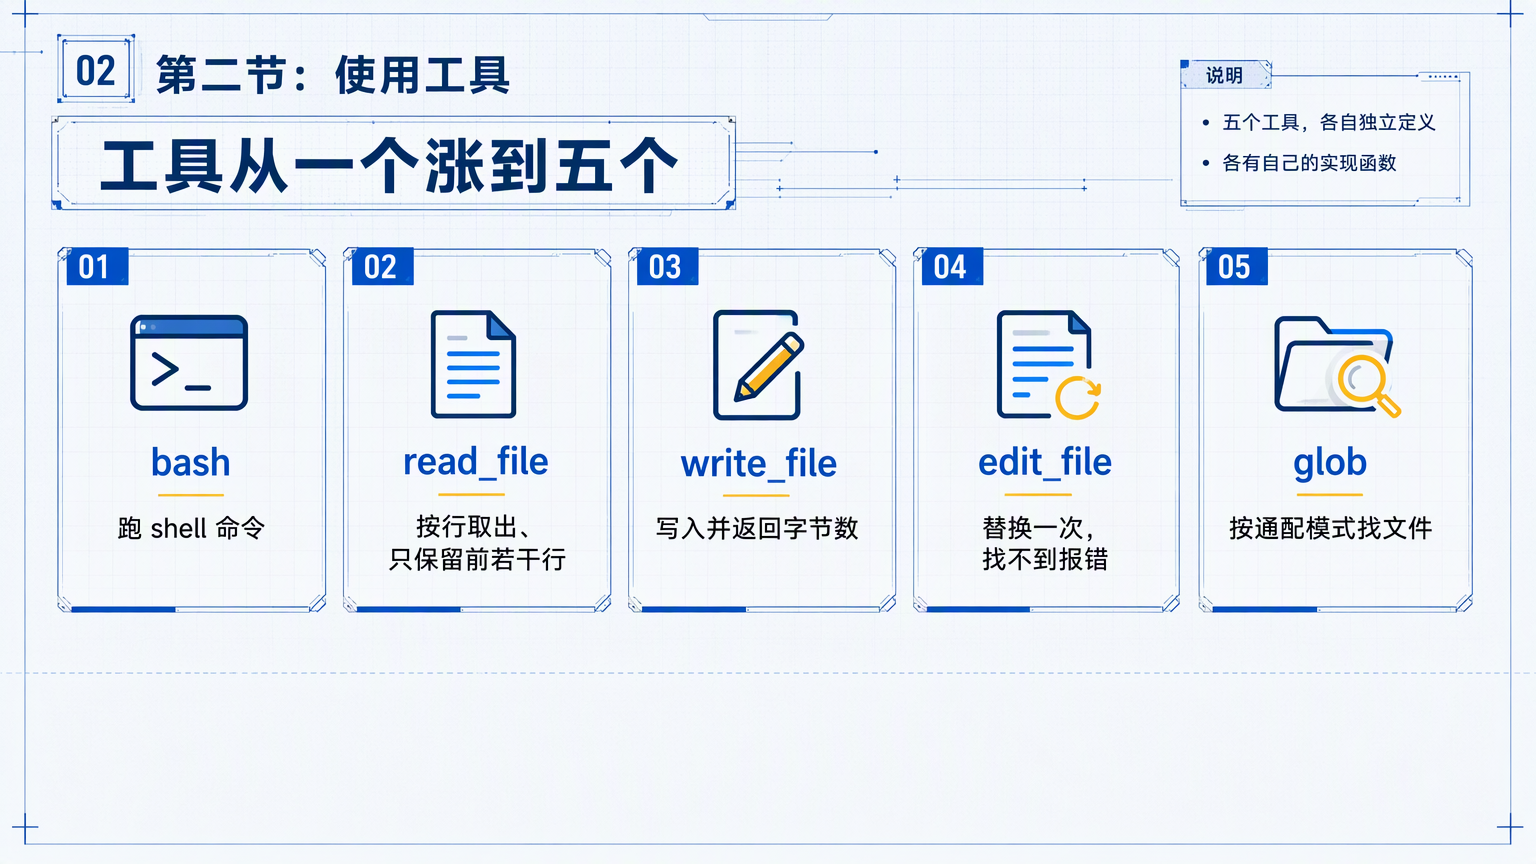
五个工具各自定义名称、描述、参数 schema 和实现函数。教学版可以把它们理解成下面这张清单:
| 工具 | 作用 | 教学版实现要点 |
|---|---|---|
bash | 运行 shell 命令 | 执行命令并返回标准输出或错误;本版没有路径保护 |
read_file | 读取文件内容 | 可按行取出,只保留前若干行 |
write_file | 写入文件 | 直接写入内容,返回写入字节数 |
edit_file | 修改文件 | 将指定文本替换一次,找不到时返回错误 |
glob | 按通配模式查找文件 | 返回匹配到的文件路径列表 |
文件类工具的实现不应该把所有能力重新塞回 shell。例如,run_read(path, max_lines) 可以使用语言自带的文件 API 打开文件、读取行并截断;这样上层运行时能明确知道它只是在读文件,不必猜一条 shell 命令到底会做什么。
工具定义只是清单,不会自己执行
工具定义的作用是告诉模型“我能做什么”,它本身不执行任何代码。模型依靠工具名、描述和参数 schema 决定该选择哪个工具,以及要填写哪些参数。
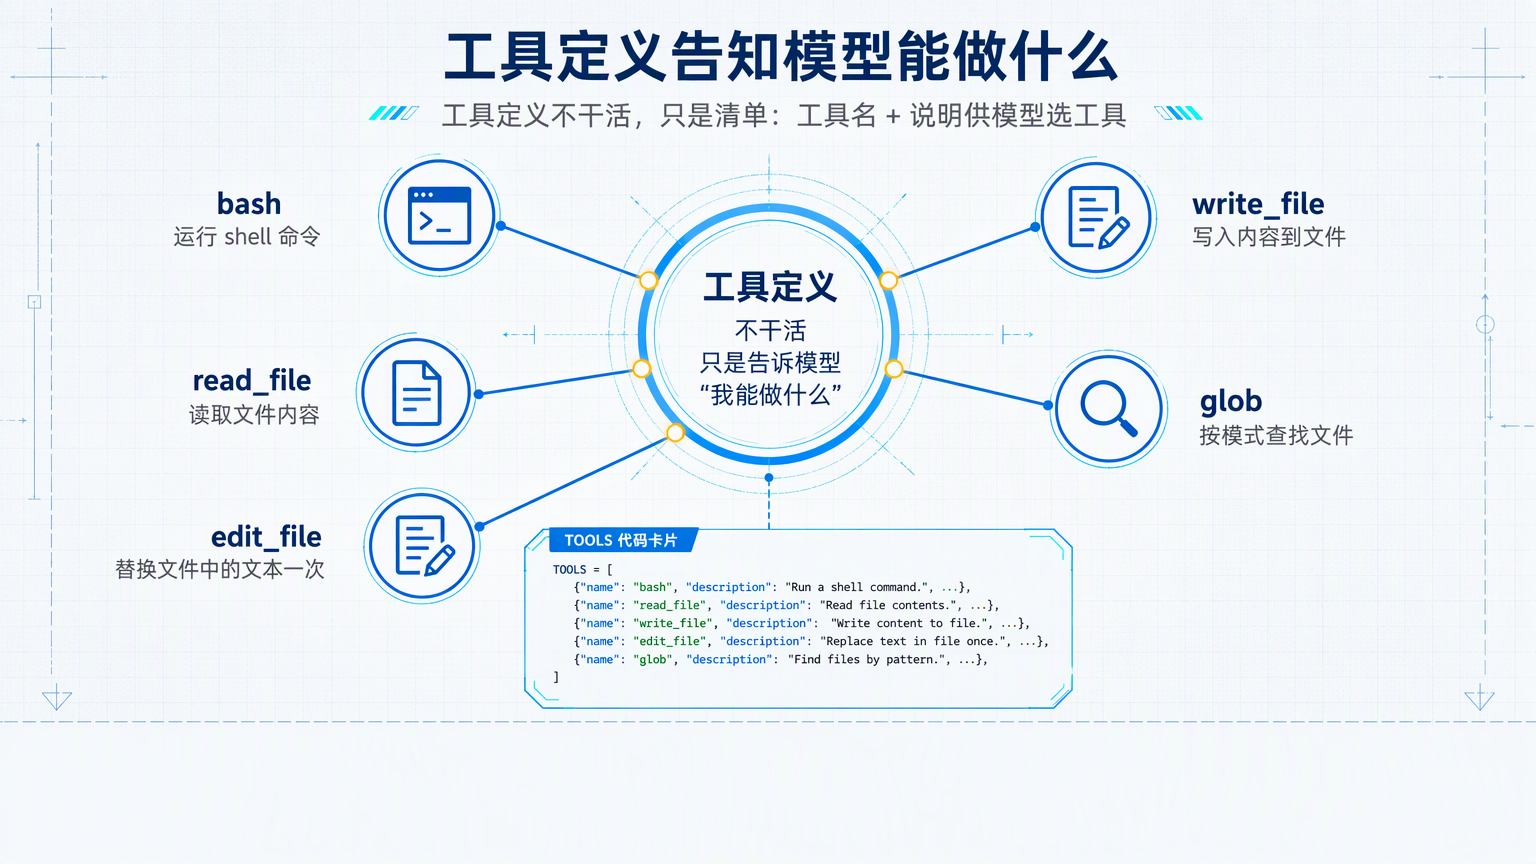
一个最小工具清单可以这样写:
TOOLS = [
    {
        "name": "bash",
        "description": "Run a shell command.",
        "input_schema": {
            "type": "object",
            "properties": {"command": {"type": "string"}},
            "required": ["command"],
        },
    },
    {
        "name": "read_file",
        "description": "Read file contents.",
        "input_schema": {
            "type": "object",
            "properties": {
                "path": {"type": "string"},
                "max_lines": {"type": "integer"},
            },
            "required": ["path"],
        },
    },
    {"name": "write_file", "description": "Write content to file.", "input_schema": {"type": "object"}},
    {"name": "edit_file", "description": "Replace text in file once.", "input_schema": {"type": "object"}},
    {"name": "glob", "description": "Find files by pattern.", "input_schema": {"type": "object"}},
]
实际项目里,每个 schema 还应完整描述参数类型、必填字段、长度和枚举范围。上面后三项为了突出结构省略了属性定义,不能直接当作生产校验规则。
映射表如何让工具执行可扩展
真正的分发依靠一张映射表:键是模型返回的工具名,值是对应的处理函数。
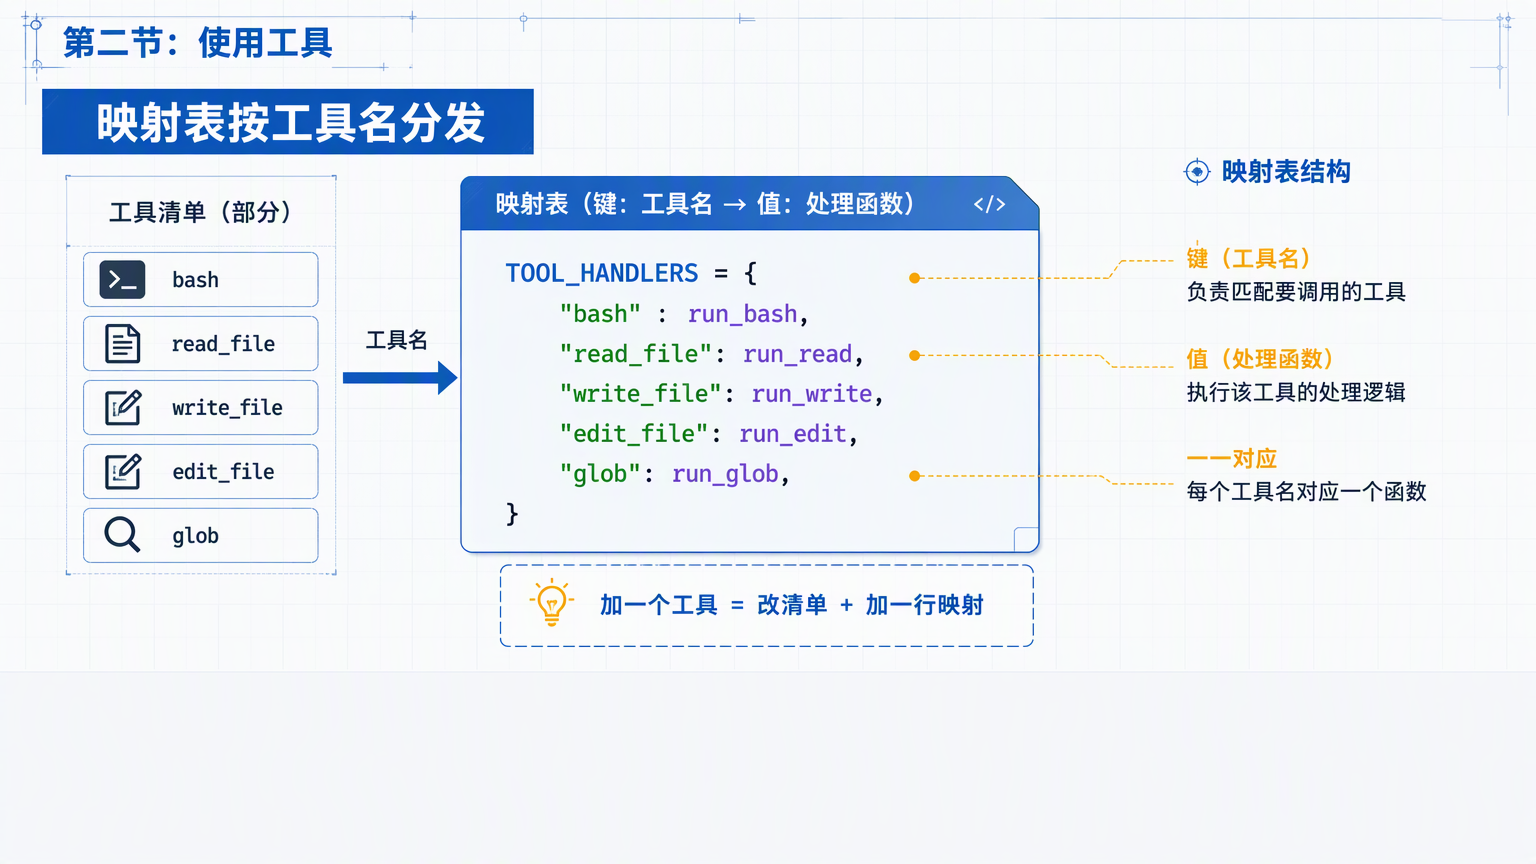
TOOL_HANDLERS = {
    "bash": run_bash,
    "read_file": run_read,
    "write_file": run_write,
    "edit_file": run_edit,
    "glob": run_glob,
}
新增一个工具时,只需要完成两件事:在 TOOLS 中加入定义,在 TOOL_HANDLERS 中加入映射。调用循环不需要修改,这就是查表分发相对于 if/elif 硬编码的扩展性。
生产代码还应处理未知工具名。查表失败时,运行框架应返回一个可解释的工具错误,或者直接停止本轮,而不是让 KeyError 变成没有上下文的崩溃。
多个工具调用应该怎样执行
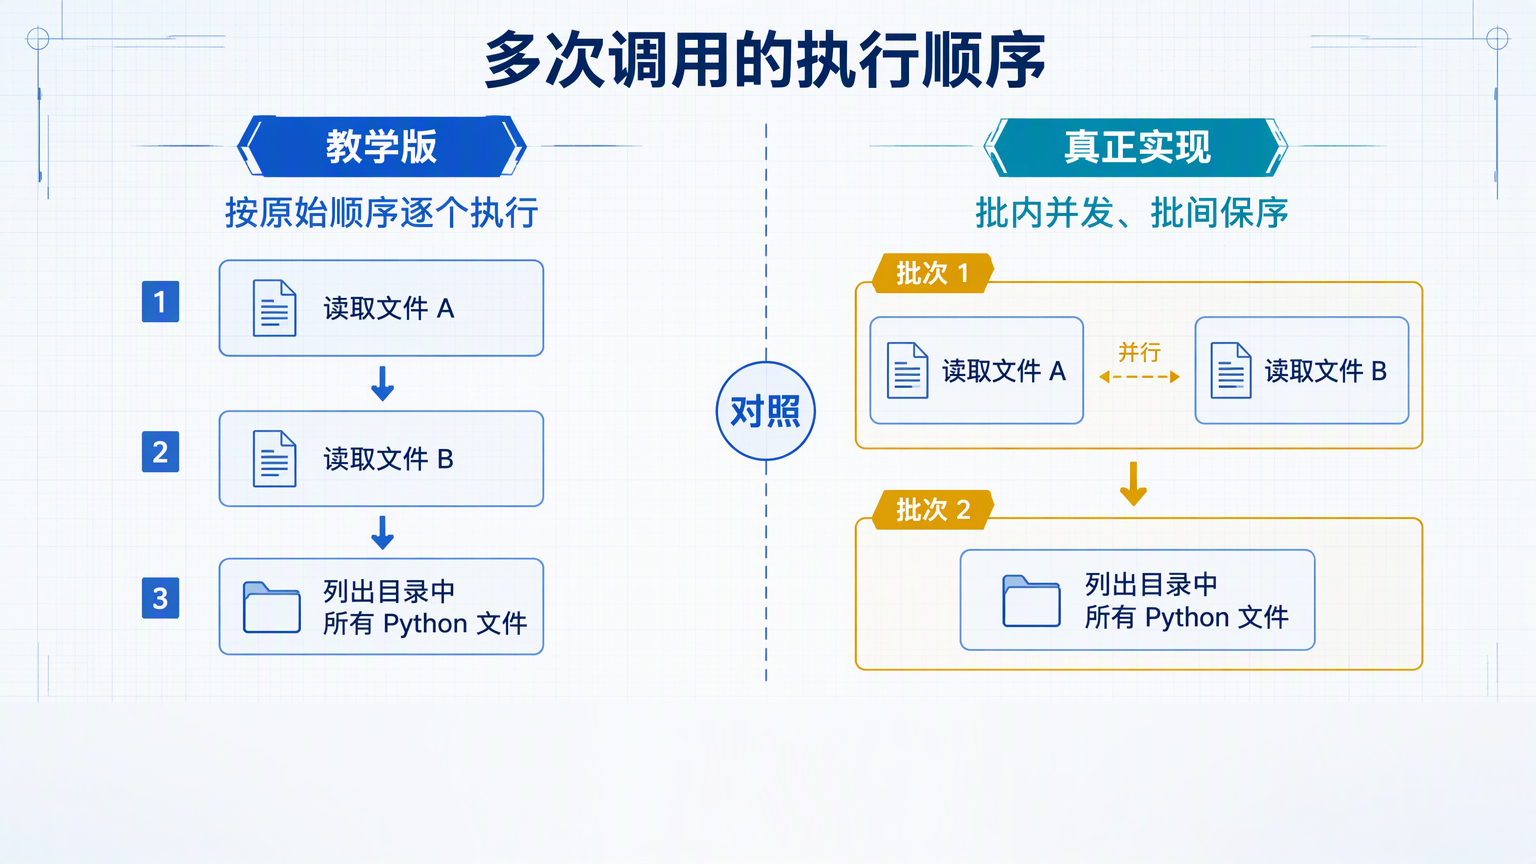
模型可能一次返回多个工具调用。例如,它可以先请求读取两个文件,再请求列出目录中所有 Python 文件。教学版按响应内容的原始顺序,一个接一个执行,因此执行顺序和结果顺序始终一一对应。
for block in response.content:
    if block.type != "tool_use":
        continue
    handler = TOOL_HANDLERS[block.name]
    output = handler(**block.input)
    results.append(make_tool_result(block.id, output))
这种顺序执行适合教学,因为它只引入工具分发这一个新概念。它的代价是延迟更高:两个互不相关的读文件操作必须等待前一个结束。
真正的实现会先把连续的工具调用切成批次。同一批中可以安全并发的调用并行运行,并受到并发上限约束;遇到不可并发的调用,就结束当前批次,单独串行执行;后续调用进入下一批。
相对上一版有哪四项变化
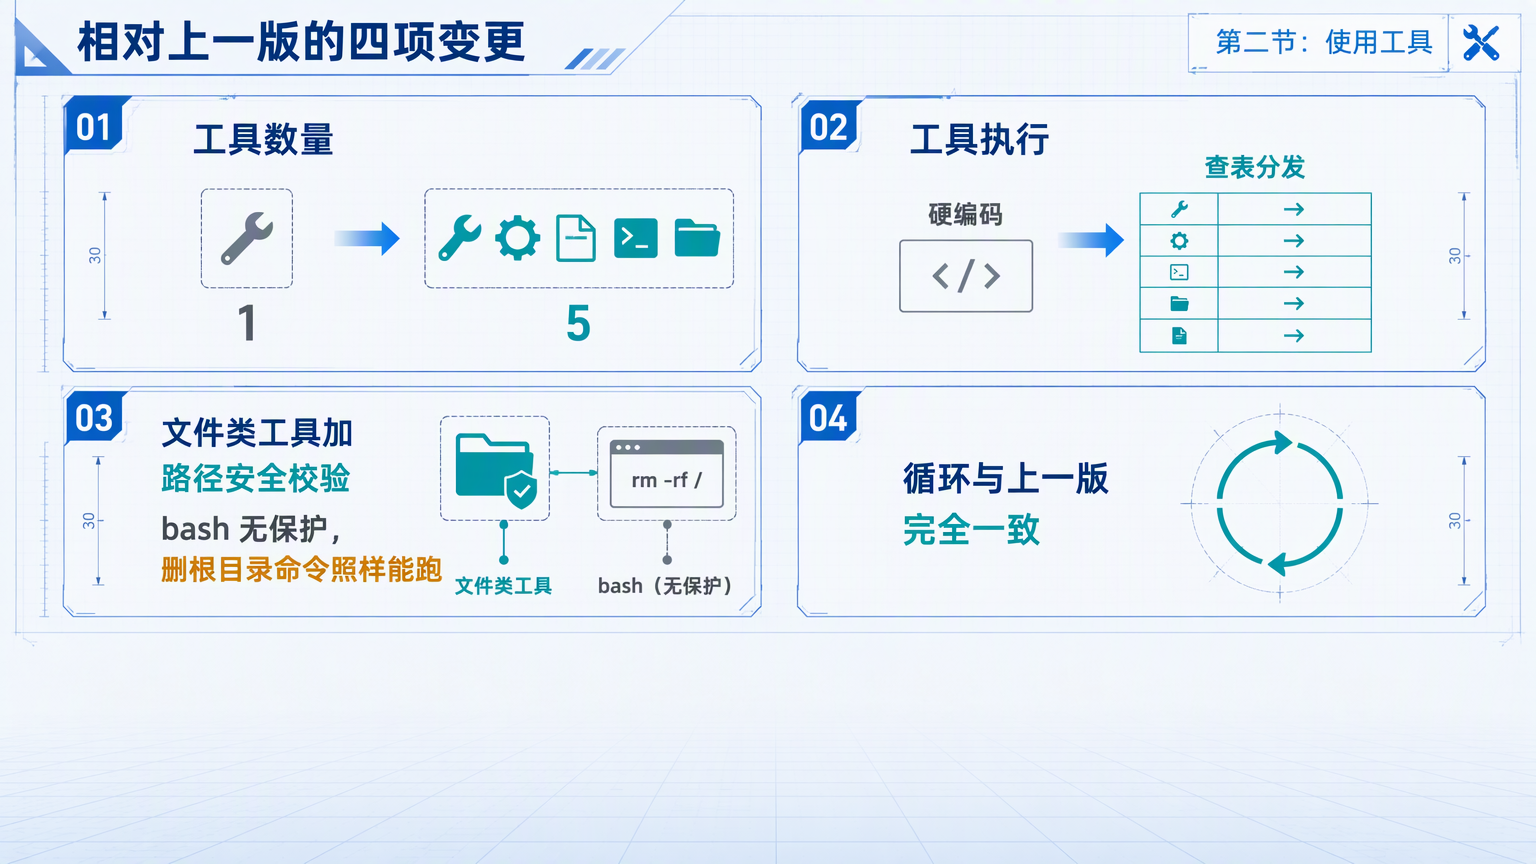
可以把本次改动压缩成四项:
- 工具数量:从一个
bash增加到五个工具。 - 执行方式:从硬编码
run_bash改成按工具名查表分发。 - 文件安全:文件类工具增加路径安全校验,限制访问范围;
bash仍没有这层保护。 - 循环结构:模型调用、停止判断和消息回灌与上一版完全一致。
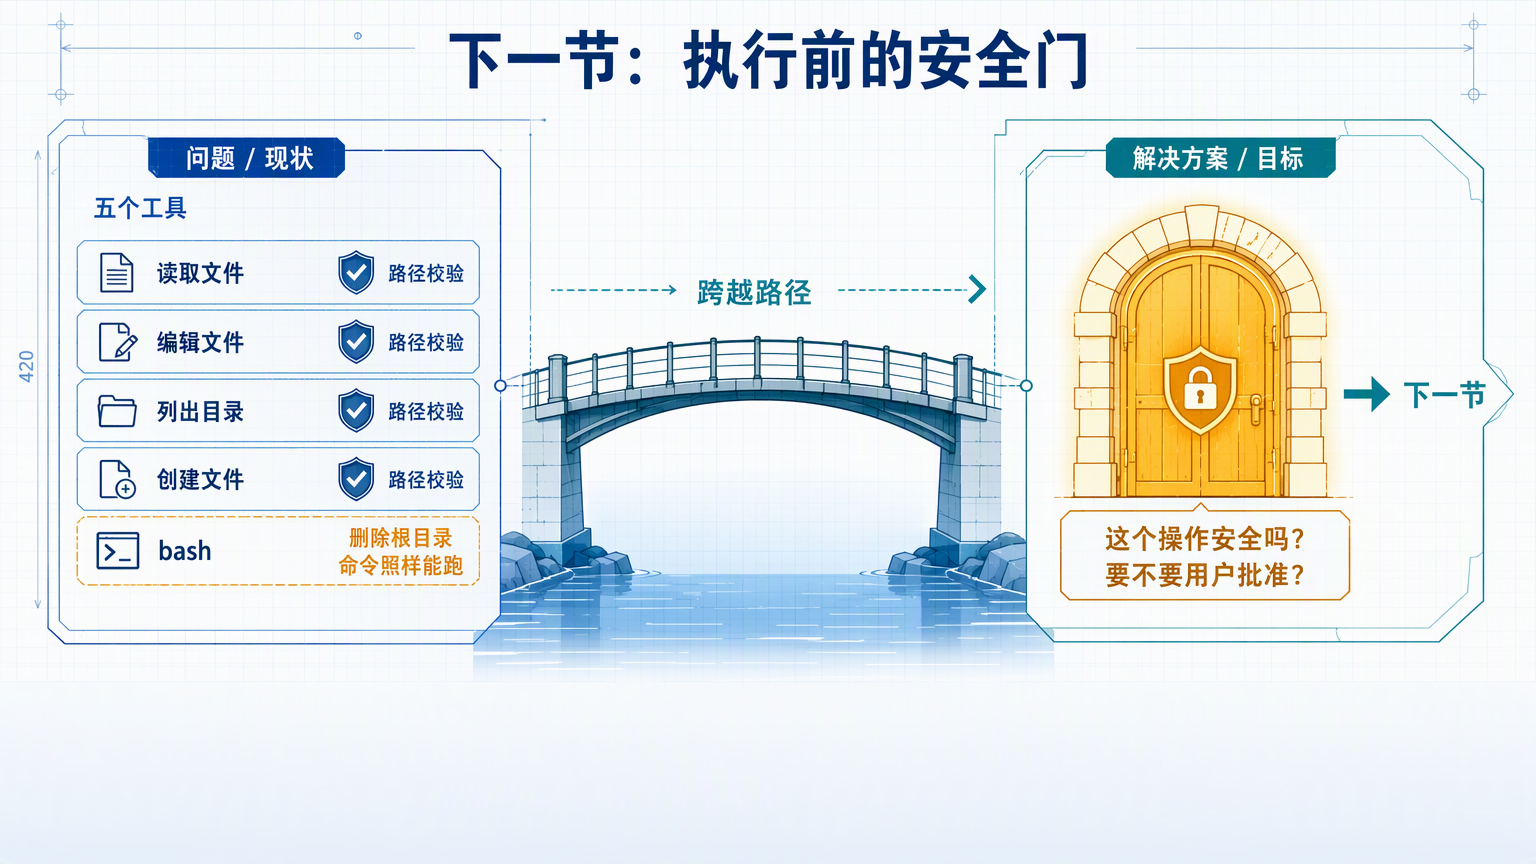
这四项里,第三项必须特别强调:文件工具的路径校验不能推导出 bash 也安全。一条 rm -rf / 仍然可能被不受限制的 shell 工具执行,下一节要解决的正是执行前的权限门。
教学版和真正的 Claude Code 如何组织工具
教学版把工具定义和实现分开:一个 TOOLS 数组负责描述能力,一个 TOOL_HANDLERS 字典负责执行。这个设计适合展示最小概念,也让“加一个工具需要改哪两处”一目了然。
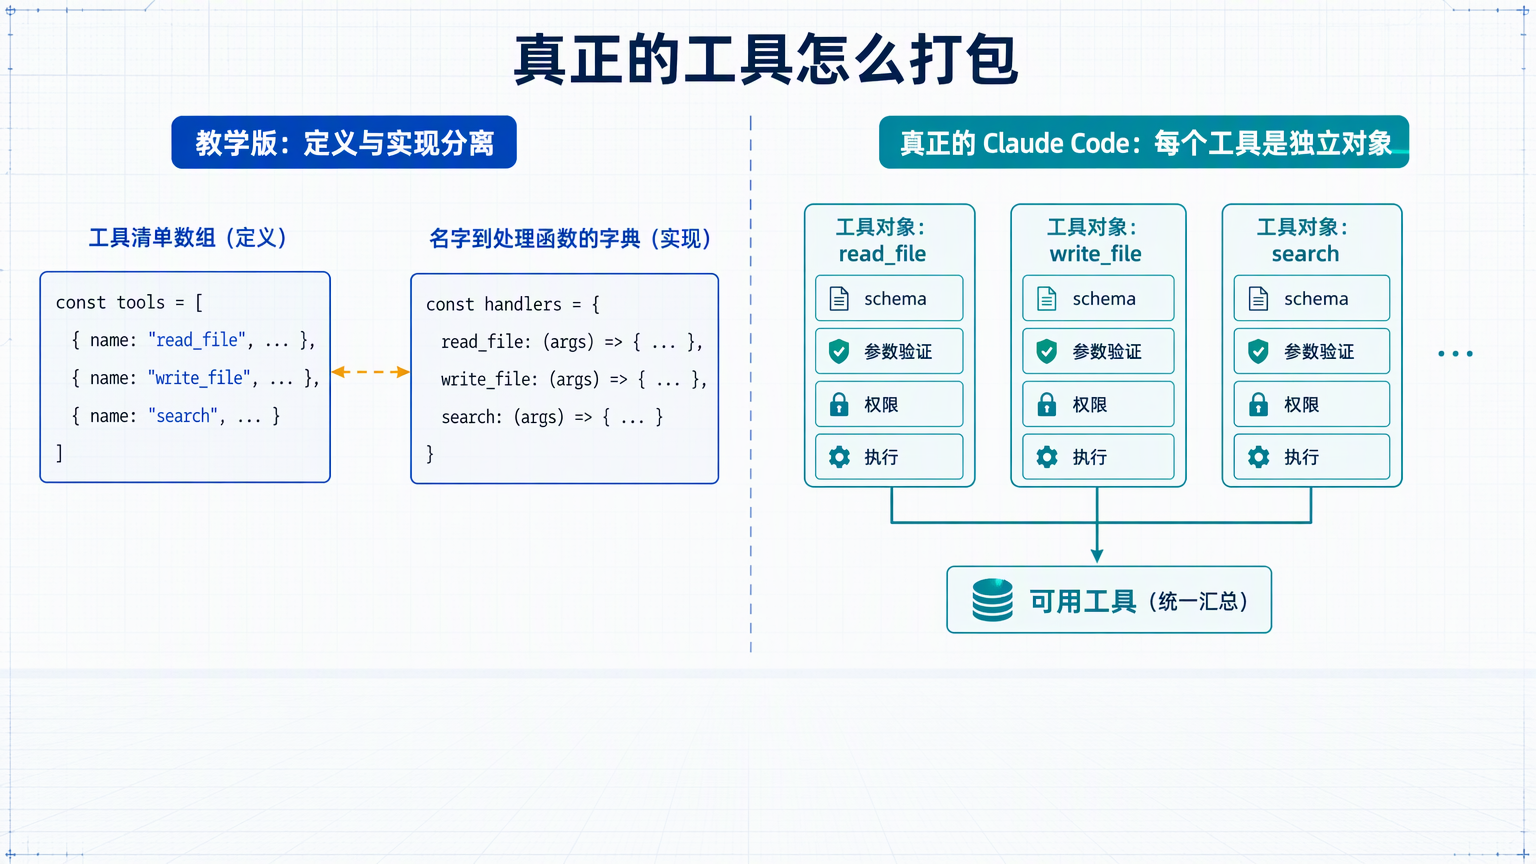
真正的 Claude Code 会把每个工具封装成一个独立对象。schema、参数验证、权限、执行和并发判断都放在对象内部,最后统一汇总出当前会话可用的工具集合。
| 组织方式 | 工具定义 | 参数验证 | 权限与执行 | 适合场景 |
|---|---|---|---|---|
| 教学版 | 集中式 TOOLS 数组 | 轻量 JSON Schema | 集中式处理函数 | 解释循环和分发 |
| 生产式 | 独立工具对象 | 工具内部校验 | 工具自带策略与执行 | 权限、并发和扩展复杂的系统 |
对象化的好处是工具边界完整:增加一个工具时,不必把 schema、权限和执行逻辑分散到多个模块,也不容易忘记某个保护环节。
真正的并发判断为什么要看具体输入
并发安全不是“只读工具可以并发、写工具不能并发”这么简单。生产实现要求每个工具根据具体输入实现并发安全判断。
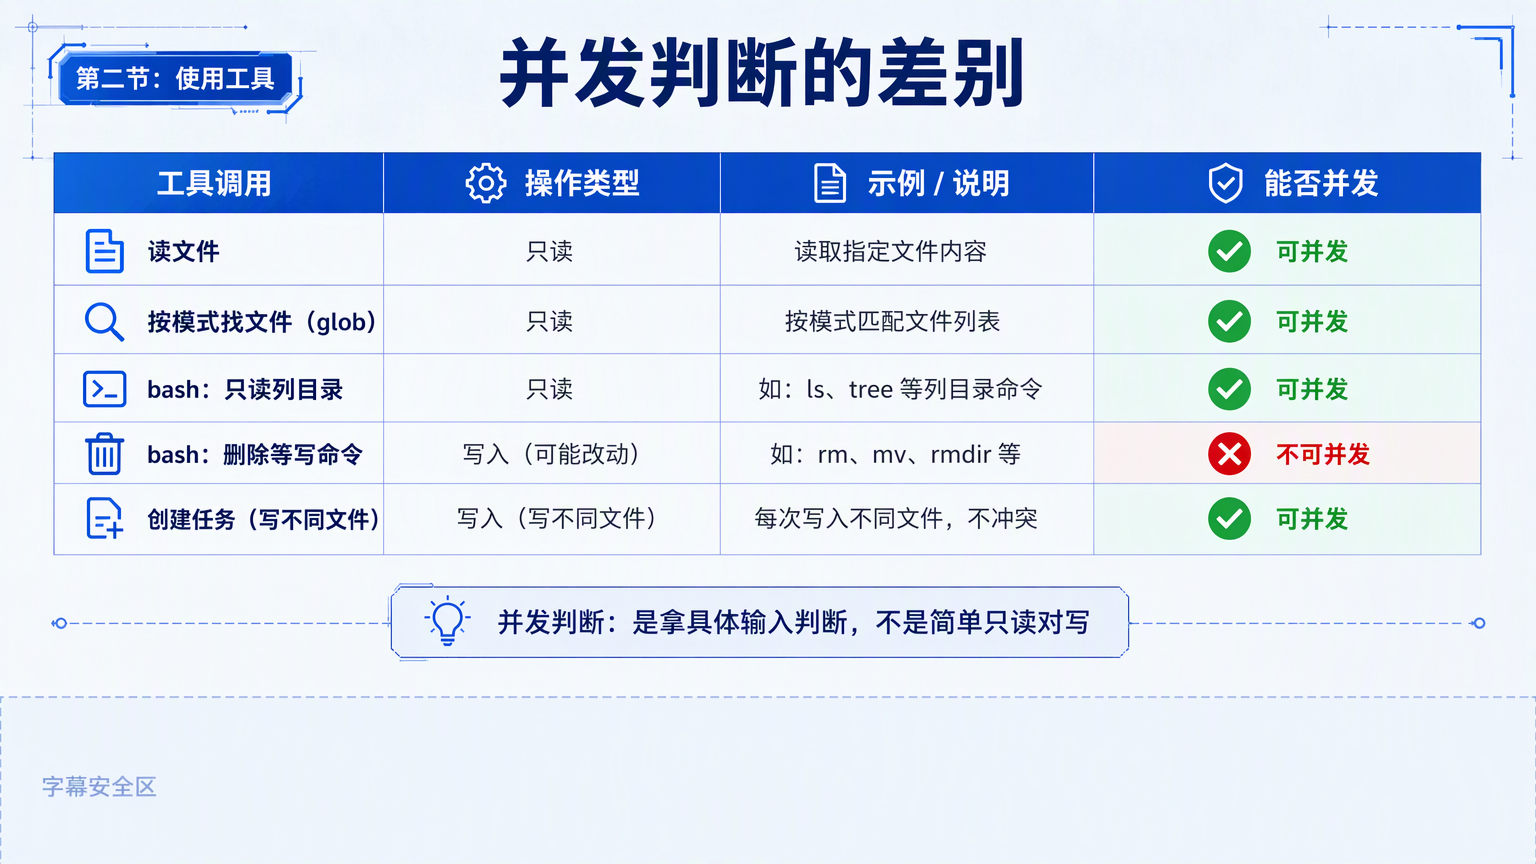
例如:
read_file和glob通常是只读操作,可以并发。bash执行ls时可以并发,执行rm或修改数据库时不能并发。- 创建任务虽然会改变状态,但每次写入不同文件,仍可能安全并发。
- 两个
edit_file如果命中同一个文件,就不能并发,否则结果取决于完成顺序。
所以并发判断的输入应包含工具名和具体参数,而不是只看工具类型。一个合理的接口类似 is_concurrency_safe(tool_input, context),它可以检查路径、命令、目标资源和是否依赖前序结果。
分批算法怎样保持顺序
分批算法的目标是同时满足两件事:让安全调用并行,保证有依赖的调用严格按顺序。
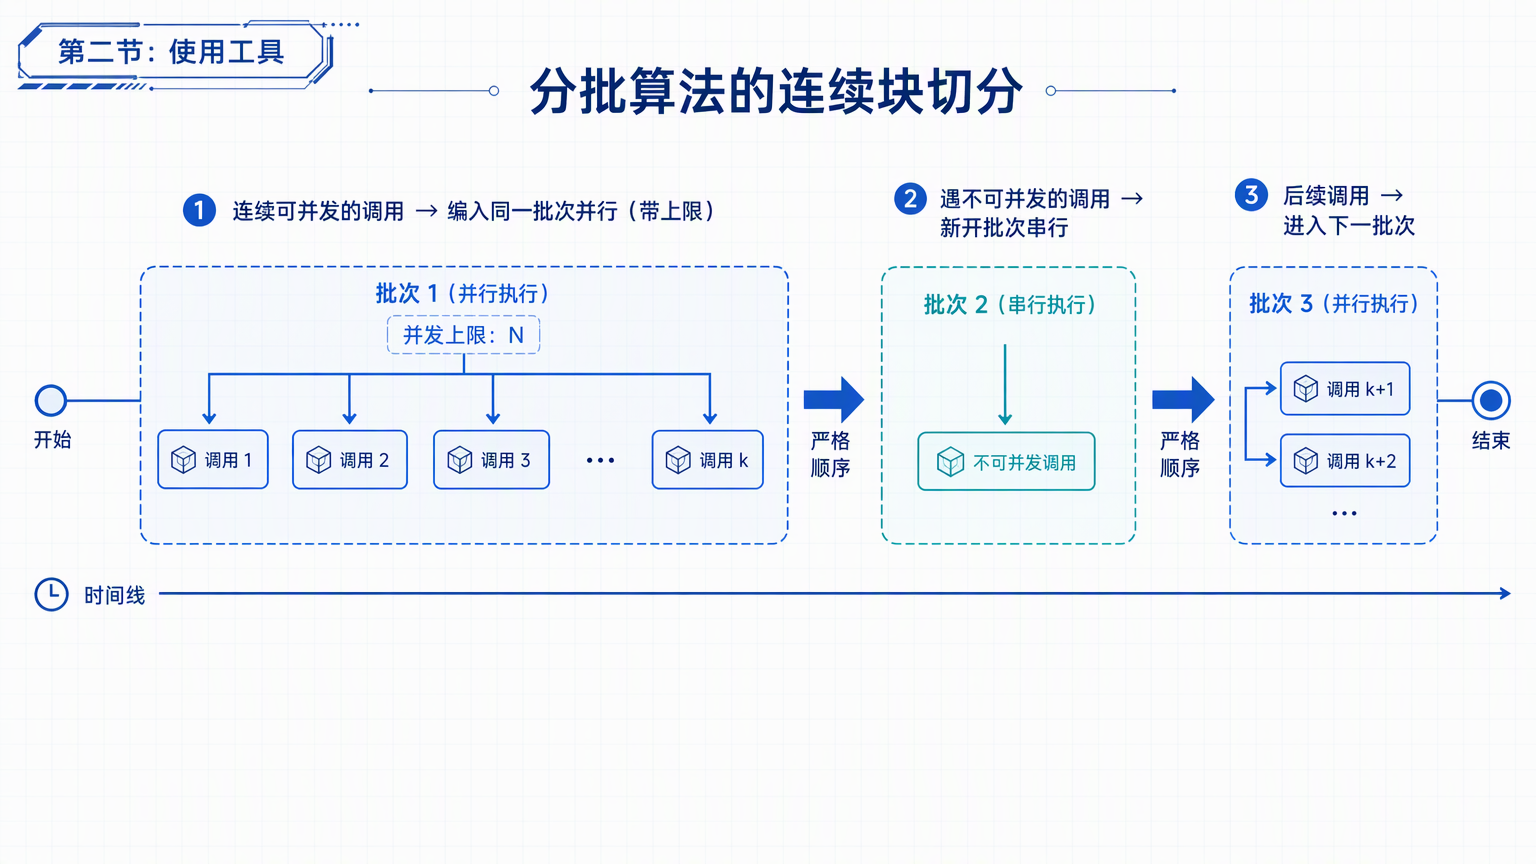
给定一串调用,算法按原始顺序扫描:
- 连续的可并发调用进入同一个批次,并行执行,受并发上限限制。
- 遇到不可并发调用时,先结束当前批次,再单独开一个串行批次。
- 当前批次完成后,才进入后续批次。
例如“读文件 A、读文件 B、删除临时目录、读文件 C”会被切成三批:前两个读取并行;删除操作独占一批;最后的读取进入第三批。这样既不会让删除与读取同时发生,也不会把所有操作都退化为串行。
工具调用执行前要经过哪五道验证
生产环境不会拿到 tool_use 就直接调用函数。每个工具调用通常要经过五道验证:
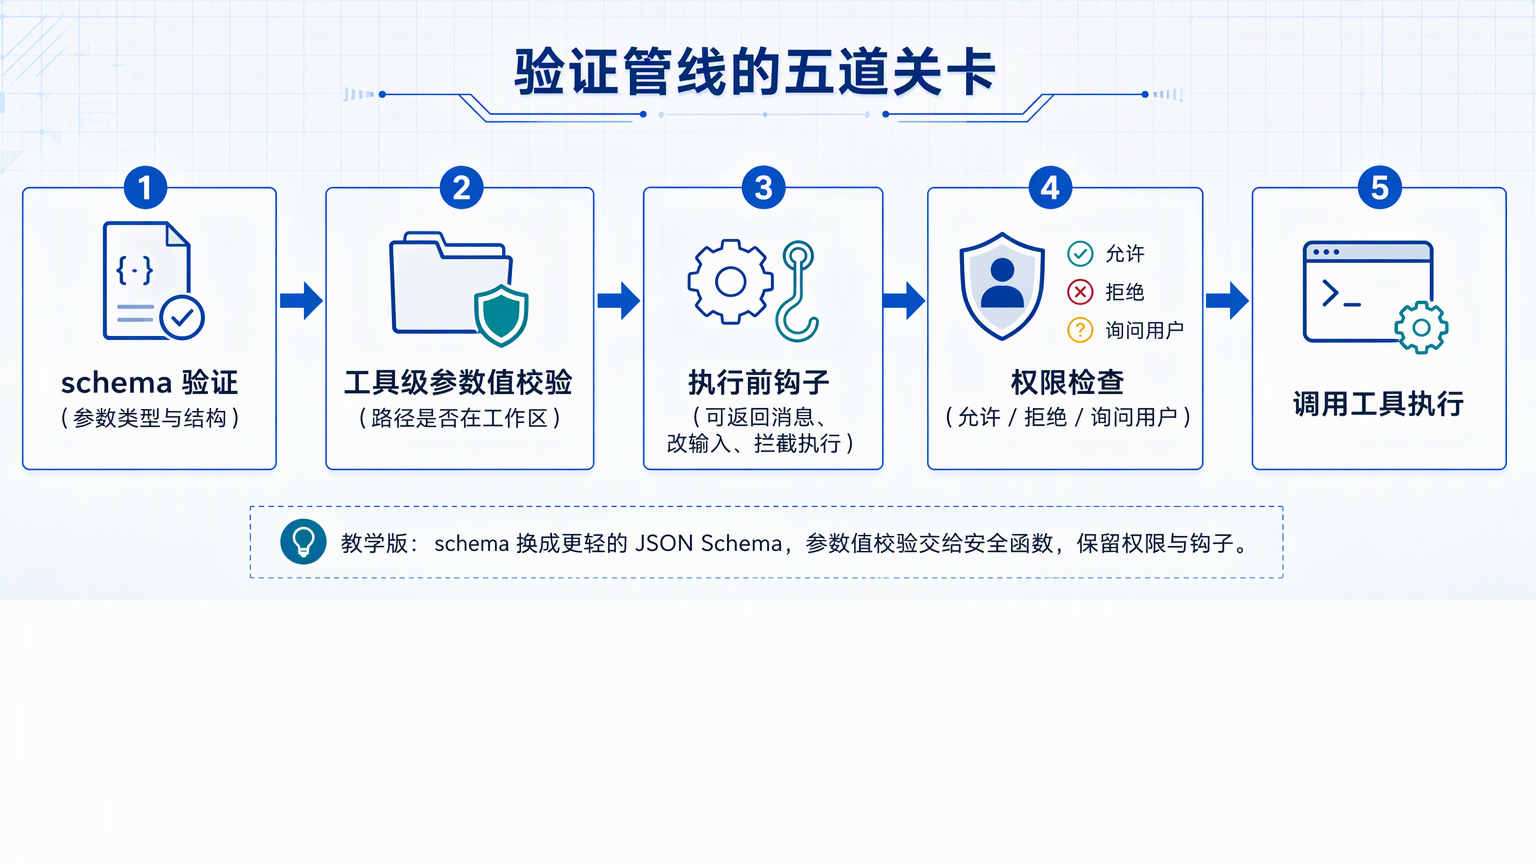
- Schema 验证:检查参数类型、必填字段和结构。
- 工具级参数值校验:检查路径是否在工作区、模式是否允许、命令是否包含危险操作。
- 执行前钩子:钩子可以返回提示、修改输入,或直接拦截本次执行。
- 权限检查:得到允许、拒绝或询问用户三种结果。
- 执行工具:只有前面都通过,才真正调用处理函数。
教学版用较轻的 JSON Schema 代替完整类型系统,用安全函数完成参数值校验,同时保留权限检查和钩子的概念。验证失败也应该包装成结构化工具结果,让模型知道失败原因,而不是把异常堆栈直接泄漏到上下文中。
流式执行为什么能降低等待时间
教学版等模型完整返回后才开始执行工具。真正的 Claude Code 支持流式执行:当响应流中已经解析出一个完整的工具调用时,可以在模型还没生成完后续文本时启动它。
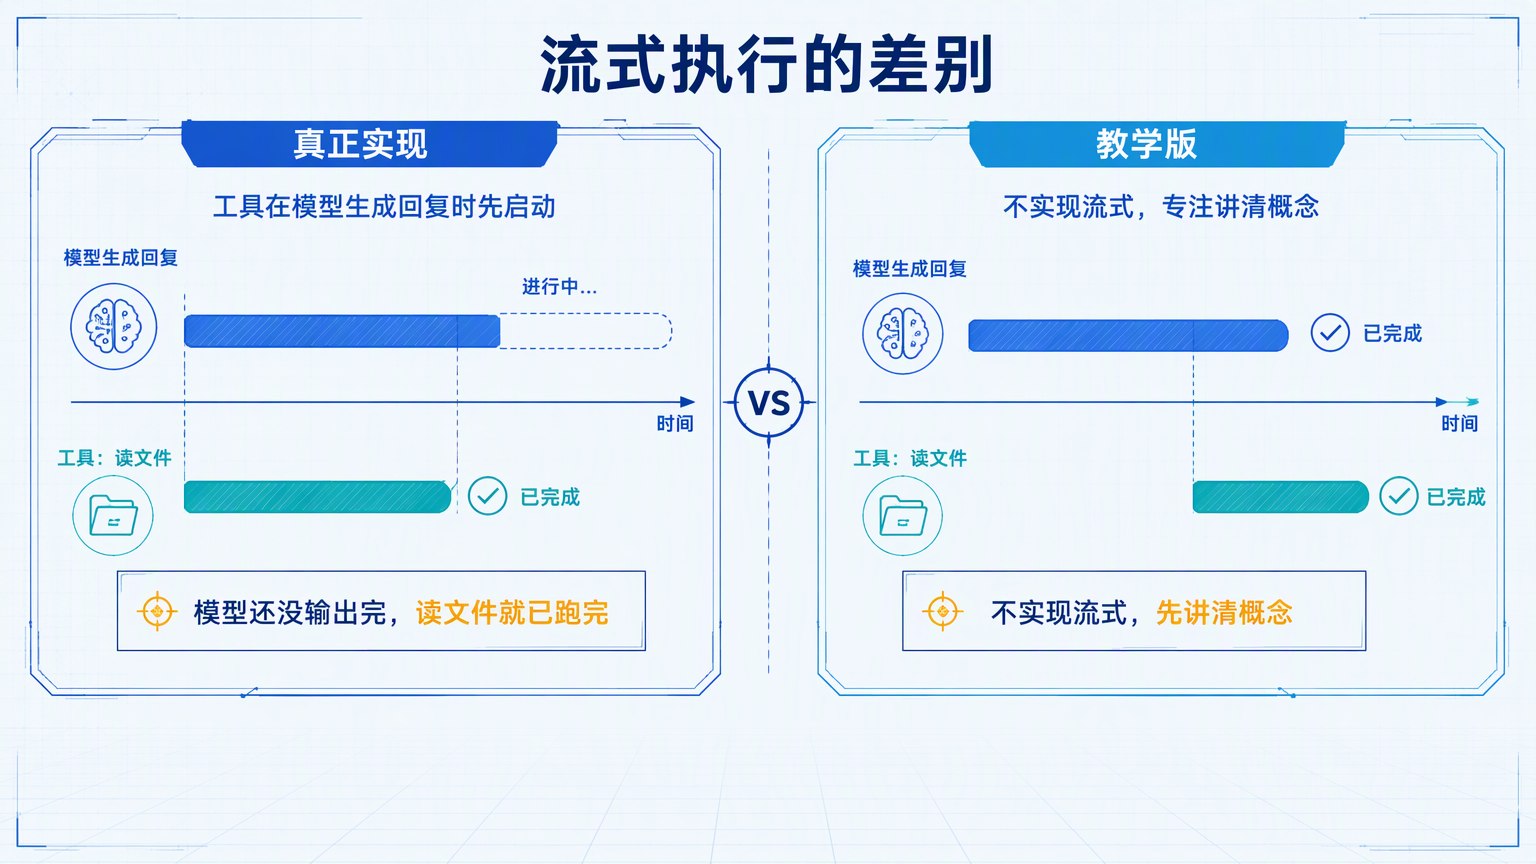
例如读文件操作已经拿到路径和调用 ID,就可以先打开文件。等模型剩余内容生成完时,文件读取可能已经结束,整体等待时间因此缩短。
流式执行也增加了状态管理难度:需要处理半截参数、取消信号、工具结果与后续内容的关联,以及工具失败时如何终止或继续。教学版不实现这部分,目标是先讲清楚工具分发和安全边界。
工具结果太长时如何避免上下文失控
每个工具通常都有结果长度上限。结果超过上限时,运行框架可以把完整内容写入磁盘,只把预览和文件路径返回给模型。
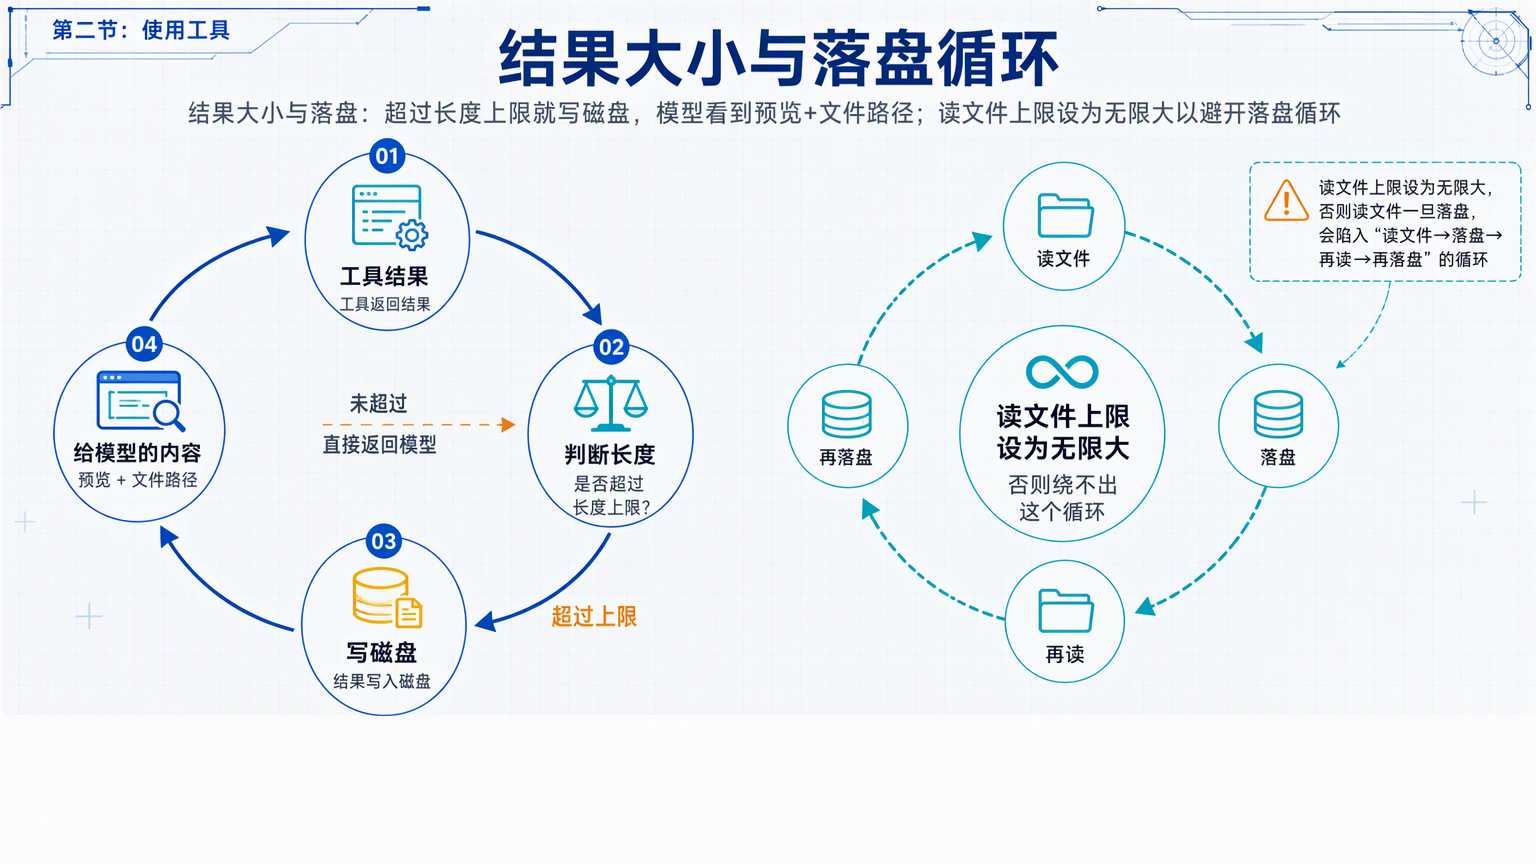
读文件工具是一个特殊例外:它的结果上限设为无限大。否则会出现这样的循环:
read_file结果过长,被写入磁盘。- 模型根据路径再次调用
read_file读取落盘文件。 - 新结果再次过长,又被写入另一个文件。
- 模型继续读取,最终陷入“读文件 → 落盘 → 再读 → 再落盘”。
这不代表读文件没有风险。生产实现仍需限制单文件大小、总 token 预算和会话读取范围,只是不能用同一种结果落盘策略处理它。
这版教学代码有哪些限制
这版实现刻意保留了清晰的最小结构,但不能直接当作生产执行器。使用时至少要记住以下限制:
bash没有路径和命令安全保护,不能在真实环境中无审批准许执行。- 教学版按顺序执行,不提供并发带来的延迟收益。
- 工具 schema 的示例字段被简化,生产环境必须补全类型和约束。
- 未知工具名、超时、取消、进程退出码和输出截断都需要单独处理。
- 文件路径校验要处理符号链接、
..、大小写和跨平台路径差异。
因此,这一版适合用来理解“工具定义 + 名称分发 + 结果回灌”的协议,不适合直接暴露到有重要数据的工作区。
常见问题
直接调用工具和 Function Calling 是一回事吗?
它们使用的是同一类结构化调用机制:模型返回工具名和参数,外部程序负责执行。本文强调的是 Agent 内部如何按名称分发和执行,Function Calling 更常用来描述模型接口层的协议。
为什么不把所有能力都保留成 bash?
bash 灵活,但权限边界和参数含义都隐藏在命令字符串里。独立工具能让读、写、改、查分别校验、授权和审计,也能减少 shell 转义错误。
增加一个工具需要改循环吗?
在教学版里不需要。新增工具只要加入 TOOLS 定义、实现处理函数,并在 TOOL_HANDLERS 中完成名称映射,执行循环保持不变。
多个工具调用一定会并发吗?
不一定。教学版按原始顺序串行执行;生产版先根据具体输入判断并发安全,再把连续安全调用组成批次并行执行,不安全调用会切成独立批次。
路径校验能保证 bash 安全吗?
不能。路径校验只保护经过它的文件类工具,无法约束任意 shell 命令。bash 需要单独的命令策略、沙箱、权限检查和用户确认。
为什么读文件结果可以不设长度上限?
教学版这样做是为了避免结果落盘后再次被读文件工具读取,形成循环。生产实现仍应通过 token 预算、单文件限制或分页读取控制上下文大小。
小结
让模型直接调用工具,就是把“读文件、写文件、改文件和查找文件”从一条条 shell 命令中拆出来,变成带名称、描述和参数 schema 的独立能力。最小实现只需把硬编码的 run_bash 换成 TOOL_HANDLERS 查表分发,循环本身可以保持不变。
从教学版走向真正的 Claude Code,还要补上对象化工具、按输入判断并发、连续批次调度、五道执行前验证、流式执行和结果大小控制。下一节会继续处理当前最明显的缺口:bash 没有安全边界,工具执行前必须先问“这个操作是否需要用户批准”。