什么是 Kafka 十大应用场景
Kafka 十大应用场景,说到底都在回答同一个问题:数据怎么从产生的地方,稳定又及时地送到需要它的地方。Kafka 是一个分布式消息流平台,它把数据当成一条只追加的日志存下来,写进去之后能被多个不同的系统各自读走。
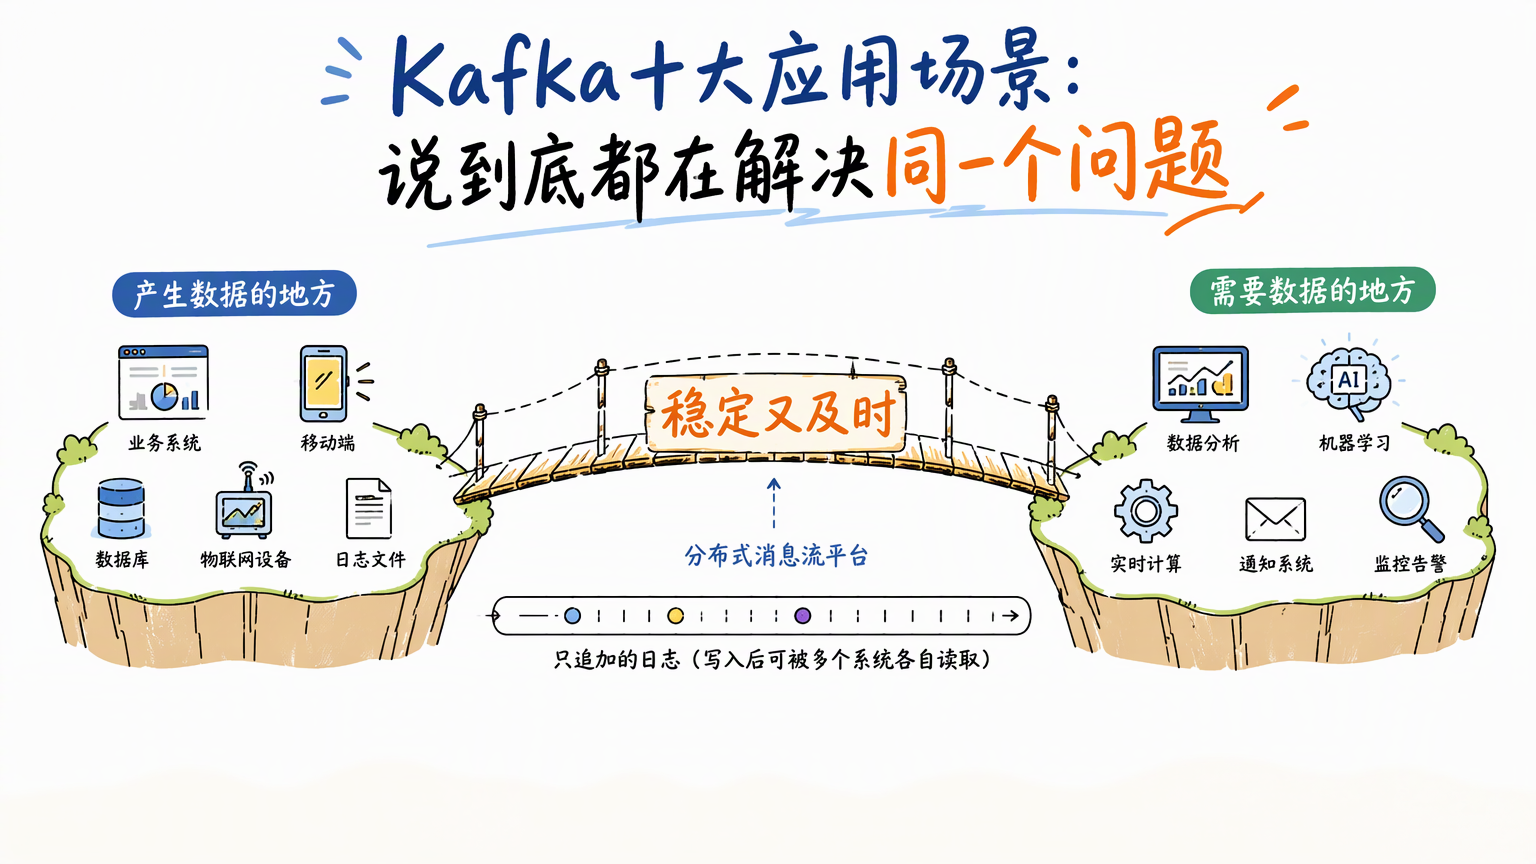
这篇内容先讲 Kafka 凭什么撑得住这么多用法,再逐个拆开十个场景,最后回到它们共同的判断标准。
核心机制:Kafka 为什么撑得住这么多用法
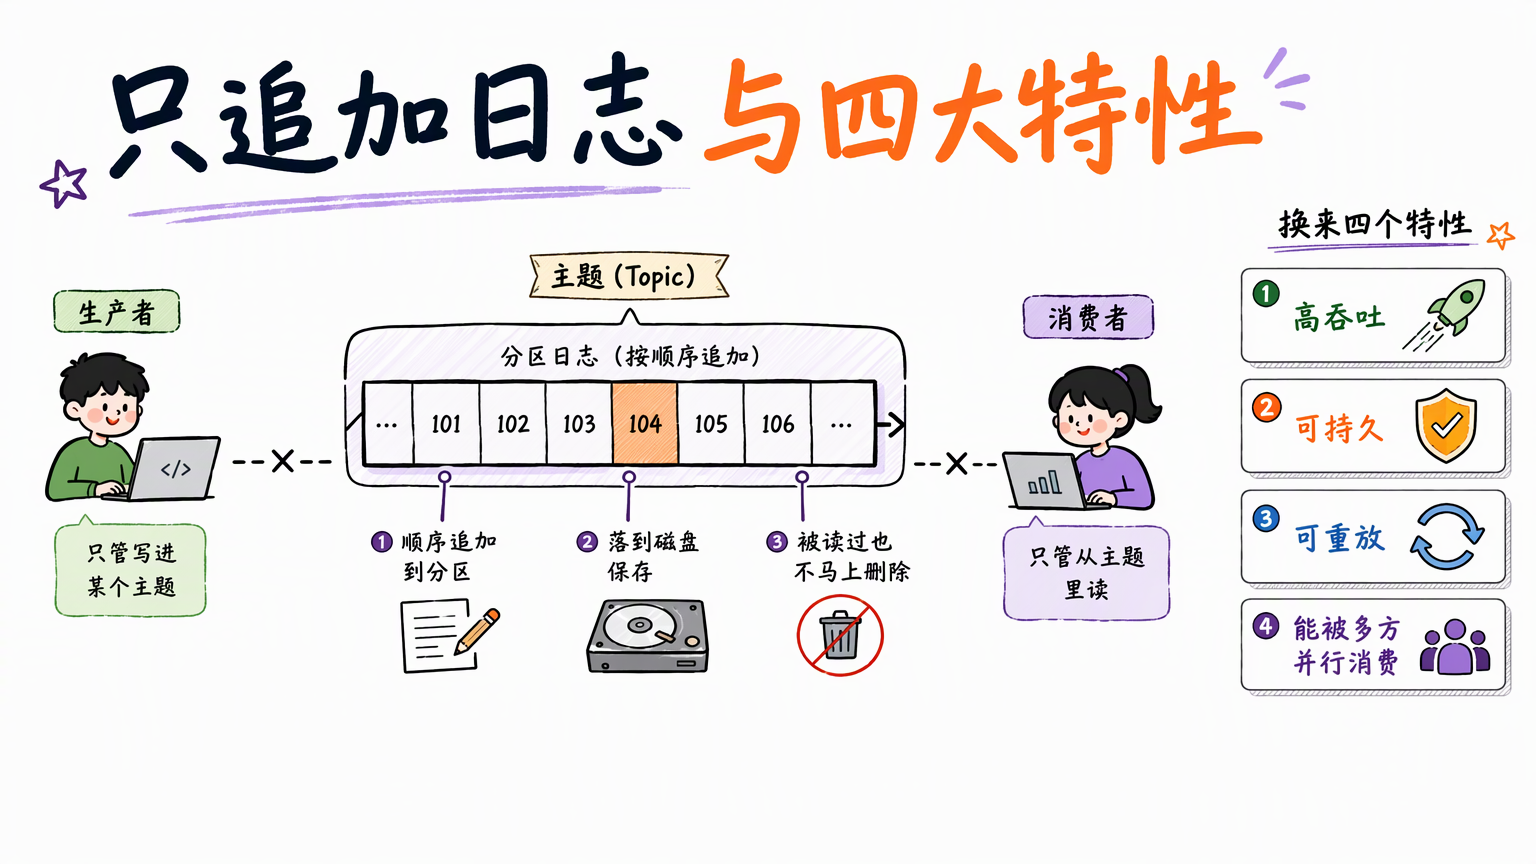
Kafka 把消息按顺序追加到分区里,落到磁盘保存,被读过也不会马上删除。生产者只管写进某个主题,消费者只管从主题里读,双方互不认识。
这几件事叠在一起,换来四个特性:
- 高吞吐
- 可持久
- 可重放
- 能被多方并行消费
和传统消息队列的关键差别
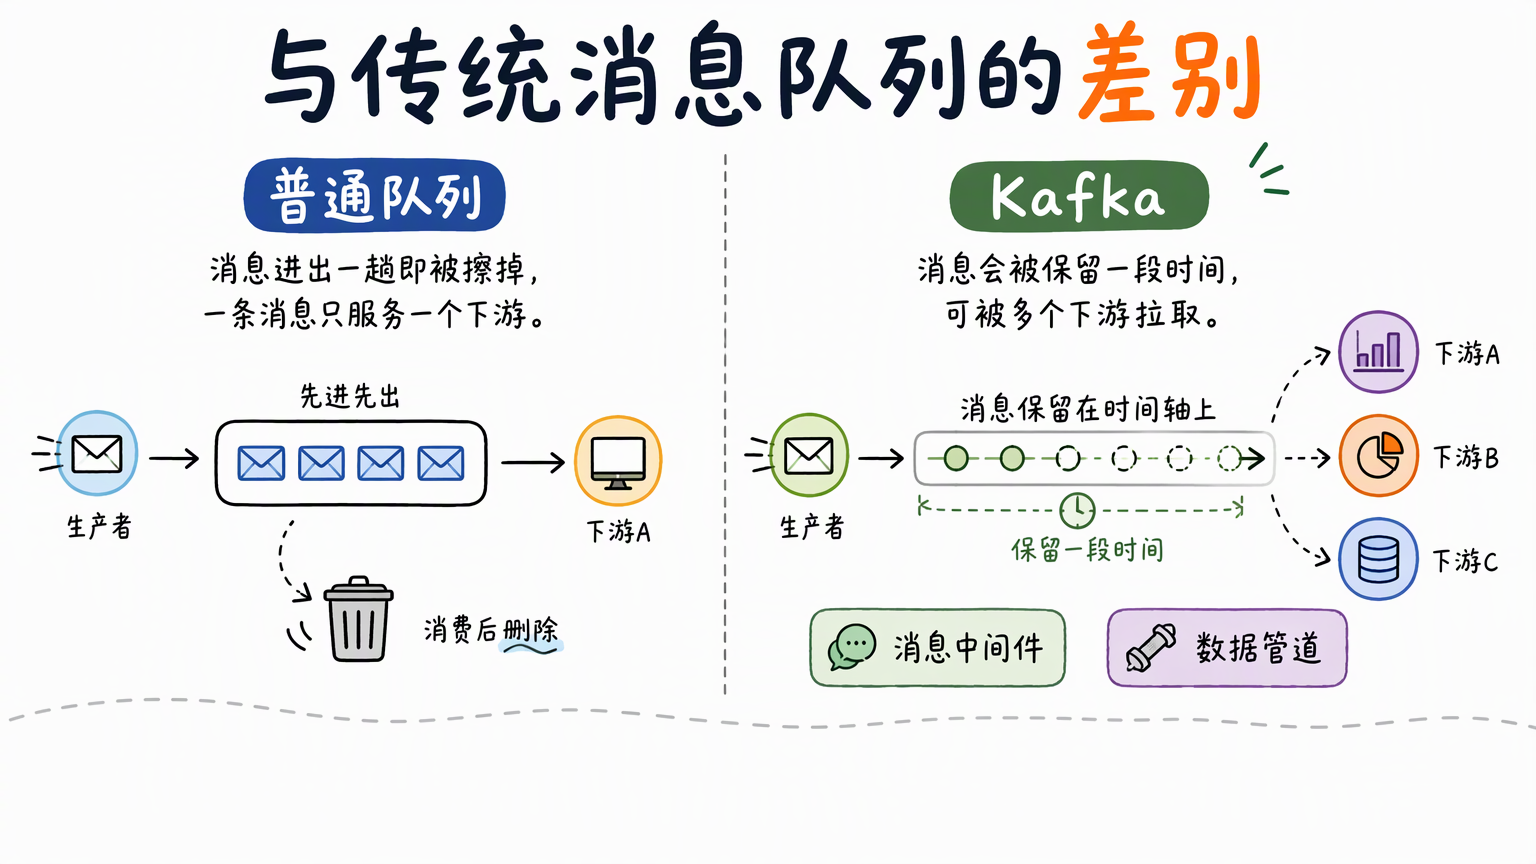
普通队列经常是消费完就删,一条消息只服务一个下游。Kafka 会把消息保留一段时间,所以它既能当消息中间件,也能当数据管道,场景清单自然就长了很多。
十个实践场景
1. 日志收集与聚合
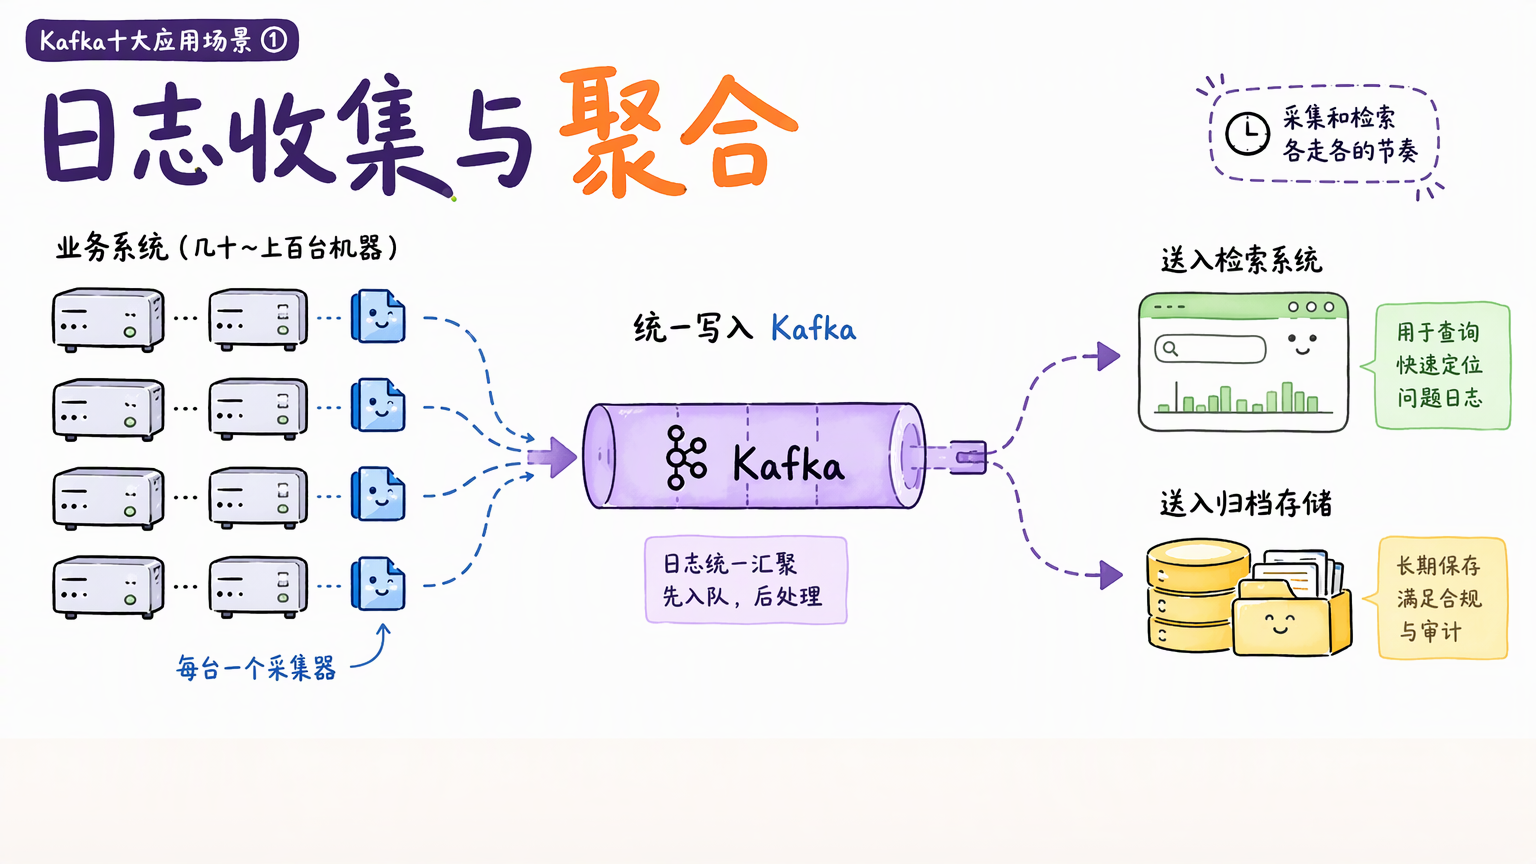
一个业务系统可能跑在几十上百台机器上,日志散落在各处,排查问题时要一台台登上去看。常见做法是每台机器装一个采集器,把日志统一写进 Kafka,再由下游分别送进检索系统和归档存储,采集和检索各走各的节奏。
2. 用户行为埋点
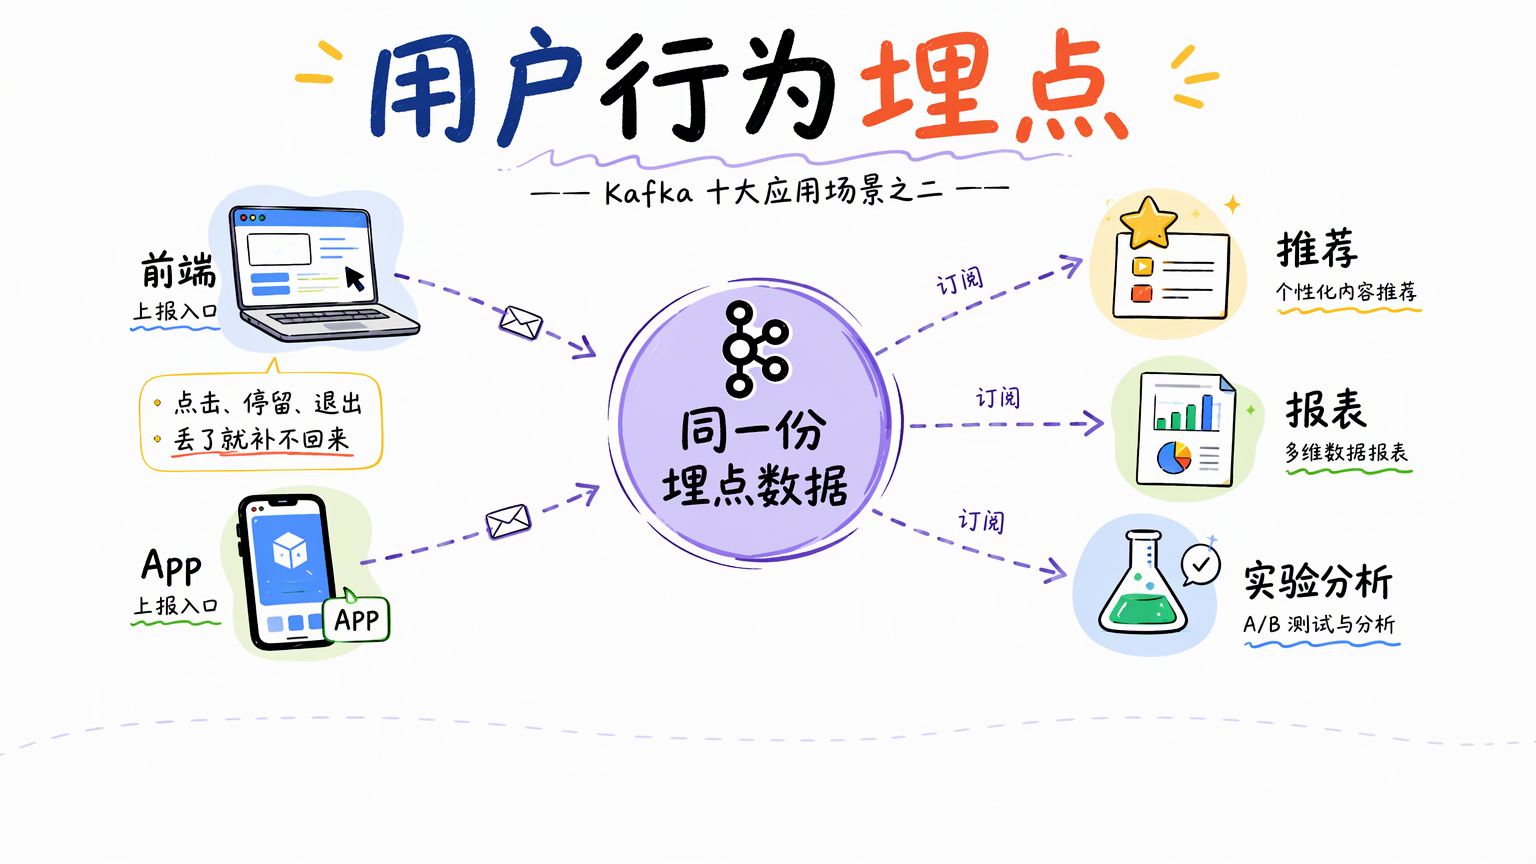
用户点了什么、停留多久、在哪个页面退出,这类事件量极大,而且丢了就补不回来。前端和 App 把埋点写进 Kafka,推荐、报表、实验分析各自订阅同一份数据,不需要为了每个下游重复上报。
3. 系统监控与指标采集
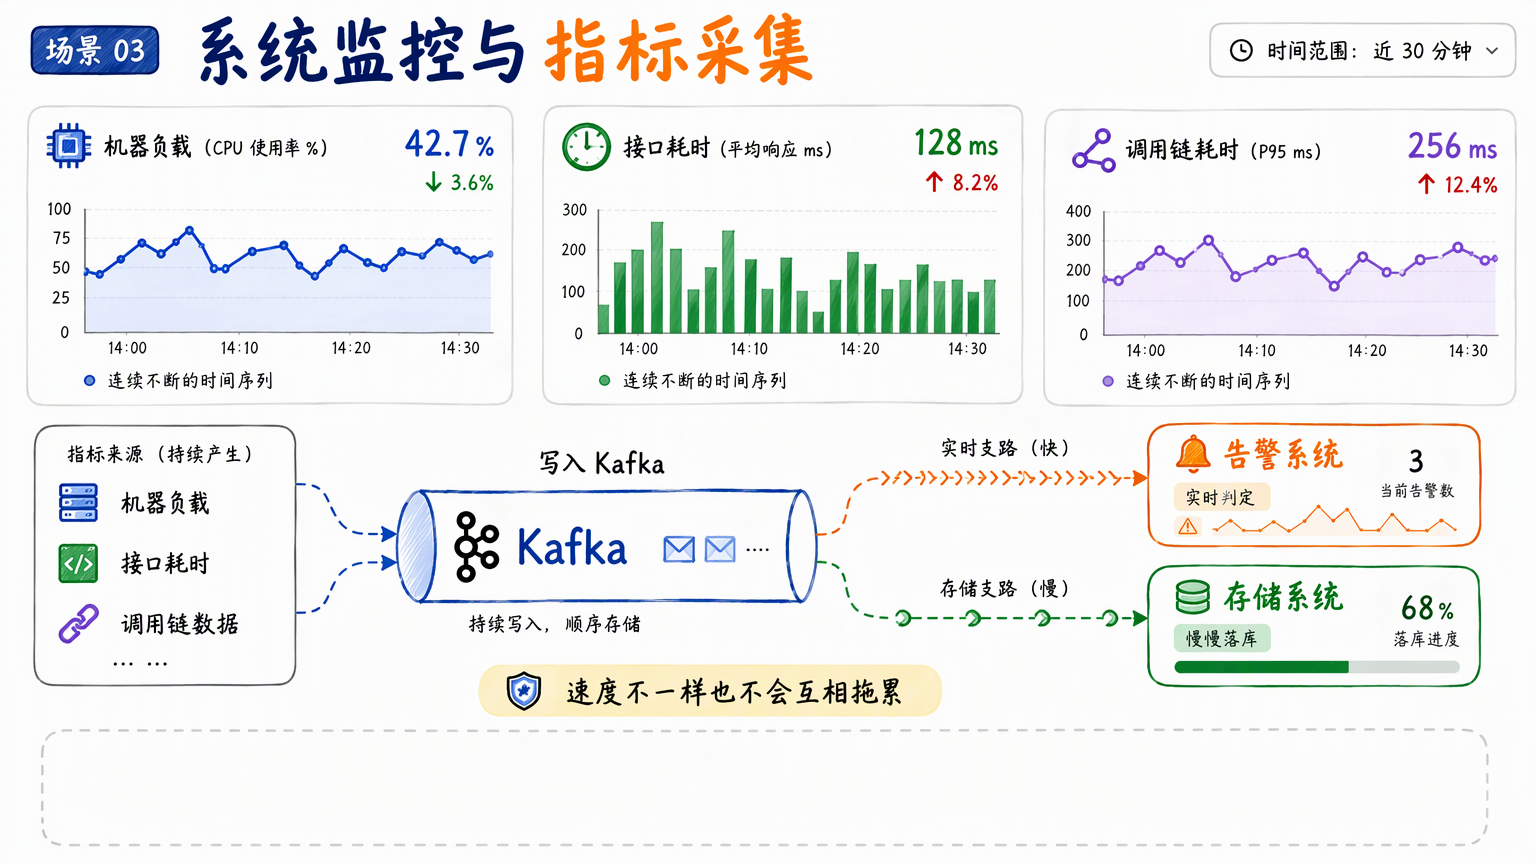
机器负载、接口耗时、调用链数据本身就是连续不断的时间序列。写进 Kafka 之后,告警系统实时判定,存储系统慢慢落库,两边速度不一样也不会互相拖累。
4. 微服务解耦
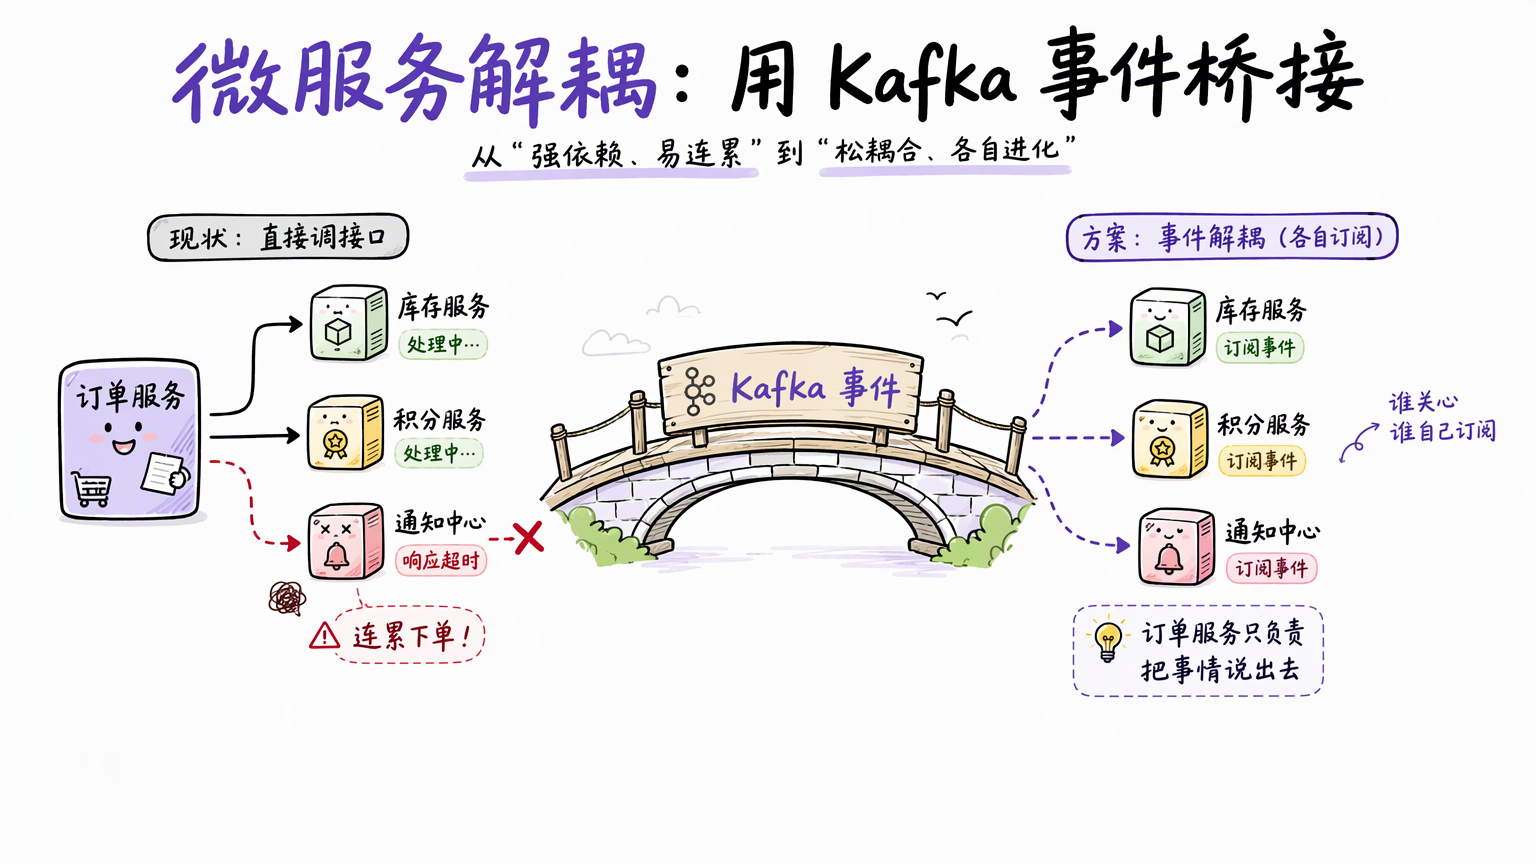
订单服务下完单,要通知库存、积分、通知中心。如果直接调接口,任何一个下游变慢或者挂掉都会连累下单。改成往 Kafka 发一条事件,谁关心谁自己订阅,订单服务只负责把事情说出去。
5. 流量削峰
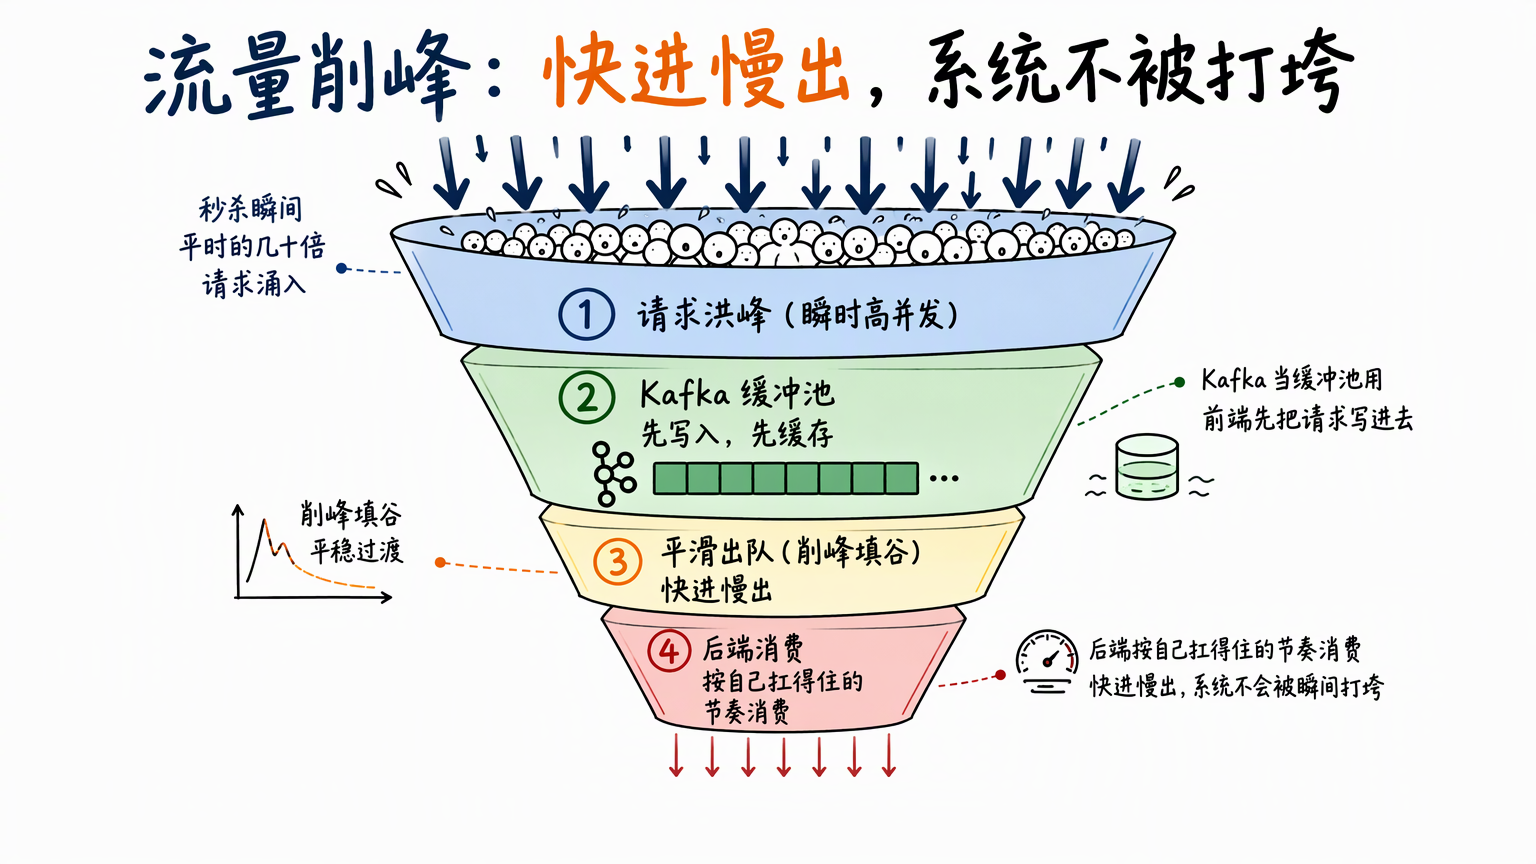
秒杀开始那一瞬间,请求量可能是平时的几十倍。Kafka 在这里当缓冲池用,前端先把请求写进去,后端按自己扛得住的节奏消费,快进慢出,系统不会被瞬间打垮。
6. 异步处理
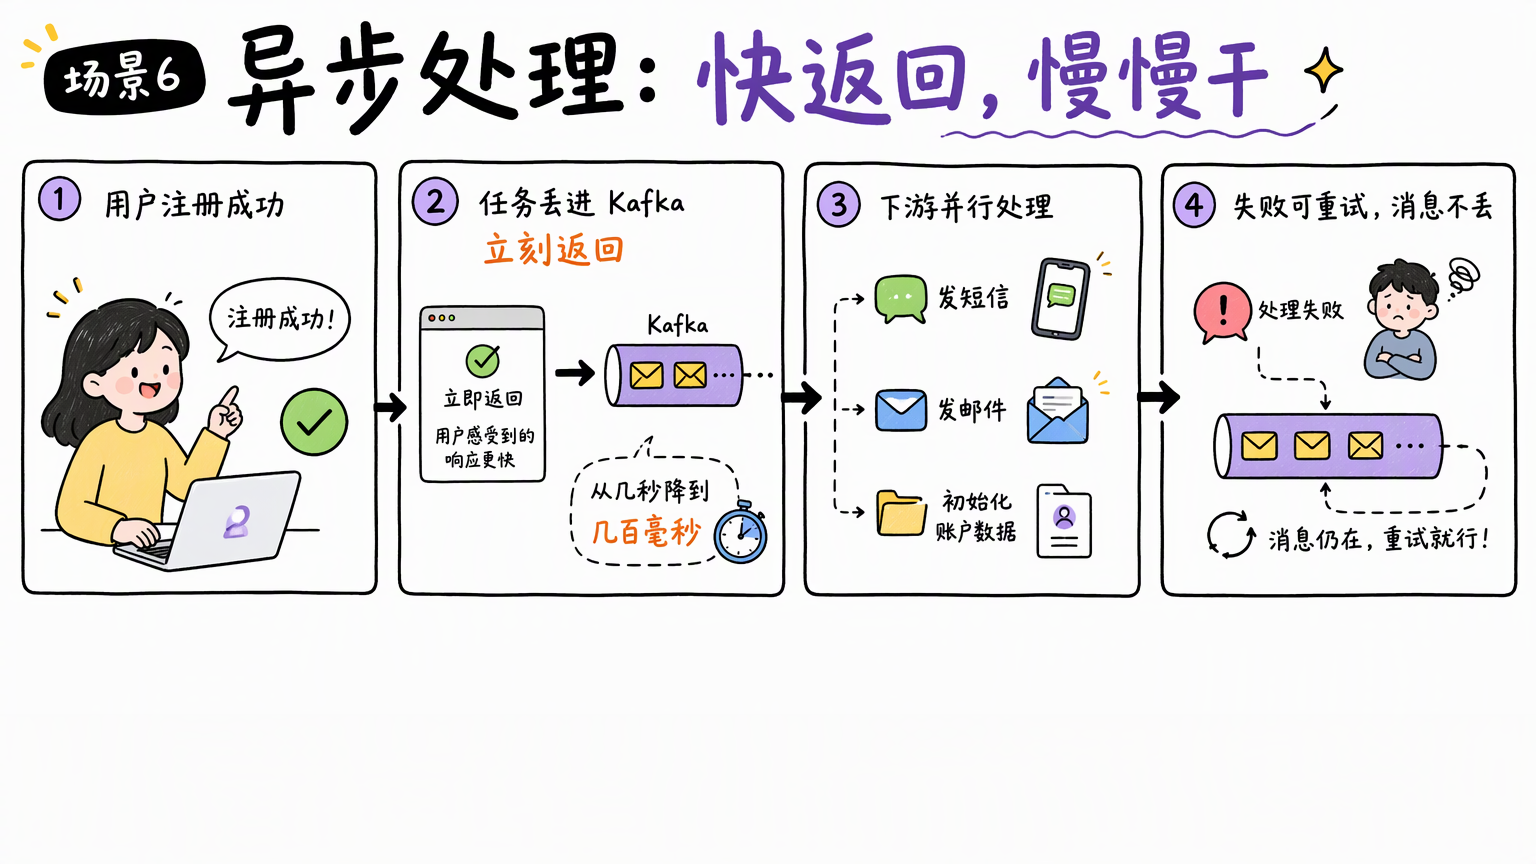
用户注册成功后要发短信、发邮件、初始化账户数据,这些事没必要卡在注册接口里等。任务丢进 Kafka 立刻返回,用户感受到的响应时间从几秒降到几百毫秒;处理失败也没关系,消息还在,重试就行。
7. 数据管道同步(CDC)
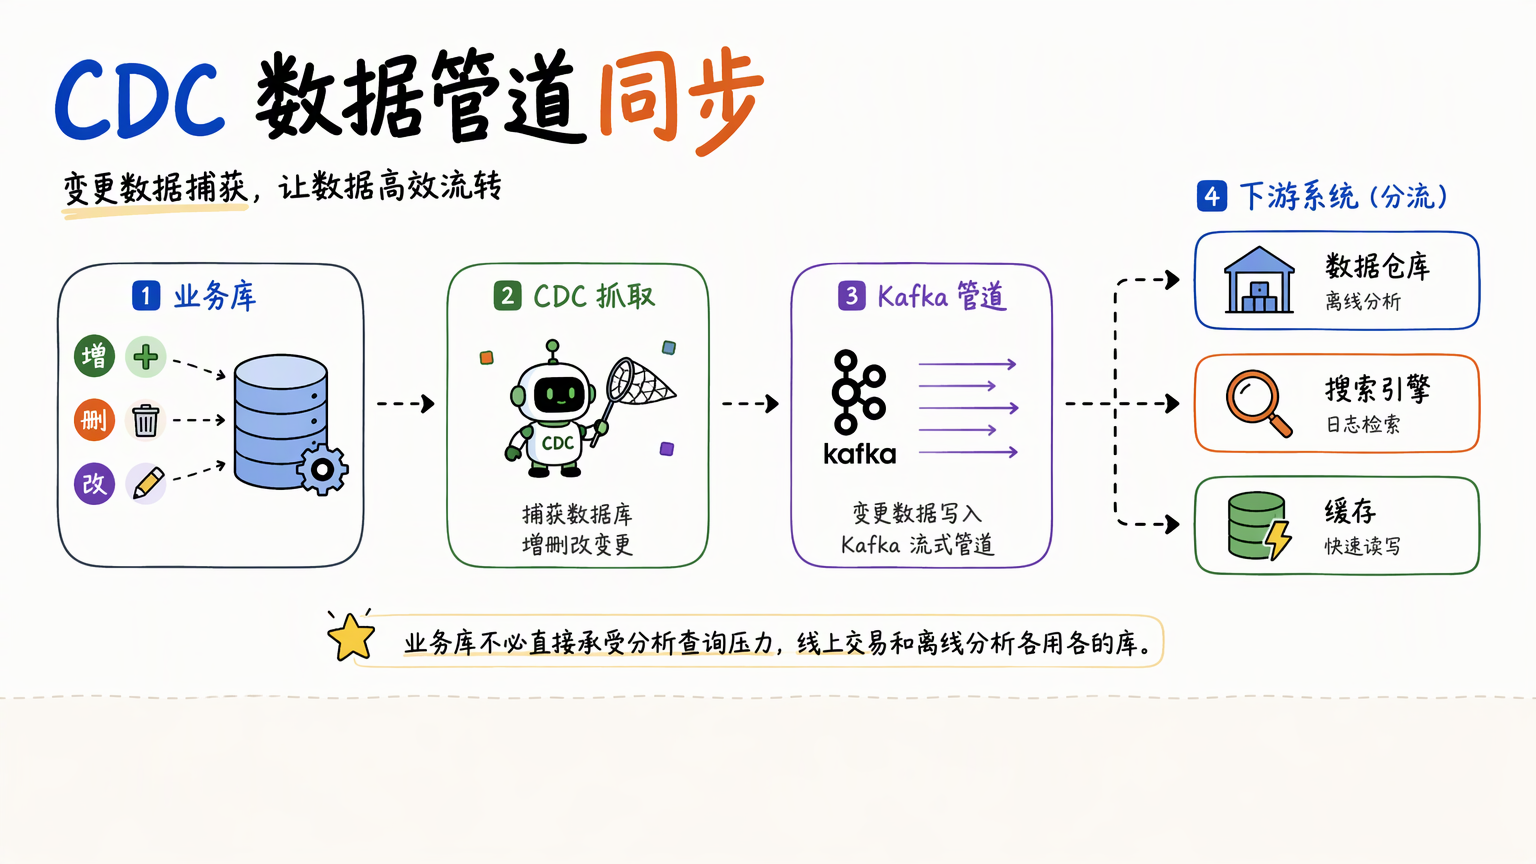
CDC 即变更数据捕获:数据库里每一次增删改都被抓出来写进 Kafka,再同步到数据仓库、搜索引擎或者缓存。业务库因此不必直接承受分析查询的压力,线上交易和离线分析各用各的库。
8. 实时流式计算
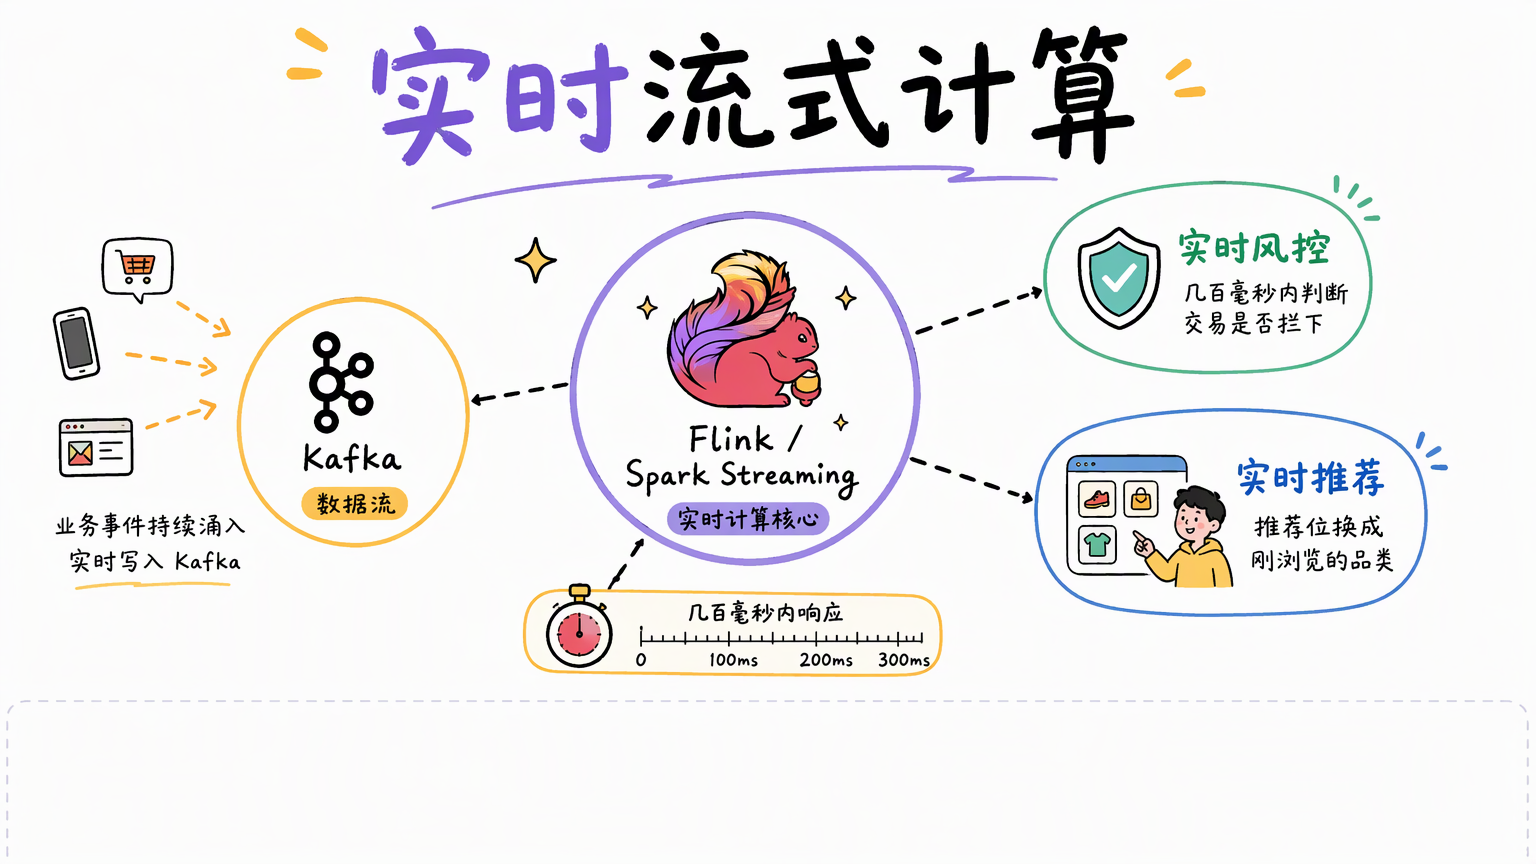
用 Flink 或者 Spark Streaming 读 Kafka 的数据做实时风控和实时推荐。用户刚下单,几百毫秒内就能判断这笔交易要不要拦下来;推荐位也能马上换成他刚刚浏览的品类。
9. 事件驱动架构
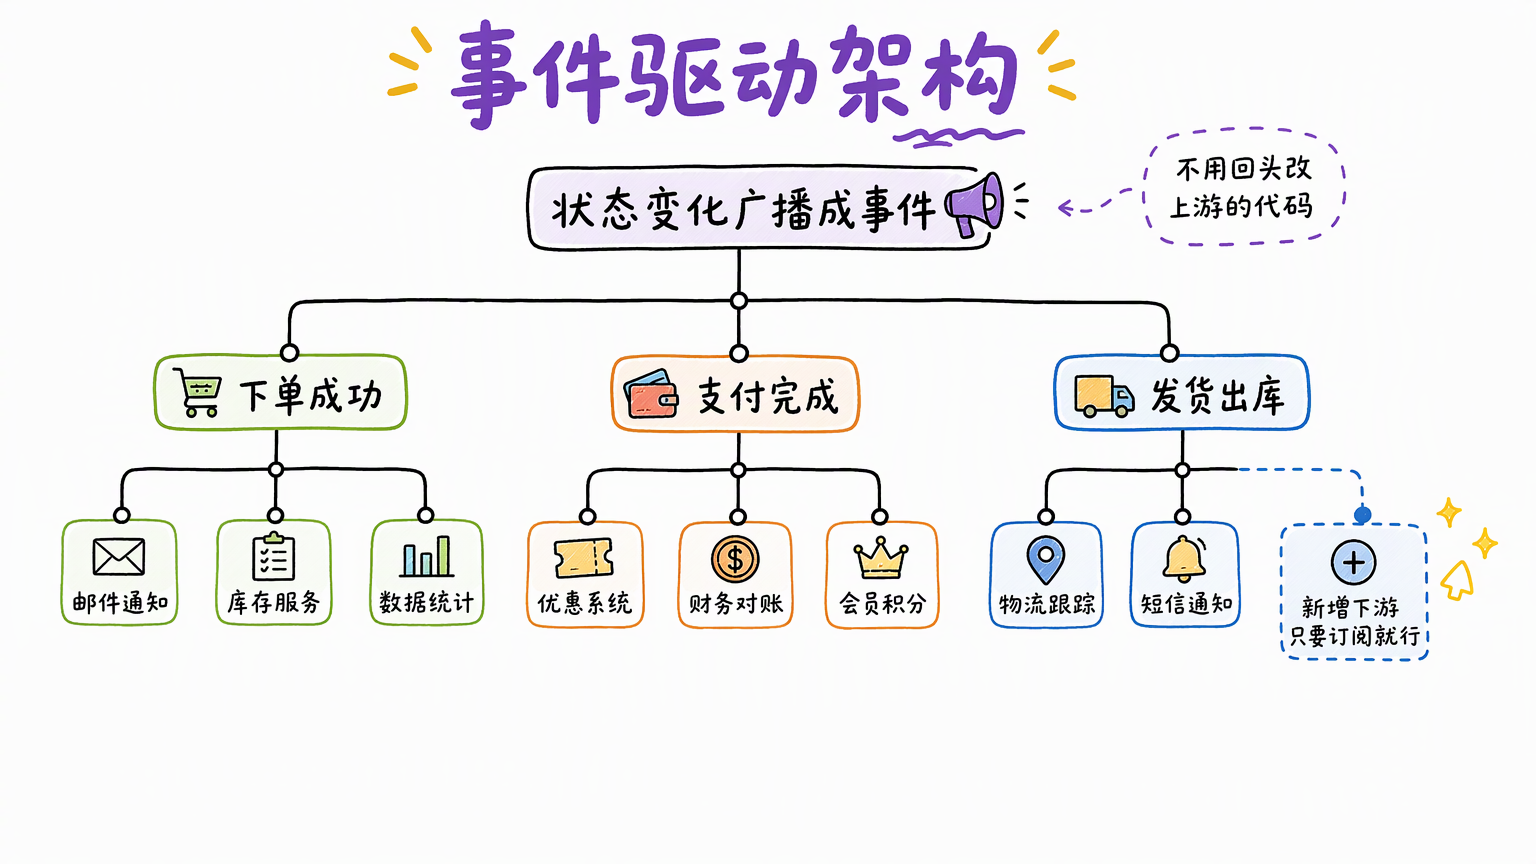
系统状态的变化不再靠互相调用,而是广播成事件。下单成功、支付完成、发货出库,每一个都是一个事件,新增下游只要订阅就行,不用回头改上游的代码。
10. 数据回放与跨机房复制
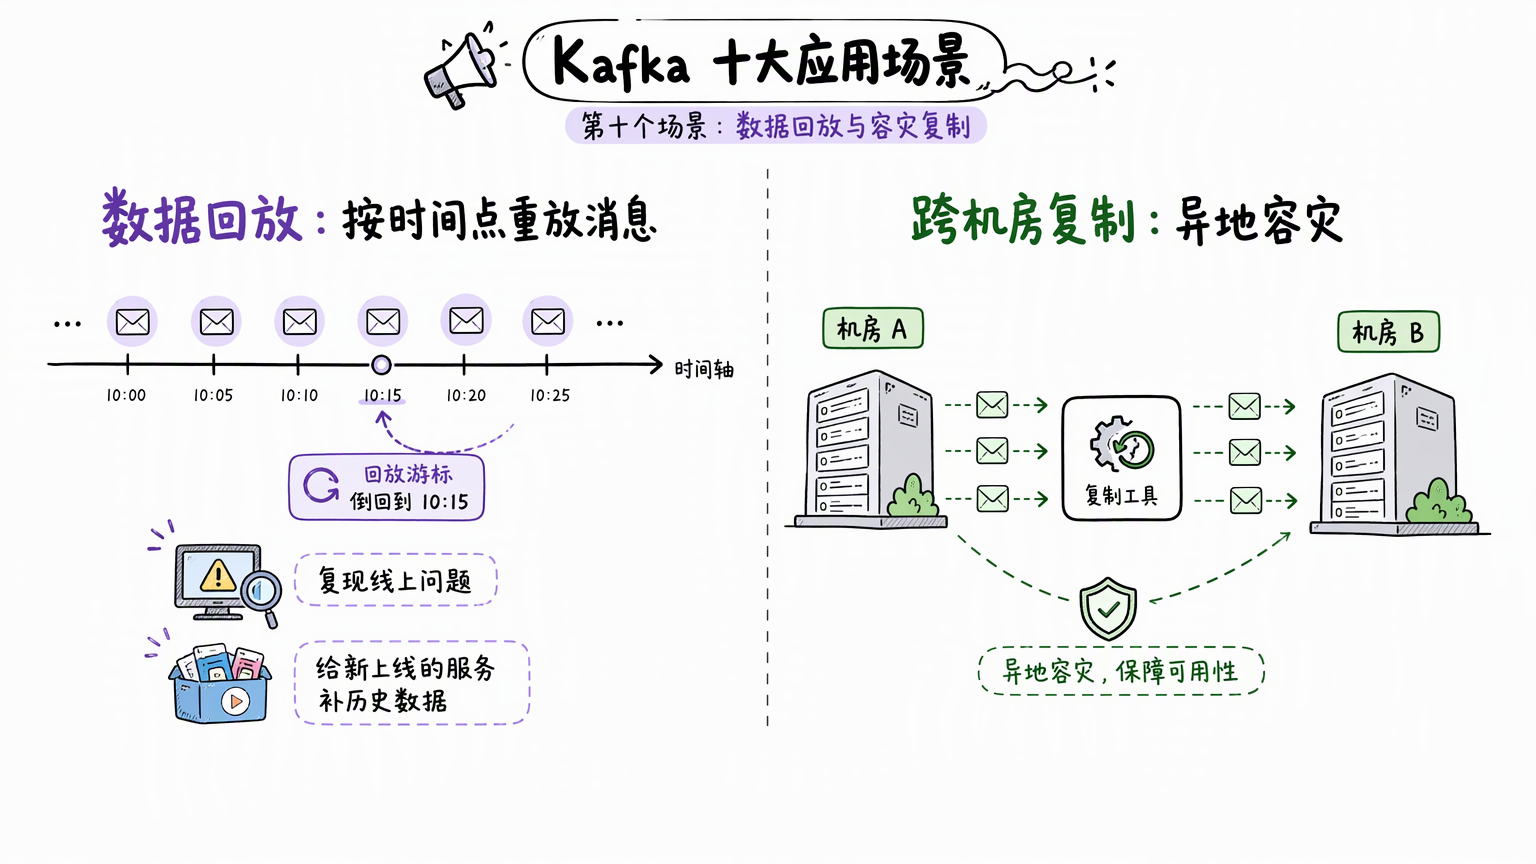
消息读完不会消失,可以按时间点重放,用来复现线上问题,也能给新上线的服务补历史数据。复制工具还能把数据同步到另一个机房,做异地容灾。
三个问题:判断需求适不适合 Kafka
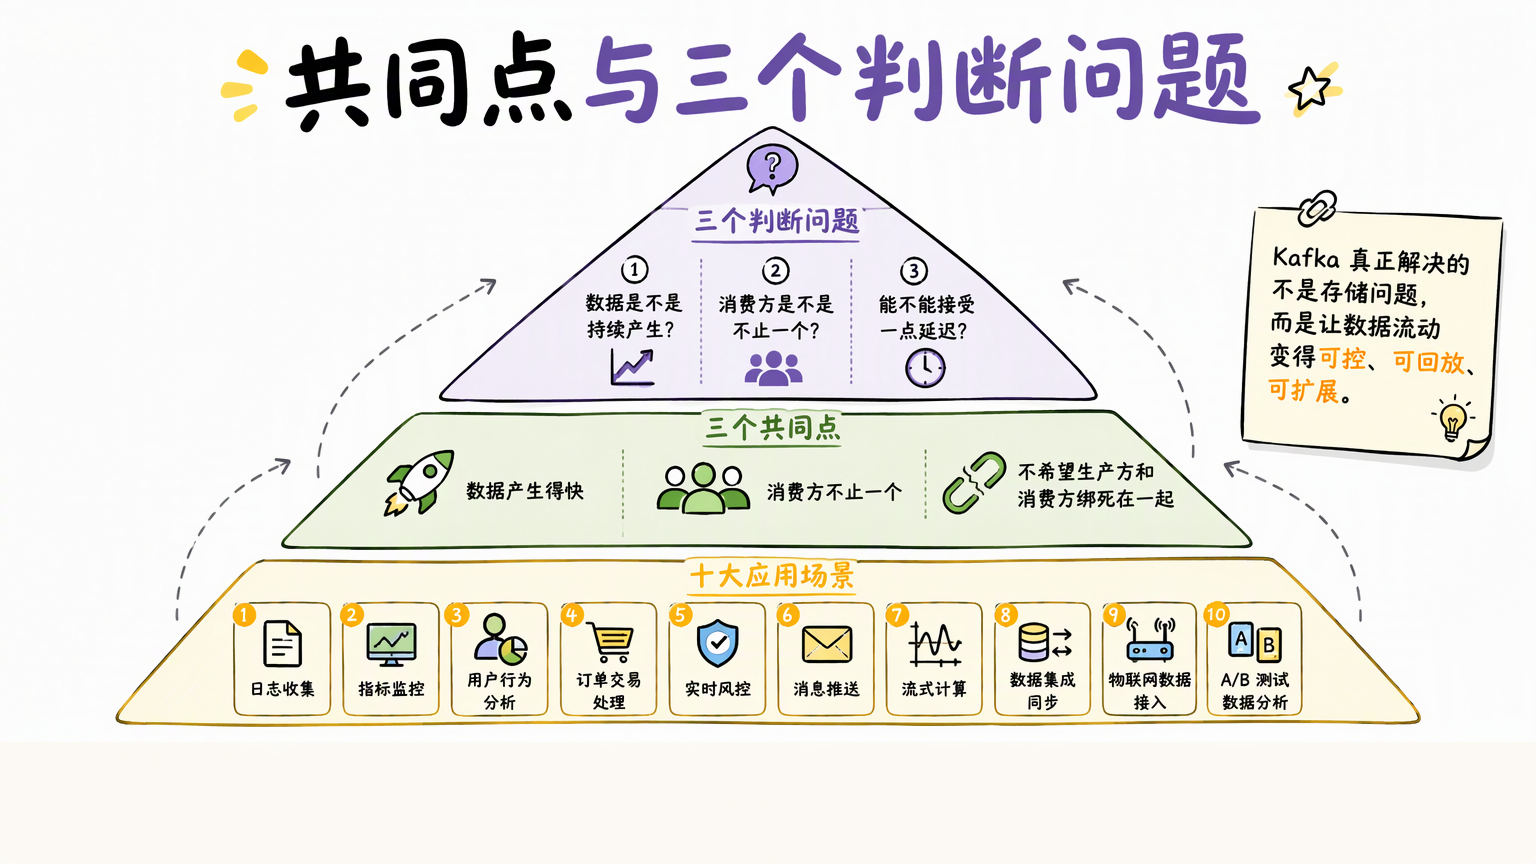
十个场景摆在一起,共同点很一致:数据产生得快,消费方不止一个,而且不希望生产方和消费方绑死在一起。Kafka 真正解决的不是存储问题,而是让数据流动变得可控、可回放、可扩展。
要判断一个需求适不适合用 Kafka,问三个问题就够了:
- 数据是不是持续产生
- 消费方是不是不止一个
- 能不能接受一点延迟
限制与常见误区
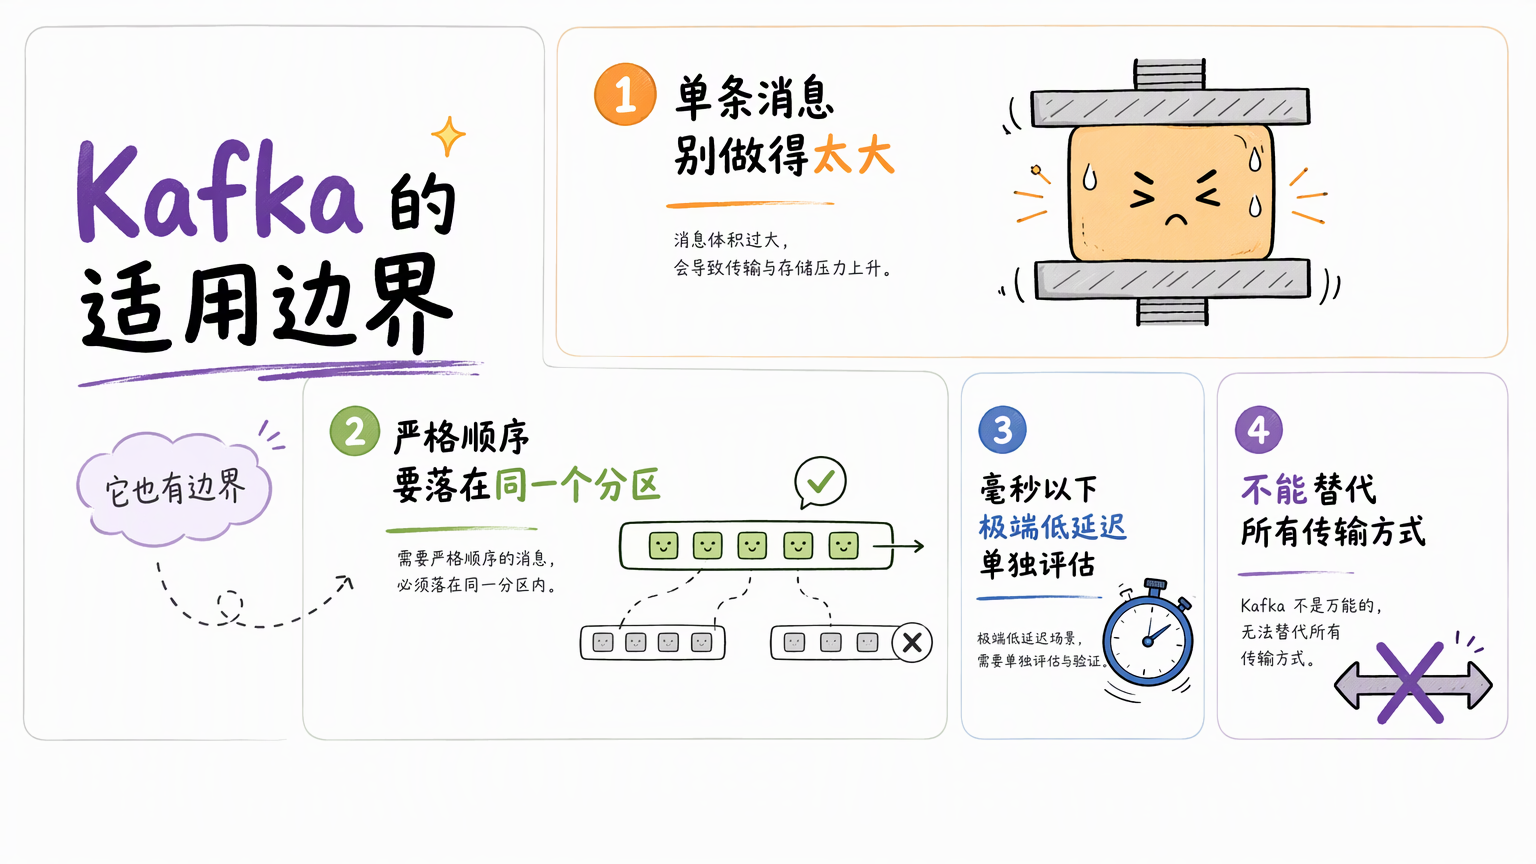
Kafka 也有清晰的边界,下面几类情况不能指望它包打天下:
- 单条消息别做得太大
- 需要严格顺序的消息要落在同一个分区
- 毫秒以下的极端低延迟场景得单独评估
- 不能指望它替代所有传输方式
常见问题
Kafka 和传统消息队列最大的差别是什么?
普通队列经常是消费完就删,一条消息只服务一个下游。Kafka 会把消息保留一段时间,所以它既能当消息中间件,也能当数据管道。
消息被读过之后还在吗?
在。消息被追加到分区、落到磁盘保存,读过也不会马上删除,所以可以按时间点重放,用来复现线上问题,也能给新上线的服务补历史数据。
下游处理失败了怎么办?
消息还在,重试就行。失败的任务不必重新走一遍上游。
生产者和消费者需要互相知道对方吗?
不需要。生产者只管写进某个主题,消费者只管从主题里读,双方互不认识,新增下游只要订阅就行。
什么样的需求适合用 Kafka?
问三个问题就够了:数据是不是持续产生,消费方是不是不止一个,能不能接受一点延迟。
Kafka 能替代所有传输方式吗?
不能。单条消息别做得太大,需要严格顺序的消息要落在同一个分区,毫秒以下的极端低延迟场景得单独评估。
总结
十个场景的共同点很一致:数据产生得快,消费方不止一个,而且不希望生产方和消费方绑死在一起。Kafka 真正解决的不是存储问题,而是让数据流动变得可控、可回放、可扩展。
落到使用上,先确认需求落在这三条判断标准里,再注意消息体积、分区顺序和极端低延迟这几处边界,Kafka 才是一个合适的选择。